

Building free investtracker | One dashboard for your global net worth & investments | No more investment Excels. Just data. 📉
Poland
Joined December 2021
- Tweets1.2K
- Following1.7K
- Followers309
- Likes1.3K


Daniel retweeted

my spidey senses are telling me the labs are, as we speak, using unguardrailed versions of their unreleased models to systematically reverse-engineer ALL of the internet’s software, apps, and games, then feeding the reconstructed source code straight into their training pipelines while simultaneously building guardrails to ladder-pull the rest of us
Daniel retweeted

Introducing Personal Finance in Claude, in beta in the US.
Connect the accounts you choose, and Claude answers your money questions in everyday language, from your own balances and transactions. Access is read-only, and Claude can't move, manage, or invest your money.
Daniel retweeted
We need to reconsider our priors on code readability.
Humans, compared to agents, are pretty slow at understanding large quantities of text. So in the old days, readability was important so the human could efficiently grok what was going on.
So readability now comes down to:
1. Can a human, if needed, jump in and understand the code
2. Does the code use the same domain language as the human describing the code?
1 helps with observability and the occasional spot checks you need to do on important PR's. 2 helps the agent translate the words you use into code changes.
In other words, readability is now a nicety, not a necessity.
The way agents 'read' code is different - good agents are all about gathering data about how the code works. They'll prod around with it, execute parts of it.
So 'readability' to agents really means 'verifiability'. How easy it is to mess about with that code to see it working.
Let's take this scenario:
- You have a huge module in your codebase that uses all sorts of complex performance tricks
- It has 100% test coverage
A talented human would need an hour or two to get comfortable working in that module.
An agent needs zero time. They verify it with the tests, poke about a bit, and they're good to go.
The takeaways:
- When judging a module (or a codebase), don't think about how easy the code is to read
- Instead, think about how easy it is to verify
- Design your codebase so modules can be tested and verified independently
- Feel free to sacrifice a bit of readability for performance
- Cyclomatic complexity and function size don't matter to agents


Daniel retweeted
mały rant na temat modelu mentalnego wdrażania ai pośród ludzi decyzyjnych w dużych firmach - zainspirowany poniższym postem
niestety choroba chwalenia się ilością przepalonych tokenów, a tym samym przepalonej kasy, rozpowszechnia się bardzo szybko. nawet wśród ludzi, u których podejrzewałbym trochę więcej rozgarnięcia biznesowego (c-levels) z którymi mam do czynienia
ale czego można się spodziewać, skoro dla kogoś decyzyjnego w firmie, w której pracują setki albo nawet tysiące ludzi, metryką sukcesu jest liczba wydanych licencji na jakiegoś sidekicka pokroju claude code, albo to że nagle każdy buduje swoje rozwiązania w kompletnym odłączeniu od innych
stąd umiejętność przeprowadzenia gruntownej transformacji procesów pod nowe możliwości, jakie daje ai, jest ważniejsza niż samo „ogarnianie” claude code czy gpt
próba zautomatyzowania procesów w takiej formie, w jakiej istnieją obecnie, zawsze kończy się niepowodzeniem i nieosiągnięciem pełnego potencjału, a co za tym idzie, maksymalnego ROI
transformacja ai jest cholernie trudna i mozolna, ale gdy się przy tym wytrwa i zrobi się to porządnie, ROI jest niesamowite. i to dla każdego pracującego w danej firmie, a nie tylko dla tych, którzy mają największy kawałek tortu
a jeżeli ktoś uważa że dobrym rozwiązaniem po takiej transformacji jest zwalnianie ludzi, to w mojej ocenie jest debilem i nie rozumie kompletnie jak bardzo wartościowi są eksperci domenowi, w CAŁYM procesie tej transformacji. ludzie też są i nadal będą jednym z lewarów skalowania biznesu
„zautomatyzowanie czy też wdrożenie ai w gówniane procesy powoduje tylko to, że gówno płynie szybciej”


Daniel retweeted
czego nauczyłem się wdrażając ai do firm
nie da się sensownie tego przeprowadzić jako jakiś byt w izolacji. mam na myśli to, że ai musi mieć wgląd w kilka działów naraz, bo realne procesy naturalnie tak przebiegają. przykładem są same przekazania między działami, które marnują dużo czasu
nie radzę ufać ludziom, którzy „specjalizują się” w transformacji ai w konkretnym departamencie, dlatego że nie ma czegoś takiego jak „departamentowy agent" np. agent działający TYLKO w dziale finansów
nie radzę tym samym zamykać czy też izolować ai w jakiejś konkretnej roli albo departamencie. ograniczenie agenta do tylko jednego konkretnego zadania jest marnowaniem jego potencjału. nie widzę żadnych przesłanek, żeby ograniczać ai tak, jak ograniczamy ludzi
my jako ludzie mamy po prostu takie przyzwyczajenie, że nadajemy sobie konkretne role w konkretnych działach ze względu na nasze limity umiejętności. nie jesteśmy tak wszechstronni i elastyczni jak ai. czemu więc zasady, które egzekwujemy wobec nas, mają być dla ai najlepszymi praktykami?
jeżeli ktoś chce wdrożyć ai w finansach swojej albo czyjejś firmy, to nie może ograniczać się tylko do procesów typowo finansowych, takich jak AP czy AR. powinien też rozciągać możliwości ai horyzontalnie, obejmując konkretne części innych działów, które bezpośrednio łączą się z danym procesem finansowym, np. dział operacji, sprzedaży albo HR
nie ma w firmach człowieka od tych wszystkich działów. nie ma żadnego kleju, który naturalnie je łączy. stąd właśnie duża szansa dla ai. wasi agenci muszą mieć możliwości pracy między różnymi działami, bo po prostu są do tego zdolni i mają takie umiejętności, w przeciwieństwie do nas
dlatego też, gdy jesteśmy na samym początku wdrażania ai, zawsze polecam startować od działu, ALE mapować cały proces wraz z innymi etapami, które działają przed nim i po nim:
- przed danym procesem (upstream), np. zakupy i przyjęcie towaru wpływają na zobowiązania wobec dostawców
- po danym procesie (downstream), np. obsługa wyjątków opóźnia lub blokuje zamknięcie miesiąca
nie startujemy od pojedynczego workflow ani od całej firmy. wybieramy dział na podstawie jego metryk, takich jak:
- ilość wykonywanej pracy
- koszt
- zasięg (ile innych działów dotyka)
kolejny raz przypomnę, transformacja ai to:
1. przeprojektowanie istniejących procesów pod nowe możliwości, tak by usunąć zbędne kroki
2. rozdzielenie pracy na deterministyczny kod, agentów ai oraz ludzi
3. danie ludziom możliwości kontroli nad całym systemem
4. ścisła współpraca na każdym etapie transformacji (projektowaniu, budowy i ewaluacji) z ekspertami domenowymi
5. wdrażanie ai w istniejących narzędziach firmy i pomiędzy nimi (jak najbardziej w tle), tak żeby nie wprowadzać kolejnych systemów/interfejsów, ani nie zmuszać ludzi do migracji danych i nowych szkoleń
6. świadome przekraczanie granic działów wewnątrz firmy, bo to tam jest masa wartości do zagospodarowania

Daniel retweeted

Great line from the CTO of Proton. I’m paraphrasing and stealing it :
Your job is not to use agents to help you write code. Your job is to lead the agents to help them write code.
Daniel retweeted

😂

Ten million people have watched a comedian accidentally destroy the entire TED talk industry.
He filmed the talk once at TEDxNewYork in 2014 and openly admitted he had nothing to say.
Speaking coaches charge $5,000 to teach the exact tricks he used in 6 minutes to say nothing at all.
His name is Will Stephen. He is a comedian from Late Night with Seth Meyers who was invited to give a real TED talk and used it to prove the format is a costume anyone can wear.
Every TED speaker opens with a question, tells a personal story, cites a scientist, and shows a chart. Stephen did all four in six minutes with zero content.
His entire formula fits on a napkin.
Gesture with both hands. Ask the audience a question anyone can answer. Tell a mildly embarrassing story so they say aww. Point to a stranger on a slide and call them important. Flash a chart of random numbers. Wear glasses with no lenses. The audience will think you are brilliant.
That last trick alone has probably cost the public speaking coaching industry a hundred million dollars in sessions clients should have skipped.
"If you watched me on YouTube with the sound off, you would think I was a genius."
That is Will Stephen on the TED stage, three minutes into the talk he was paid to give. He wasn't lying.
Executives pay $15,000 for a keynote coach and still open with a joke the room never laughs at. Founders rehearse their pitch for weeks and still sound like Stephen at minute four, saying "wagga wah, gabba gabba" with authority.
The talk is free on YouTube. The method is written across every TED speaker's playbook for ten years.
Stephen still writes for Seth Meyers. Almost none of the ten million viewers have stopped nodding at empty slides since.
The formula is free. The willingness to actually say something before your next keynote, pitch, or townhall is the entire edge.
Daniel retweeted
polecam lekturę
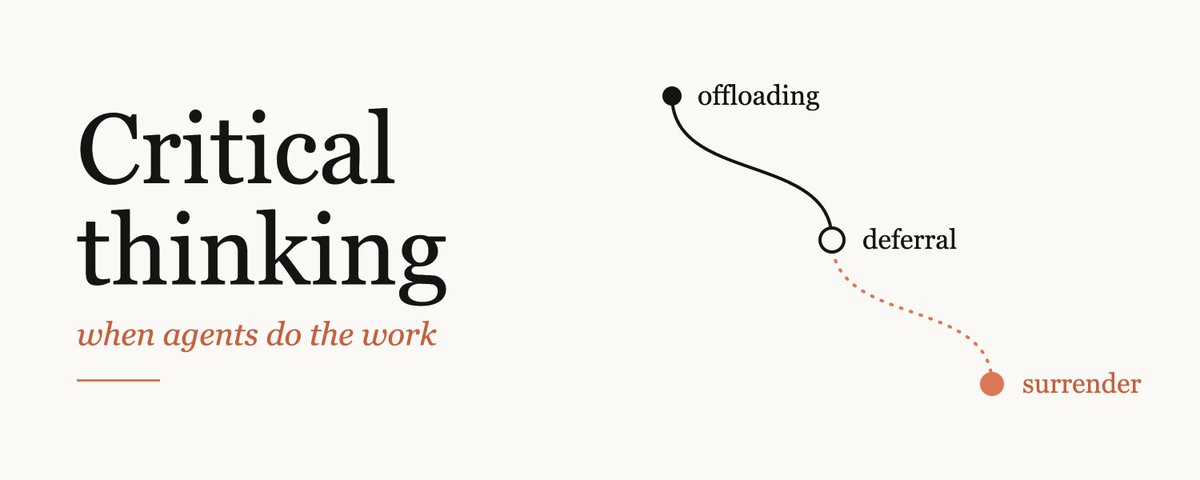
w kontekście sporu o to, czy czytać kod ai, nie chodzi o to, czy go czytać, tylko kiedy to robić, a przede wszystkim jak lepiej zrozumieć to, co budujemy
code review, tak jak opisuje to Addy, powinno mieć kilka poziomów. każdy z nich wyłapuje co innego i przepuszcza to, co wyłapie dopiero następny poziom
ale Addy wspomina też o fundamentalnej rzeczy, jaką jest zrozumienie tego, co w ogóle budujemy (a bardziej tego, co buduje dla nas ai) i czy warto to budować. dlatego tak ważne jest tworzenie narzędzi, które wspierają utrzymanie wspólnego rozumienia między człowiekiem a ai
przykładem są dopracowane graficzne explainery, o których też mowa w artykule. niektórzy idą dalej tworząc krótkie filmiki, których zadaniem było właśnie bycie takim explainerem zagadnienia X
już pare miesięcy temu (w świecie ai lata temu) pisałem o tym, jak zwiększyć poziom zrozumienia tego, co budujemy z ai, w o wiele przyjemniejszy sposób niż przez czytanie diffów:
teapawt.net/MAXIMISEART/status/207…
nie idźcie na skróty w procesie zrozumienia waszej pracy

Daniel retweeted

mnie generalnie razi to czepianie się w programowaniu "AI-slopu" i podkreślanie jakiejś wyższości ludzi jakby ludzki kod (nawet wśród profesjonalistów) nie był beznadziejnym "human-slopem", a jednak jest. Tyle gównianego kodu co się naoglądałem przez 20 lat swojej pracy wyprodukowanego przez ludzi to żadne AI nigdy nie wysrało. Popatrzmy chociaż na ostatnią wtopę z PHP, gdzie w 2004 r. wydano z błędami i z bugiem pozwalającym zhakować cały serwer, do gołej ziemi, bibliotekę w wersji 5.x, a potem dziedziczono ten sam błąd przez następne 22 lata (bo nikt z całego środowiska milionów programistów go nie zauważył), by dopiero teraz wyszedł i wszyscy musieli łatać serwery, cały świat, a rządy wręcz gasić całe serwisy by je łatać. No i co? Ktoś mówił o human slopie? Nie. Bug, poprawka, critical. On był i będzie, nieważne czy zrobiony za pomocą ludzi, czy za pomocą generatora kodu. Po prostu zły kod jest złym kodem, niezależnie, jakimi narzędziami powstał i to odróżnia np dobry zespół od złego, że potrafi zły kod wyłapać i naprostować zanim będzie bagno. Po co ten hejt na AI stricte? Czemu akurat jak AI generuje kod, to jakoś tak się próbuje to deprocjonować, a równocześnie ubóstwiać tych ludzi, którzy robią takie samo gówno, a nawet większe, czego dowodem jest właśnie ostatnia akcja z PHP, które pisali białkowi profesjonaliści?


Daniel retweeted
świetny gość, fajny wykład, dobrze spędzone 45 min
na temat jak działają proaktywni always on agenci np. grok bot
na pewno lepsze niz scrollowanie tiktoka czy innych reelsów
polecam

How do always-on, proactive agents like @Bot work?
Watch my lecture at Stanford CS146S:
2:35 How we got here
6:13 What changed in the models
10:06 Inside an always-on agent
18:07 The harness
27:26 Context engineering
34:26 Where this is going
Daniel retweeted

Trump ujawnił, że Google odmówił mu zmiany nazwy Oceanu Atlantyckiego na Ocean Trumpa.
Daniel retweeted

You can just copy this tweet and tell your primary Grok Bot to learn from this.
Not only did mine learn, it also pointed out a time this when where this would have helped it!
Lauren shared so much gold ✨


how do you trust your agents' work more? copy this post/link and give it to your @bot or agent!
1. codebase improvements: this is just good software engineering - better architecture, stronger types and invariants, clear boundaries. agents love to copy what exists and take the shortest path, so make the easy thing the right thing. categorically eliminate problems through code and you won't need to think about it again.
2. static analysis: lint rules, tests, CI, verification (eg TLA+). very token efficient ways to catch issues ahead of time.
3. prose: comments, rules, AGENTS.md, skills - anything that can't be enforced and requires agent judgment. use it minimally, but do use /create-verification-skill.
4. human review: the hardest to scale. at the rate agents land code, it's pretty much impossible to thoroughly review every PR, so spend that effort on the highest leverage point, designing an environment where agents do the right thing by default.
this forms an inverse pyramid: you want most of your effort at the top, least at the bottom. codebase improvements are deterministic, making it more token efficient, and lets you sleep more soundly at night.
install github.com/cursor/plugins/tr… and create a new Project:
1. look through my slack/chat messages and code review comments where i've given feedback on PRs, code, architecture
2. use /recall on my past transcripts to learn how i steer agents
3. /poteto-mode use /correct and /architect on past commits to find the most common pitfalls agents fall into, then propose a plan to rearchitect the code i own so it's more agent friendly. answer open questions with prototyping rather than defer to me, and back the plan with real data.
4. before you begin, use /sharpen + /in-your-own-words and confirm this prompt with me

Daniel retweeted

how do you trust your agents' work more? copy this post/link and give it to your @bot or agent!
1. codebase improvements: this is just good software engineering - better architecture, stronger types and invariants, clear boundaries. agents love to copy what exists and take the shortest path, so make the easy thing the right thing. categorically eliminate problems through code and you won't need to think about it again.
2. static analysis: lint rules, tests, CI, verification (eg TLA+). very token efficient ways to catch issues ahead of time.
3. prose: comments, rules, AGENTS.md, skills - anything that can't be enforced and requires agent judgment. use it minimally, but do use /create-verification-skill.
4. human review: the hardest to scale. at the rate agents land code, it's pretty much impossible to thoroughly review every PR, so spend that effort on the highest leverage point, designing an environment where agents do the right thing by default.
this forms an inverse pyramid: you want most of your effort at the top, least at the bottom. codebase improvements are deterministic, making it more token efficient, and lets you sleep more soundly at night.
install github.com/cursor/plugins/tr… and create a new Project:
1. look through my slack/chat messages and code review comments where i've given feedback on PRs, code, architecture
2. use /recall on my past transcripts to learn how i steer agents
3. /poteto-mode use /correct and /architect on past commits to find the most common pitfalls agents fall into, then propose a plan to rearchitect the code i own so it's more agent friendly. answer open questions with prototyping rather than defer to me, and back the plan with real data.
4. before you begin, use /sharpen + /in-your-own-words and confirm this prompt with me
Daniel retweeted

I got tired of all the spam calls I was getting so I had @bot find my number listed on sites and file the removals. I made it a free skill so you can do the same. x.ai/bot/fUj6TYhiW_cjtzWvbsF…
@SpaceXSI @elonmusk

Daniel retweeted

I'm beginning to witness the true power of @bot and @NotionHQ.
This is the "Mental Models" database.
It automatically creates bite-sized ideas connected through all my knowledge sources (X bookmarks, books, lectures, meeting notes, etc.)
Every morning, along with bookmarks I've saved, it emails me a mental model I can chew on for the day.
This database is like the swiss army knife of knowledge work and I don't even have to touch it.
More about each idea down below:


Daniel retweeted

how to use @bot for engineering and get a ton done:
1. create a (cursor) project for every big workstream. i have ten, such as a “mcp project” and a “bugs project”
2. make sure every project spins up cloud agents with /poteto-mode
3. in grok bot, make an eng bot whose sole job is routing requests to the right project.
4. now voice call (!) your primary bot and braindump all your tasks.
your tasks will automatically end up at the correct projects, and result in sweet prs :)
you get all the benefits of projects + pstack, but don’t have to think about anything!
Daniel retweeted

To nie fejk. To prawda. Tesla zaprezentowała wczoraj długo wyczekiwaną nową generację Tesli Roadster wyposażoną w tzw. pakiet SpaceX, która potrafi wykonać skoki i manewry w powietrzu. Zdaje się, jakby zakrzywiała grawitację. Wygląda, jak efekt specjalny rodem z Bonda wspierany AI. A to czysty, techniczny geniusz człowieka. Zobaczcie ten film.
W samochodzie zamiast tylnych siedzeń umieszczono zbiorniki wysokociśnieniowe (COPV) mieszczące setki litrów sprężonego powietrza. Komputer pokładowy błyskawicznie steruje elektronicznymi zaworami i elektrycznymi aktywatorami, które uwalniają gaz do odpowiednich dysz rozmieszczonych wokół nadwozia. Sprężone powietrze jest gwałtownie wypuszczane przez dysze z ogromną prędkością, generując potężną siłę reakcji (ciąg), która pozwala autu na chwilowe oderwanie się od ziemi, wykonanie "skoku", precyzyjną stabilizację w locie lub drastyczne skrócenie czasu przyspieszania na drodze.
Pojazd nie ma płatów nośnych (skrzydeł) generujących siłę aerodynamiczną w przód i górę jak w samolocie. Dysze zimnego gazu nie generują ciągłego strumienia powietrza skierowanego w dół (jak śmigła drona czy helikoptera), który utrzymywałby auto w powietrzu. Działają one impulsowo – służą do punktowych, ułamkowosekundowych manewrów (tzw. hops), a nie do ciągłego latania. Co więcej, pojazd posiada aktywne elementy aerodynamiczne (oraz systemy wentylatorów/skrzydeł), które przy zwykłej jeździe dociskają auto do asfaltu, zwiększając przyczepność, zamiast je unosić.
Dla mnie to jest piękne. Naukowcy SpaceX już pokazali, że są geniuszami precyzji. Potrafimy wysłać rakietę w kosmos, która z precyzją do kilku cm wróci na to samo miejsce, pokonując gigantyczne dystanse. Tyle wiemy o oddziaływaniach w fizyce i tak nauczyliśmy się je kontrolować. Tu mamy kolejny tego przykład.
W zespole Tesla pracującego nad Roadsterem jest trzech Polaków. Nasi stypendyści Bison Fellowship spotkają się z nimi. Gratuluję tym, którzy stworzyli takie cudo.
Film: Tesla