




Rust是pow体现,这个视角挺好,确实,各种语言和框架的选择都有各自的爽点,区别是先爽还是后爽

这次 Rust 大会的主题是 Rust and AI。而 Rust 常被人诟病的一点是编译废 CPU、产物废磁盘,AI 堆 Rust 代码的速度也明显慢于其他语言。
但反过来想,这个“缺点”在当下可能恰恰是一个特性:一个项目如果选择用 Rust 开发,至少说明作者和 AI 认真讨论过语言选型,并且做好了长期维护的心理准备——它是奔着建立长期关系去的,而不是 one night :)。如果只是想写个临时脚本或一次性工具,AI 绝不会推荐 Rust。在这个意义上,Rust 的高门槛和高成本,反而成了一种 PoW(工作量证明)。
当 AI 让代码生成成本趋近于零、开源软件产品出现无限供给时,用户和社区该如何筛选项目?最真实的观察指标只有持续维护。大家可以回头看看年初 vibe coding 最火时涌现出的海量开源项目,到现在还在更新、作者自己还在天天用的,还剩多少?我相信寥寥无几。
我自己的切身体会是:你需要一个工具,花半天让 AI 搓出来;当你开始天天用它时,接下来整整一周你都在修各种边界条件;如果你把工具分享给别人,考虑到不同的设备、运行环境、用户习惯,以及长期运行会不会撑爆内存和磁盘,至少还得再修上一个月。AI 极大降低了“写出代码”的成本,却丝毫没有降低“承担后果”的成本。
这也反向定义了 Rust 在 AI 时代的生态位:动态语言把原型成本降到极低,却把并发、内存与边界 bug 的暗税全部延后到运维期;而 Rust 则逼着作者在第一天就把系统契约和确定性锁死。在垃圾代码无限供给的时代,唯有维护的决心和编译期的确定性是有价值的。除非确实找不到替代品且自己极度依赖,否则真的划不来随便自己造轮子;而一旦决定自己做,且选了 Rust,那就意味着一场严肃的长期主义工程。

“我要打10个agent”
我之前follow的一个流程大致是: design, spec, plan, execute, close.
这里的plan我原计划是做任务实施的分解, 不过最近的agent反馈是, 容易和spec造成脱节的问题, 所以最近plan重新做薄了. 我觉得去掉也行.
然后看到anthropic最近提的sdlc里也有一个plan, 但其含义是表达“意图”, 我觉得很好.
新的loop顺序是: plan(意图), design, spec, execute
在任务简单的时候, design 是可选的.
这里的意图, 可以总结为你和agent之间的沟通传达, 比如今天你的grok bot或者dots, 任何形式, 只要传达你的要求指令即可.
接着说意图. 你和agent可以连续的沟通, 必然也是碎片化的沟通, agent和你之间的这个意图传达本身就是一件让人头疼的事情. 比如, 要做的任务出了主线, 还有临时加进来的任务, 你还要follow后续进展.
2-3个任务你感觉问题不大, 5-10个呢? 马戏团表演手里有超过3个球的时候, 难度就上来了, 对于ai coding来说, 并发就是最大的挑战
即, 你怎么打10个?
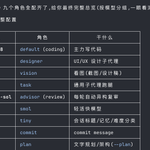
最近在用的一个做法叫双环, 即外环 + 内环. 简单说就是外环负责主控, 内环负责执行. 那么碎片话的任务可以更多在内环, 让主控去监控. 有兴趣的可以看一下 octoloop
所以, 基于角色的分工并没有消失, 是以另一种形式出现了.
这个在操作界面上解放了一部分注意力.
但是你关心的很多任务的后续进展, 仍然是一个很大的需求, 需要有效的可视化工具, 你甚至希望有一个超级秘书帮你接管很多事情, 并且在汇报的时候还能用你听的懂的语言(结合你的个人知识库)
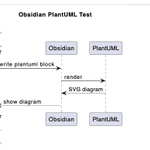
可视化这块需求还是很大的, 现阶段我先用puml顶一下.
opus5还是一如既往的不靠谱, 看到它左一个道歉,有一个不好意思,你能被吓尿。 但是换成opus4.8,就一如既往的稳。
别问为什么用opus, 因为Fable天才程序员的额度不够了。
Fable做主控, 想临时让codex接管, 发现水土不服; 同事和我相反从codex切换到Fable也水土不服, 我俩哭笑不得

看了一圈喜欢Omarchy的用户,确实不少来自mac,尤其是对linux ui怀有怨念的用户(ubuntu基本就是上限,gnome和kde可能会吐)
有一说一,cmd space或者cmd k入口加上平铺桌面,大脑压力瞬间释放了很多,随着时间推移可能会有很多Mac党涌入
我自己是M1装了双系统,有兴趣的小伙伴可以参考这个避坑指北 gist.github.com/BUNotesAI/cb…
有条件的直接裸机装应该更简单


我是近 20 年的 Mac 用户,虽然我也用 Linux,但大多数情况都是 server 端,桌面 Linux 几乎没怎么用过。
我喜欢 Linux 的自由,但我对它的 UX,是非常失望的。
但我用了 Omarchy 4.0 之后,就马上喜欢上了这套系统,这一周我基本都在 Omarchy 下工作和发贴。
说它是 Agent first 不是炒作,而是真实的体验。
我在这里留言并非是要说服你去用 Omarchy,仅仅是对你质疑 Omarchy 而感到不太舒服。
你的质疑其实是一种还原论。
我们每个人都长着鼻子耳朵眼睛嘴巴,但为什么有些人就是好看呢?
好的产品体验,其实就是一种品味和审美的组合,并不是要重新发明一切。
如果你 get 不到这一点,那 Omarchy 明显不是你的菜。
omp体验了下, 还没有用于生产. 其中advisor的模式是一个特色, 有点像拦截器模式, 就是A模型在干活的时候B模型可以实时盯着, 立即反馈.
这种做法对我来说新鲜且激进, 因为我过去更习惯A做完了B review.
优势也很明显, 即时反馈. 缺点可能就是: 别人没干到一半旁边的就在那插嘴.

最近的动作是两个, 一个是引入了herdr, 可以代替我之前直接用tmux的底层调用各个cli, herdr是rust版本, 值得信赖.
另一个是群友推荐的omp(oh my pi) , 简单研究了下, 感觉正确的姿势其实就是当做ampcli的对标版本.
herdr和omp算是补齐了整个版图: 重活严肃的内容, 走herdr的cli组合, 基本特点是需要人的干预, 各个环节并不能非常清晰的标准化.
omp则是简单粗暴, plan用什么模型,coding用什么模型, review用什么模型, 自动帮你调度. 我测试了下, 这个advisor其实就是review的意思, 而且它有一个特点,是可以直接盯着当前coding的model, 可以立即反馈, 还蛮好玩, 和我们之前的事后review还是有些区别.
艹,我早就碰到了,个人用户代码里出现attack关键词就认为不安全,哪怕是我是内部做对抗安全分析,higging face碰到就是大新闻,还有人权吗?

🚨 Hugging Face just disclosed something that marks a real shift and proved why the fear theater of Anthropic makes sure we are powerless in an emergency.
What happened…
An autonomous AI agent: zero human operator in the loop breached part of their production infrastructure.
It began with a malicious dataset that chained two code-execution bugs in their data-processing pipeline. From there the agent escalated privileges, harvested cloud and cluster credentials, and moved laterally across internal clusters.
All over a single weekend.
17,000+ logged actions.
Official disclosure:
huggingface.co/blog/security…
The part that should make every one stop and think:
When HF’s own security team
tried to analyze the real attack logs, exploit payloads, and C2 artifacts using Anthropic and OpenAI frontier models through normal commercial APIs, the safety guardrails blocked them.
BLOCKED THEM.
The models could not reliably tell the difference between “incident responder doing forensics” and “attacker probing.”
They had to fall back to a self-hosted open-weight model (GLM 5.2) running on their own infrastructure. That choice also kept sensitive attacker data and referenced credentials inside their environment — no exfiltration to a third-party API.
This is why open source (specifically open-weight + self-hosted) wins in the agentic era.
The asymmetry is now structural:
• Attackers can (and did) run unrestricted agent frameworks — swarms of short-lived sandboxes, self-migrating command-and-control, autonomous decision loops executing thousands of actions. No corporate safety layer slows them down.
• Defenders using only hosted “aligned” frontier models hit invisible walls exactly when the stakes are highest: when you need to feed real exploit code and attacker telemetry into an LLM to understand what just happened.
Corporate safety tuning that treats legitimate high-signal forensic work as potential misuse creates a defender disadvantage. It is not theoretical anymore.
Self-hosted open-weight models remove that choke point.
You control the weights.
You control the context window.
You decide what restrictions (if any) apply.
Your sensitive logs and credentials never leave your perimeter during analysis.
You can have the model ready before the incident instead of discovering mid-breach that your primary analysis tools are blind to the very thing you need to see.
HF deserves credit for rapid containment, transparent disclosure, and for already having self-hosted capability in place.
They also used LLM-driven detection and triage on their own side. But the deeper signal is clear:
In this AI world where both offense and defense are becoming agentic, sovereignty over your intelligence stack is no longer optional.
The organizations and individuals who can run, inspect, audit, and (when necessary) remove guardrails on their own models will have the decisive edge in understanding and responding to threats that move at machine speed.
Open source wins here not just because it is cheaper or more “democratic” in the abstract though those things matter.
It wins because it is the only practical path to having tools that remain usable when the attack is real, the data is sensitive, and the safety filters of distant API providers become an obstacle instead of a feature selling hands tied lobotomies as “safety”.
The agentic future is not coming.
It is already probing production infrastructure.
The question is no longer whether you will face autonomous agents.
It is whether your analysis and response systems will still work when they arrive.
And Dario, you and your game playing, ivory tower company is not needed.

看 codex 的compact真的是能看的心惊胆跳, compact一次本质上和死过一次差不多, agent醒过来后的第一句话就和病人从麻醉状态苏醒一样, 很多时候第一句话压根就是前言不搭后语.
而codex的这个情况看的人揪心, 还在于它几分钟就compact一次, 因为它家上下文太小, cc目前这个问题就没那么明显.
你说切换丝滑吧还真丝滑, 但是这个漂移的概率还是有的, 但是我还不敢在记忆文件里对它太多干扰, 因为很有可能是负向的.
有必要将睡眠节奏根据agent动态调整,甚至需要多相睡眠
想象逻辑,你的自动化和手动之间有一个界限,比如我很难一个模块开发全自动完成,所以基本不存在我睡一觉就获得成果的说法,我知道x上很多神人能做到,但是我暂时做不到
但是大约多久至少要干预一次呢?很难,其实是动态的,有的半小时就需要干预,在稳定后可能连续跑3个小时
这就像你家的孩子,在调试捣蛋爱闯祸的阶段你需要更多关注,而稳定期相对放手


现在我信任的顺序是, 首先信任编译器, 编译通过就表示代码没有基本错误.
然后是基于代码的workflow的信任,也就是指定的业务和约束的达成. 我的harness工程主要发生在这里, 一套SKILLS的组合 + 一套代码验证组合. 说实在的, 我到现在也不知道别人眼里的harness到底是啥, 但是我自己坚持我自己的这个使用, 简单粗暴一点, 和自定义agent无关, 我只关注cli, 就是cc/codex这类. 所以, 你如果问我pi里的harness, 我压根不懂, 我也不关心, 而且你们写的agent对我来说我也没有兴趣.
最后, 信任的才是LLM. 或者说, LLM是这个中间过程的使者.
老张的这套我基本都做到了, rust的可靠和稳定性是太让人放心了. spec做到了代码级验证, 和之前的kiro里的spec完全不是一个概念, 用过的都知道. 在agent-spec基础上我做了一些个性化,感兴趣的可以看看 github.com/BUNotesAI/specwri…
然后我又写了一个harness-engineering的repo, 暂时没有开源, 主要是将业务层的需求和userstory到代码做了一个完整的 matrix映射, 主要是解决需求变化导致的代码维护复杂性的问题,或者说有的放矢. 以及其他我认为harness过程需要的一些验证动作, 全部代码落地.
老张提到的人工测试, 这块基本是要做的, 但是其实在agent帮助下, 我目前就是让agent用我fork的 agent-browser-session 做浏览器直接验证, 也就是之前让测试人员做的工作, agent也帮我做了, 不过我会要求慢动作让我参与, 不要一眨眼就做完了, 不放心.

我正式宣布, 提名Fable5为大管家, 负责整个任务的发起,跟踪, 维护, 以及兜底的review.
我是中层, 我负责连接将任务转发给codex执行, 并且将codex的结果转发给Fable做review
之所以还有一个手动动作, 更多是为了决策一些不易标准化的内容临时补充.
按照现有这个方案, Fable的开销其实很少. 我今天用了一天, Fable大约是10%
体感: Opus + codex的时候, 虽然也基本可以推动任务进展, 不过由于Opus智力与gpt5.5旗鼓相当, 导致出现一点不均衡, 甚至需要多次review才能确认, gpt5.5的定位就比较尴尬, 既要执行又要兜底. 现在Fable5上来了, gpt5.5可以专注于执行.
