

建築修士→未経験SES→DS→SIer→メガベンDE💻🏆GCP6冠 「DSの猛者と戦わず、DEでポジションを取る」 ハードモードから這い上がった転職実録を発信 SQL / AI×エンジニアのリアル / メガベン転職攻略
Joined August 2019
- Tweets3.3K
- Following923
- Followers4K
- Likes18.1K



Pinned Tweet
フォロワーが4000人を超えたので、改めて自己紹介させてください!
TsK|データエンジニア
偏差値50の大学で建築を学び、未経験からIT業界へ。7年・4社、給与を一度も下げずにメガベンチャーまでステップアップしてきました。
【経歴】
① SES:SQL・Tableauで基礎固め(年収280万・通勤3時間)
② ベンチャー:Python/AWS(DSの猛者には勝てないと悟る)
③ 専門SIer:GCP基盤移行/生成AI(DEへ軸をずらす)
④ メガベン:データエンジニア(年収は2年で280万→530万)
SQL・データ職・キャリア戦略を発信しています!
最近仕事が忙しく、全然投稿できてませんでした。
メガベン転職して5ヶ月経ったので、ここまでの学びをざっくりまとめる。
個人的に思うのは、できるだけ早い段階で事業会社やメガベンで経験を積んだ方がいいのでは?ということ
理由は事業規模の大きさで、扱うデータ量も影響範囲も全然違うので、同じ「SQLを書く」でも考えることが変わってくる。この感覚は、規模の大きい環境に入らないと身につかない気がしている。
あと意外だったのが、業務のドメイン知識、というか暗黙知の量がかなり多いこと。ドキュメントに残っていない前提や経緯が大量にあり、その理解にかなり時間がかかる。
自分は7年かかってここまで来たけど、もっと早く動いてもよかったなと思ってる。
自分の場合、転職でポートフォリオを用意したことは一度もないです。
個人的には、ポートフォリオは「今の職場の経験だけでは補えない何かがある時」に作るものかなと思っていて、まず書類選考を受けてみて、通らなければ「何か足りない」と分かるので、そこで初めて用意すれば十分だと思います。
というか、実際は技術試験があることも多いので、ポートフォリオがなくてもそこで実力を見てもらえるケースが多い印象です。
あと、おっしゃる通り、課題解決のない「作りました」だけのポートフォリオは、むしろない方がマシまであるなと思います。

自社開発企業を目指している方に伝えたいことがあります。「単にポートフォリオを用意しましょう」という時代は、もう終わりつつあります。
AIを使えば、個人レベルのものは作れてしまう時代です。採用する側の興味は、もはや「作れたかどうか」にはありません。
では何をするのか。
自分や世の中が抱える課題に対して、ソフトウェアエンジニアリングでどう解決したのか、ということです。その結果がポートフォリオなのであれば問題ありません。
なぜこれが大事なのかというと、実際の仕事のシミュレーションになるからです。
仕事では、「こういう課題がある」「この業務をもっと効率化したい」「この体験を改善したい」といった課題に対して、技術を使って解決することが求められます。
相手は、あなたが何を考え、どのように課題へ取り組んだのかを聞く中で、それが自社でも再現できるかを見極めています。
一方で、「ポートフォリオを通して○○を学習しました」というスタンスだけでは、採用する側との見ている方向が少しずれてしまいます。新卒レベルであればまぁ大目に見て採用される事もあるでしょうが、甘めに見られた結果であることを認識しましょう。
またAIが作れるなら技術力はいらないのかというとそうではなく、そのエピソードの中で必ず技術的な深掘りが入ります。そこで自分の意思決定や設計、AIの活用方法について答えられるように準備しておきましょう。
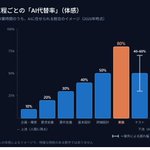
開発工程ごとの「AIにどれくらい任せられるか」を、自分の体感で図にしてみた。
見ての通り、実装が一番AIに侵食されていて、上流(要件定義や設計)に行くほど人間の仕事が残る。テストや運用保守は、案件によってかなり幅がある印象。
あくまで今の体感だけど、みなさんの感覚も聞きたいです。

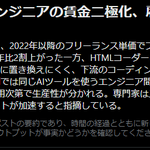
HTMLコーダーと上流(要件定義・PM)の比較なので一概には言えないけど、自分の前からしていた予想に近づいてる気がする。
最近よく聞くのが、人が足りてない現場でもあえて採用を絞って、その分AIにお金をかけて、一人あたりのスループットを上げているらしい。
確かに、AIは人雇うより安いので、会社側からするとその方が良いよなと
おそらくこのトレンドは始まったばかりでまだ続くと思う。なので、できるだけ早く上流工程(要件定義以上)の経験はしていた方が良いかなと
異論もぜひ

AIを使えるようになってから、地味に一番楽になったのはGitHubかもしれない。
コマンドが直感的じゃなくて、今まで仕組みをよく分からないまま何となく使ってた。
でもAIのおかげで、そのへんが全部楽になった。間違えても直し方を聞けばすぐ戻せるし、コンフリクトも解決してくれる上に、レビューのコメントの候補まで出してくれる。
苦手意識あったけど、今ではGitHubってかなり便利だな実感してる。
エンジニアなら必須とはいえ、ハードルはかなり下がった気がする。
最近、仕事がだんだん忙しくなってきて、できることも少しずつ増えてきてる。ただ、ずっとPCとにらめっこなので、正直ちょっと疲れ気味。
なので、今日は久しぶりにサーフィンしに来てる。海に入ると携帯も強制的に触れないし、頭もリセットされていい感じ。

エンジニアって技術力の勝負だと思って入る人が多いけど、これから転職で本当に問われるのは「何を作るかを決める力」なんだよなと最近思う。
実装そのもの(コードを書く作業)は、AIに一番代替されやすい。だから「実装はできます」だけだと、これからどんどん厳しくなる。
代わりに求められるのが、曖昧な依頼を整理して「何を作るか」を決めて、関係者をまとめていく力。
正直、自分も手を動かすのが好きでこの道を選んだのに、今一番求められるのがそこか…と複雑な気持ちになってる。
普段えらそうにキャリアのこと呟きまくってますが、そもそもの出発点は「働きたくない」でした。
できるだけ楽で時間効率がよくて、リモートも選べて、比較的早い段階で給与も上がりやすい。数十年働いたら早めにリタイアして適当に生きたい。
その手段として選んだのが、データ職・エンジニアでした。
だからみなさんも、そんなにハードル上げなくていいのでは?と思います。ちなみに今もリタイアを目指して働いてます。
リモートの有無は、その職種の需要で決まる「福利厚生」の一種なのでは?と最近思う。
需要が高いほどリモートを勝ち取れて、低いと出社を求められる。
つまり市場価値がないと、リモートという選択肢自体がそもそも持てなくなっていく気がする。これからは市場価値のある人だけの特権になるのかも

GMO、在宅勤務を完全廃止 コロナ禍以降続けてきた週1日の「推奨」も終了
itmedia.co.jp/news/articles/…

確かにトップ層に偏っているのかもですが、本当にメガベンの新卒のレベル高いんですよね…
しかも成長が早くて、入社して1年も経てば普通に中途と渡り合えるくらいに育ってる。自分が新卒の頃、何やってたんだ…と思わされます 笑
生成AIで採用も絞られてるせいもあるのか、年々レベルが上がってる気がしますね。

TsK|データエンジニア@メガベン retweeted

5年以上散々可読性低いSQLを修正してきたので、よく分かります。例えば、サブクエリがいくつも入れ子になって上へ下へ画面スクロールを繰り返することになるなら、with句で書き換えて上から下へスムーズに読めるようにしてほしい。

最近、SQLを書いていて痛感するのは、
「動くSQL」と「読めるSQL」はまったくの別物だということ。
ちゃんと動いても、命名や可読性が雑だと、レビューする人の負荷が一気に上がるし、後から「どこを直せばいいのか」が分からなくなる。
意識してるのはこのあたり。
・CTEは「1レコードの粒度」を意識して、何が1行なのかを明確にする
・分かりにくいロジックには「なぜやるのか」をコメントで残す
・カラム名は中身と一致させる(is_activeなのに0/1以外が入ってる、みたいなズレは負債になる)
その場限りの自分用ならいい。でも共通で使うSQLは、読みにくいと他人の時間を奪いかねない。
「動くSQL」は一瞬で作れるので、「読める形で残す」ところに価値が出てくる気がする。
TsK|データエンジニア@メガベン retweeted

自分も中途からだったのですが、正直新卒からより簡単だと思います。新卒の方は本分である学生生活とは別に、インターンとか業務委託で実務経験を求められ、CS基礎は全部押さえている前提で面接されるので、酷だなぁと思う。中途であれば実務経験前提ですが、ちゃんと市場価値の高い仕事をしていれば(逆に言えばそれだけで)評価されます。
今メガベンに新卒で入るような人って、めちゃくちゃ上澄みだなと思う。大学時代からちゃんと学習を積んで、アウトプットも出してきたタイプが多い。
自分はそのタイプじゃなかったけど、良い経験を積んで、メガベンみたいな会社に入ることができた。
「新卒で行けなかったら、もう二度と入れない」と思ってる人もいるけど、全然そんなことない。
むしろ、ある程度経験をしている、中途の方が欲しいというのも良く聞くし、諦める必要はないと思っている。
AIである程度コードが書けるようになったのはいいんだけど、SQLの正確性ってみんな気にしてるんだろうか。
よく見るのは、テキストで指示してSQLを出力させて、中身を確認せずに、出てきたデータをそのまま信頼してしまうケース。
これが広がると、部署ごとに定義が微妙に違うデータが量産されて、後から「どれが正しいんだっけ」が分からなくなる気がしている。
横断的にデータを統括する部門が主導してコントロールしないと、部署ごとにガラパゴス化したデータが出てくるんじゃないかと思ってる。
TsK|データエンジニア@メガベン retweeted

「増えた成果」は分かりやすいけど、「減った成果」は評価されにくいんですよね ^^;
データ待ち時間が減る、障害対応が減る、集計ミスが減る、二重管理が減る、DSや事業部の確認工数が減る、などなど。
DEの成果は、利益を直接作っていないように見えて、実際には他の人が利益を作れる状態を整えているわけですよ。
ただ、難しいのは、価値が反実仮想になりやすいこと。
この基盤がなかったら、どれだけ時間を失っていたか、
この設計がなかったら、どれだけ障害が起きていたか、とか。
そこを評価できない会社ほど、DEを失ってから価値に気づくのかもしれないな🤔
という感想ですー
ぼちぼち思ってたんだけど、データエンジニア(DE)みたいな職種って、社内評価で昇給するのって難しくないか?
データサイエンティスト(DS)は「施策で数値が◯%改善した」と成果を定量で語れるけど
一方、DEの場合、上手くいった場合は
「障害が起きなかった」「データが壊れなかった」という指標で測られるので、うまくいってても気づかれない。しかも目立つのは障害対応の時
このせいで、社内評価で給与が上がりにくい職種なのでは?
そのため、社内で不満を持ったDEから転職していく、みたいなことも起きてる気がする。
ここの評価制度はどうしているのか気になってる。会社によってはDEの入れ替わりが激しいとかありそう。