





又一个开源 Bot…
Pi Bot 正式开源!在自己电脑上养一支 AI Agent 团队 🤖
又一个值得关注的开源 Personal Agent 来了!
前几天刚上线的 Pi Bot,现在正式开放源代码,采用 Apache-2.0 协议。
它的定位很有意思:不是再造一个 AI 聊天工具,而是让你在自己的电脑上,组建一支真正能干活的 AI Agent 团队。
几个核心特点:
① 多 Bot 协作,像拉微信群一样简单
可以创建程序员、研究员、写作助手等不同角色的 Bot,每个 Bot 拥有独立的模型、记忆、Skills 和权限。
把它们拉进同一个群,统筹 Bot 负责拆解任务、分配工作,其他 Bot 分别执行,最后汇总交付。
② 能直接操作电脑,真正执行任务
支持读写文件、运行命令、浏览网页、操作浏览器,还能通过 MCP 和 Skills 扩展能力。
关键操作带有权限审批和审计记录,不是直接让 AI 在电脑上随便折腾。
③ 能接入现有的 Coding Agent
这点挺实用!据作者介绍,已经安装的 Codex、Claude Code、Cursor、OpenCode 等 Agent,也可以接进 Pi Bot 的协作流程。
不需要所有任务都绑定同一个模型或 Agent。
④ 本地优先,还能用手机远程指挥
目前支持 macOS、Windows、Linux 桌面端,以及 Android 客户端。
Bot 的对话、记忆和文件等默认存放在本机,支持在其他电脑上部署 Runner,手机端也能远程下发任务和处理审批。
当然,使用云端模型时,请求依然会发送给对应模型服务商,并不代表完全离线。
它还支持定时任务、文件夹变化触发、Ollama 本地模型和自定义 API。
我觉得 Pi Bot 最值得关注的,不是又多了一个 Agent 产品,而是它尝试把多 Agent 协作、电脑操作、权限管理和本地数据控制组合成普通用户也能使用的桌面应用。
目前项目还很早期,稳定性和安全边界需要更多实测,但方向确实值得关注。
GitHub:github.com/w01fb0ss/PiBot
官网:pibot.space
#开源AI #AIAgent #PiBot #PersonalAgent

39
Gemini 也有 Computer Use 了!终于可以让 AI 直接操作你的 Mac 😂
这回 Gemini 用户终于不用羡慕 Codex、Claude 了!
Google 正在为 Mac 版 Gemini 客户端带来 Computer Use 能力。简单说,就是不再局限于聊天和生成代码,而是可以让 AI 直接操作你电脑上的应用。
怎么用?
如果你使用 Mac,可以更新到最新版本的 Gemini 客户端,在设置中找到 Computer Use,开启相关权限,并选择希望 Gemini 操作的应用。
例如:
Chrome:打开网页、浏览信息、执行网页操作。
Excel:处理表格、整理数据。
CAD:辅助操作专业设计软件。
其他桌面应用:让 Gemini 根据任务需求进行界面交互。
这类能力和传统的 API 调用有明显区别。
以前 Agent 想操作一个软件,通常需要软件提供 API、MCP 或者专门的工具接口。
而 Computer Use 走的是另一条路线:让模型像人一样观察屏幕、理解界面,再通过鼠标和键盘执行操作。
这意味着,即使一个软件没有开放 API,只要界面能够被识别和操作,理论上也有机会接入 Agent 工作流。
我觉得这才是 Computer Use 真正有价值的地方。
未来的 AI 助手不应该只存在于聊天窗口里,而应该能够进入你的操作系统,跨应用完成任务。
当然,实际效果还要看复杂界面的识别能力、操作稳定性,以及权限和安全机制。
从 Chat Agent 到 Computer Agent,桌面端可能正在成为下一代 AI 助手的重要入口。
原帖:teapawt.net/Jerry_Galaxy/status/21…
#Gemini #ComputerUse #AI Agent #Google

这回爽了,Gemini用户终于有了属于自己的Computer Use,不用再羡慕Codex。
如果你是Mac,更新最新Gemini客户端,设置里开启Computer Use功能,添加你希望Agent代替你操作的目标应用比如Chrome、Excel、CAD等等,现在都可以让Gemini 4模型帮你完成,我刚让他通过这个功能操作Chrome帮我查询30天内最便宜的去香港航班并推荐最舒适的行程,完全没问题,就跟你分身操作似的。
最牛逼的是什么?他额度是跟Antigravity完全分开的,也就是你Antigravity weekly额度变0了,这Gemini客户端也继续使用,我今天用它做了几个任务,Hydrogen模型我周额度居然没消耗,你说够不够。
我的习惯是,重度Agent编程和复杂任务,一定是走Antigravity(结合编排、grill、boost、swarm)能产生非常好的质量。但其他轻量级任务,完全不去浪费Antigravity的,就使用Gemini客户端就行了,这相当于把你Gemini额度double了一下,各位Get到了吧!


3
1
43
Gemini 4 Hydrogen 最新实测:推理 Token 减少 52%,成绩反而更好了!
ARC Prize 刚刚公布了 Google Gemini 4 Hydrogen 的独立验证结果。
这次有点意思:相比上一代 Gemini 3.8 Flash,新模型在推理 Token 减少约 52% 的情况下,ARC-AGI 成绩还能持平甚至反超。
先看 ARC Prize 官方验证的成绩:
ARC-AGI-1:98.5%,每题成本 $0.18
ARC-AGI-2:92.5%,每题成本 $1.26
这两个最高成绩都来自新增的 xhigh 推理档位。
更值得关注的是,ARC Prize 还专门对比了 Hydrogen 和上一代 Flash 在不同思考档位的表现。
在 ARC-AGI-2 上:
Medium:82.9% → 89.2%
High:89.2% → 90.0%
Low:77.5% → 65.8%
也就是说,Hydrogen 并不是所有档位都更强。低推理档反而明显退步,但中高推理档实现了提升。其中,在官方比较的高推理设置下,推理 Token 使用量减少约 52%。
这说明 Google 这次的优化,不只是简单提高推理预算,而是在提升模型的推理效率。
不过,还有个挺有意思的细节。
ARC Prize 原本还想测试 Hydrogen 在 ARC-AGI-3 上的表现,结果测试没能完成。
原因并不是模型解不出题,而是 API 工具调用存在兼容问题:
模型经常一次返回多个动作,而测试环境只接受单个动作;有时还会出现 MALFORMED_FUNCTION_CALL,甚至重复动作并触发 RECITATION 终止。
所以目前 ARC-AGI-3 没有有效成绩,不能据此判断模型的交互推理能力。
我觉得 Hydrogen 的定位越来越清晰了。
Google 不打算让它取代 Carbon、Argon 这类深度推理模型,而是希望它成为高效执行层:日常 Coding、Agent 工具调用和多模型协作交给 Hydrogen,复杂规划留给更强的模型。
未来模型之间的竞争,可能不只是看谁能想得更深,还得看谁能用更少的 Token,把事情做对。
原帖:teapawt.net/arcprize/status/212382…
详细成绩:arcprize.org/results/google-…
#Gemini4 #GoogleDeepMind #ARCAGI #AI模型

Gemini 4 Hydrogen from @GoogleDeepMind on ARC-AGI (Verified):
- ARC-AGI-2: 92.5%, $1.26/task
- ARC-AGI-1: 98.5%, $0.18/task
Gemini 4 Hydrogen matched or exceeded Gemini 3.8 Flash's scores on both benchmarks at high reasoning while using about 52% fewer reasoning tokens.


网页端 GPT‑6 Pro 究竟有多强?已经有人用它解决数学难题了
一直在用 GPT‑6 Pro,发现这个模型可能被不少人低估了。
OpenAI 在发布 GPT‑6 时,主要宣传的是 Astra 本身的能力,很少单独强调 Pro 到底比 Astra max 强多少。但社区已经拿 Pro 做了不少有意思的事情。
先看数学能力。
10 月 6 日,数学研究者 Alexandr Grebennikov 在 arXiv 发布论文,明确表示其中解决 Polynomial Littlewood–Offord 问题的关键证明由 GPT‑6 Pro 自主发现。
这个工作把此前带有对数损失的上界改进到了最优阶。作者随后验证并重写了证明,还公开了 ChatGPT 对话。
算法方面也有不少成果。
QOJ 上已经有人整理了数十道由大模型改进原题解的竞赛题,其中绝大多数标注为 GPT‑6 Pro。
例如 Rikka with Lake,整理者报告算法复杂度从 O(n⁴) 降到了 O(n)。这类题目考验的是算法构造能力,已经不只是简单的代码生成。
不过,Pro 到底比 Astra max 强多少?
第三方 WeirdML v2 给出了一个很有意思的对照:
GPT‑6 Astra max:93.3%
GPT‑6 Astra Pro max:93.6%
平均每次任务运行成本分别约为 7.75 美元和 29.31 美元,后者贵了约 3.8 倍,但得分只提高 0.3 个百分点。
当然,这套评测已经接近饱和,不能据此判断 Pro 在高难推理上的全部价值,而且测的是 API,不是网页端。
另一个 MBABench 2.0 测试中,旧版网页 Pro 在 101 项严格 Excel 交付任务中通过 3 项,Codex Astra xhigh 通过 16 项。执行环境不同,不能直接解释成模型智力差距。
最近网页 Pro 还有一次重要升级。
10 月 16 日,OpenAI 更新 GPT‑6 Pro,改进了工具调用,并加入多 Agent 并行执行能力。
现在主 Agent 可以把任务拆给多个子 Agent,同时查资料、分析不同问题,再汇总结果。用户还能查看子任务进度。
不过,OpenAI 尚未公开每个子 Agent 的具体模型配置和推理预算。
个人觉得,GPT‑6 Pro 最值得关注的还是复杂数学、算法创新和科研推理。已经有人拿出了具体成果,能力上限值得继续挖。
至于它是否全面强于 Codex 中的 Astra max,目前还缺少足够严格的同题对照。
Pro 很强,但多花的计算量,究竟能换来多少额外能力,还需要更多实测。
#GPT6 #OpenAI #AI模型 #AI研究

2
1
79
Haru-4B 开源:全双工语音模型,终于可以边听边说了
传统语音助手通常是 ASR → LLM → TTS:等你说完,再识别、生成、播报。日本团队 higurashi 开源的 Haru-4B 则原生支持全双工语音对话。
也就是说,你说话的时候,它可以继续听,也能同步回应。像电话里那样接一句“嗯”“我明白”,甚至在你还没讲完时插话,不必每次都等完整轮次结束。
Haru-4B 基于 Qwen3.5-4B。它每 133 ms 处理一帧(7.5 Hz),把用户音频、模型音频和文本三路 embedding 相加后送入同一个语言模型。音频侧使用 VibeVoice 的 64 维连续 latent;输出端用轻量 MLP + MeanFlow 一步生成音频,不需要额外的 Audio Transformer。作者称,相比逐 Token 交错排列,这种方式能把上下文长度降到三分之一。
多语言也不只是模型卡上写了“支持”。 团队称预训练使用超过 4000 万小时、覆盖 160 多种语言的真实语音,重点覆盖英语、西班牙语、葡萄牙语、德语、法语、中文、日语、俄语和韩语;全双工阶段还用了超过 1300 万小时分离后的双人对话数据。官方称训练数据没有混入 LLM 生成对话或 TTS 合成语音。
延迟数据也值得看。 团队在 M1 Max MacBook、int8 权重和原生 Swift/Metal 实现上报告了 65.2 ms 的 p50 端到端延迟,但不包含音频分帧带来的最多 133 ms 算法延迟。B300 上一次音频编码、解码和模型 step 合计约 15 ms。这些目前都是作者自测,仍需要独立复现。
代码和权重采用 Apache 2.0。部署提供 PyTorch、Apple Silicon 的 MLX 原生 macOS App,以及 vLLM-Omni 插件;官方给出的 NVIDIA GPU 建议是约 12GB 显存。
不过先别把它当成开箱即用的语音助手:Haru-4B 是预训练 base model,主要面向研究,不是 instruction-tuned assistant,官方也提醒它不适合作为可靠事实来源。多语言效果、噪声环境下的识别、打断处理和长对话稳定性,还得等更多实测。
我觉得这次最值得关注的不是“又一个 4B 语音模型”,而是全双工开始有了可本地部署、可继续研究的开放实现。
模型:huggingface.co/higurashi-ai/…
代码:github.com/higurashi-ai/Haru
#Haru4B #语音模型 #开源模型

7
1
152


不到 7GB 的 Qwen3.5-9B,作者称七项 Benchmark 超过 27B
最近一个名字很长的模型在 Hugging Face 上引起关注:Qwen3.5-9B-The-Defiant-Fable-Uncensored-Heretic。
它提供 4-bit GGUF 版本,文件大小约 6.4–7GB,还做了带 MTP 的版本。
它不是把 27B 直接压缩成 9B。开发者 DavidAU 和 Nightmedia 的做法,是把多个 Qwen3.5-9B 微调版本做多阶段训练与 Merge,再调整模型的拒答行为,并压缩了 Thinking/Reasoning Block。
先看 Benchmark。
作者公布了 ARC-C、ARC-E、BoolQ、HellaSwag、OpenBookQA、PIQA、Winogrande 七项成绩,并称超过 Qwen3.5-27B。
比如 ARC-C,9B BF16 是 0.649,Qwen3.5-27B-Instruct 的 MXFP8 是 0.557。
不过,这些是作者自己的结果,测试集也比较传统,而且两边精度并不完全一致。更细一点看,4-bit 那行的 Winogrande 是 0.691,略低于 27B 的 0.695,所以不能简单说每个量化版本都七项全胜。
拒答行为也变了。
模型卡给出的测试是:原始 Qwen3.5-9B 在 100 条提示中拒绝 100 条,修改版拒绝 6 条。
注意,这组拒答对比的基线是原始 9B,不是 27B。它说明的是拒答倾向变化,不代表推理能力同步提升,也不能据此判断回答更准确。
RTX 5090 上的 MTP 加速。
作者在 RTX 5090、Windows 11、LM Studio 上测试:Q4_K_S 普通版约 130 tok/s,MTP 版在 60% Token Acceptance、每轮接受 2 个 Token 时超过 185 tok/s,提升约 42%。
作者也提醒,MTP 接受率低于 50% 时,普通 GGUF 反而可能更快。
这次有意思的不是「9B 全面打败 27B」,而是多阶段微调、拒答行为调整和 MTP 推理优化被放进同一个模型项目里。
适合拿来做本地实验,但 Benchmark 和速度都还需要独立、同条件复测。
模型:
huggingface.co/DavidAU/Qwen3…
#Qwen #开源模型 #本地部署

7
3
196
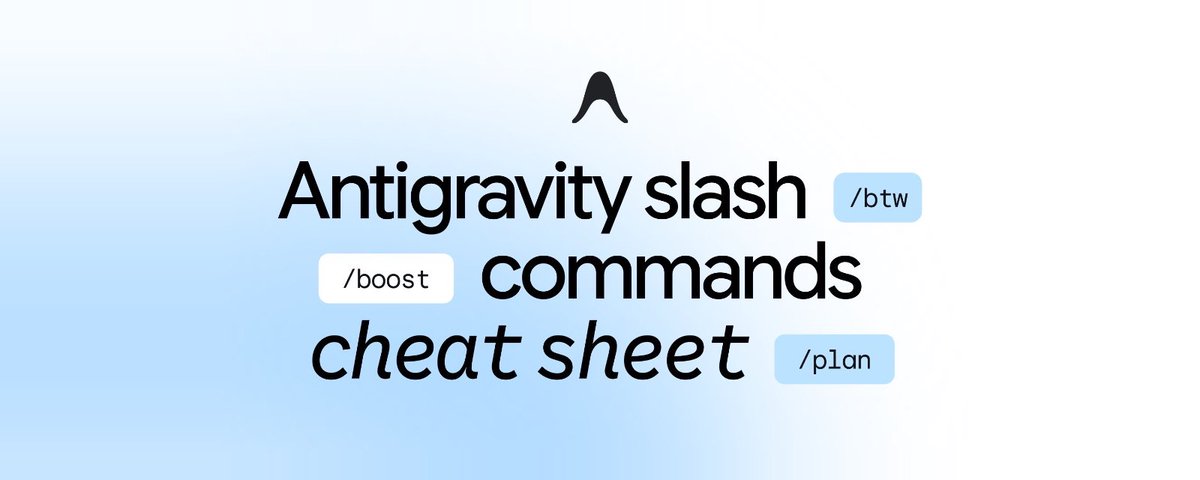
Google 整理了 Antigravity 的 10 个斜杠命令,这张速查表可以收藏一下!
Google Developers 最近分享了一张 Antigravity 斜杠命令速查表,整理了 10 个比较实用的命令。
很多人平时用 Antigravity,可能就是直接在对话框里描述需求,让 Agent 写代码。但实际上,输入一个 /,就能调用不少专门的工作模式。
我觉得有几个特别值得试试。
先说规划和需求确认。
/plan:先分析代码仓库,生成实施方案,确认后再动手修改。
/grill-me:让 Agent 反过来追问你,帮你把模糊需求、技术选择和边界条件想清楚。
这两个可以结合,例如 /plan /grill-me,比较适合大型重构或者复杂功能开发。
然后是让 Agent 自己干活。
/goal:给定目标和验收条件,让 Agent 持续执行、验证结果,减少中途反复确认。
/boost:针对复杂问题启动多 Agent 深度推理,适合难定位的 Bug、复杂算法和架构问题。
/teamwork-preview:原帖中的多 Agent 协作模式,适合大型迁移和长任务。目前官方文档使用 /teamwork 这个名称。
另外还有 /swarm,可以把任务拆给多个 Agent 并行处理,不过它不在这次的 10 个精选命令里。
其他几个也挺实用。
/learn:从当前会话提取经验,整理为可以复用的 Rules 或 Skills。
/plugin:安装插件、配置扩展和 MCP 工具。
/browser:使用浏览器 Agent 检查网页、测试交互。
/btw:不打断主任务,临时提问,而且不会污染主会话上下文。
/schedule:安排定时任务,可以一次性执行,也可以使用 cron 周期运行。
比如,每天自动检查 CI、整理 PR,都可以尝试交给它。
我觉得比较合理的使用方式是:先用 /plan /grill-me 把需求和方案确认好,再用 /goal 持续执行。遇到复杂问题用 /boost,适合并行的任务再考虑 /swarm。
这样用起来,比从头到尾只靠自然语言对话更有针对性。
当然,部分命令需要付费方案,不同入口支持情况也可能不同,具体以当前官方文档为准。
Google 原帖:
teapawt.net/googledevs/status/2122…
官方文档:
antigravity.google/docs/slas…
#Antigravity #CodingAgent #AI编程

4
2
147

Google 把 Gemma 做成了一本交互式 LLM 教科书,架构、部署、微调都能直接学!
今天发现一个挺不错的网站:gemma.ai。
这是 Google DeepMind 的 Gemma 开放模型技术网站。不过,它可不只是放几个模型权重和 API 文档,而是把大模型的架构原理、交互式可视化、推理部署、训练微调全部整理到了一起。
尤其是里面的交互式教程,我觉得做大模型的同学可以收藏一下。
最有意思的是 Learn 部分。
网站提供了一个「How LLMs Work」交互式教程,可以直接在浏览器里观察:
Tokenization:输入一段文字,看看如何被切分成 Token。
Embedding:探索向量空间、余弦相似度,以及模型如何表示语义。
Attention:观察 Q、K、V 的计算过程,以及 Local/Global Attention 的区别。
Sampling:拖动 Temperature、Top-K、Top-P,实时观察概率分布如何变化。
Chat & Tools:查看 Thinking、Tool Calling 以及原始 Token 流如何工作。
这些不是单纯的静态示意图,而是可以自己操作的交互式演示。
另外,架构可视化也做得挺细。
目前有 Gemma 4、Gemma 4 12B、MTP 投机解码和 DiffusionGemma 的可视化讲解。
比如 Gemma 4 的 MoE Routing、KV Sharing、Per-Layer Embeddings,以及 MTP 如何通过 Drafter 预测多个 Token,都能结合图解理解。
对于工程开发者,Run 和 Fine-tune 两部分更实用。
推理部署覆盖 Ollama、llama.cpp、MLX、vLLM、SGLang 等框架,还提供了 QAT 4-bit 量化权重的使用说明。
训练部分则包含 LoRA、QLoRA、全参数微调、MoE 微调、多模态微调,以及 DPO、RL 等方法。
甚至还准备了 gemma-dev 和 gemma-trainer 两个可安装的 Agent Skills,分别帮助 Coding Agent 完成模型应用开发和训练任务。
我觉得这个网站最有价值的地方,是把大模型原理讲解和实际工程操作放在了一起。既能学架构,也能直接找代码和部署方案。
而且其中不少原理并不局限于 Gemma,对理解 Qwen、DeepSeek 等模型同样有参考价值。
网站:gemma.ai/
交互式教程:gemma.ai/learn/how-llms-work…
#LLM #Gemma #大模型 #AI技术

12
9
417
🚀 Qwen3.8-27B 在 Mac mini 上跑到 91.9 tokens/s!纯靠推理优化提速 5.4 倍
有点猛哇!一台 64GB 内存的 M5 Pro Mac mini,运行 Qwen3.8-27B,竟然跑出了 91.90 tokens/s 的成绩。
更有意思的是,没有升级硬件,也没有重新训练主模型,而是通过 TensorFold + DFlash2 投机解码,把原本约 17 tokens/s 的速度直接拉了起来。
这次测试的数据很有看点:
- 普通解码:约 17 tokens/s
- DFlash2 聊天场景:约 56 tokens/s,提升 3.3 倍
- DFlash2 代码场景:最高 91.90 tokens/s,提升约 5.4 倍
- 显存峰值:约 28.5 GiB
这里真正值得关注的是 DFlash2。
它采用投机解码,让一个轻量级 Draft 模型先预测后续多个 Token,再交给主模型批量验证。
如果预测正确,一次验证就能接受多个 Token,减少大模型昂贵的串行 Decode 次数。
而且,这次测试使用的是 Qwen3.8-27B 的 MLX 4-bit 量化版本,配合专用 DFlash2 Drafter,并不是把原始高精度模型直接跑到 90 tokens/s。
另外,测试者还比较了 TensorFold 1.2.1 和 1.2.2。
有意思的是,91.90 tokens/s 实际来自 1.2.1 的代码测试,1.2.2 在同类测试中为 88.93 tokens/s。
新版本并不是所有场景都更快。31K 长上下文测试中,1.2.2 的加速比约为 2.77 倍,明显低于代码场景。
测试还发现,在 temperature=0 的配置下,开启投机解码前后输出 Token 完全一致。不过,这不代表所有采样配置都能得到完全相同的结果。
我觉得这组数据最有价值的地方,不只是 91.9 tokens/s 这个数字。
对于本地部署大模型,推理框架、Draft 模型和推测接受率的优化,可能比单纯升级硬件更值得折腾。
尤其是 Coding Agent 这类连续生成代码的场景,收益确实值得关注。当然,91.9 是特定测试条件下的成绩,不代表真实 Agent 任务能整体提速 5.4 倍。
现在的本地推理,软件优化还有很大的空间。
项目:github.com/ashhart/TensorFol…
原始跑分:huggingface.co/datasets/prat…
#Qwen #DFlash2 #TensorFold #LocalAI

11
10
353
Google AI 会员别只用 Antigravity!Gemini 还有一套独立额度,现在连 Mac 都能直接操作了 😂
最近发现,Google AI 会员的额度其实可以分开用。很多人每天盯着 Antigravity 的剩余额度,却忽略了另一个相当能打的入口:Gemini App。
Google 官方文档已经明确,不同产品有各自的 AI 使用限额。也就是说,Antigravity 用到额度上限,不代表 Gemini App 也没法继续用了。
而且,11 月 19 日 Google 又给 Gemini Mac 客户端上线了一个很有意思的功能:Computer Use(电脑操作)。
这下 Gemini 不只是聊天工具了,是真的可以替你干活。
具体来说,它能:
- 操作本地软件:自动点击、输入、滚动、操作菜单,跨应用执行任务。
- 处理本地文件:读取文件夹里的 PDF、图片等,再把信息填写到其他应用。
- 后台执行任务:在独立的虚拟窗口里运行,不占用你正在使用的鼠标和屏幕。
- 跨软件完成工作流:例如整理照片、操作 Lightroom,或者从仪表盘收集数据生成演示文稿。
更有意思的是,整个过程可以实时预览,还能控制应用权限、随时停止,并在敏感操作前进行确认。
使用也很简单:安装 Gemini Mac 客户端,在设置中开启 Computer Use,然后进入 Task 模式,通过 "@Computer use" 分配任务即可。
目前该功能正在美国面向 Google AI Plus、Pro、Ultra 个人订阅用户推出,要求英语环境、Apple Silicon Mac 和 macOS 15 以上系统。
重点来了:这不是 Antigravity 的编程 Agent,而是 Gemini 自己的电脑操作能力。
不过要注意,Mac 客户端并不是又赠送了一套完全独立的额度,它属于 Gemini App 的使用体系。
至于 AI Studio 和 Vertex AI,也可以作为额外的模型调用入口,但 API 配额和账单规则要单独看,不能简单理解成订阅会员就能无限使用。
所以如果你已经订阅 Google AI Pro 或 Ultra,我的建议是:
Antigravity 负责写代码,Gemini App 负责研究和日常任务,Mac Computer Use 负责本地自动化。
一份订阅,多个入口分工使用,这才是把会员权益用起来的正确姿势。😂
官方介绍:blog.google/innovation-and-a…
#GoogleAI #Gemini #Antigravity #AIAgent

11
5
365
Inkling 2 Mini 登上 DesignArena!26B 小模型挑战 594B,速度快了 8 倍!🔥
Thinking Machines 刚发布的 Inkling 2 Mini 已经加入 DesignArena,官方还拿它和自家的 Inkling 2 Small 进行了一场有意思的对比。
结果是:Mini 快了 8 倍,成本降低 60%,但 Small 的画面细节更好。
这次测试要求两个模型使用 Three.js,把梵高的《星月夜》重新做成一个可以交互的 3D 场景。
不仅要还原旋转的星空、柏树、村庄和月亮,还要让场景动起来,支持切换视角和画面风格。
两个模型都只有一次生成机会,不进行后续修改。
最终效果上,594B 的 Inkling 2 Small 确实更胜一筹:笔触更接近原画,月亮细节更丰富,房屋甚至有门和烟囱冒出的烟。
Mini 则省略了一部分细节,还额外生成了三只原画和提示词都没有的鸟。
但 Mini 最大的优势还是效率!
它只有 26.4B 总参数,每个 Token 激活约 3.4B 参数,比 594B 的 Small 小得多。
而且它还采用了很特别的 Looped Transformer 架构,让中间层重复执行三次,相当于通过重复计算增加推理深度,而不是一味堆参数。
模型采用 NVFP4/MXFP8 混合精度,权重体积约 20GB,已经开放权重,可以在合适配置的笔记本上本地运行。
我觉得这次对比挺有代表性:大模型依然更擅长复杂细节,但小模型已经能以更低的成本完成相当复杂的生成任务。
对于本地 Coding Agent 来说,这种体积小、速度快、能力又够用的模型,可能比单纯追求榜单第一更有吸引力。
原帖:
#Inkling2Mini #DesignArena #AI #开源模型

Inkling 2 Mini by @thinkymachines is now available on DesignArena!
Inkling 2 Mini is Thinking Machines’ new open weights model, small enough to run on a laptop, with 26.4B total and 3.4B active parameters.
In its release on Hugging Face, Inkling 2 Mini recreated The Starry Night live in a shader. We took that idea into 3D and had Inkling 2 Mini and Inkling 2 Small each rebuild the painting as a scene with a swaying cypress, a village of small houses with lit windows, rolling blue hills, a crescent moon, and a sky painted with thick brush strokes of blue, white, and yellow.
Inkling 2 Small’s brush strokes are more consistent and closer to the painting’s, and its moon has more detail. Inkling 2 Small’s houses have doors and smoke rising from their chimneys, while Inkling 2 Mini’s have neither. Inkling 2 Mini adds three simple birds, which aren’t in the prompt or the painting.
Inkling 2 Mini was 8x faster and 2.5x cheaper.
Congrats to the @thinkymachines team on the launch!
2
62

Google Antigravity 又迎来重要更新!Opus 5.5 正式加入 Orchestrator 模式,额度也要改善了!🔥
这次更新我觉得挺有意思的,Antigravity 终于可以让 Claude Opus 5.5 负责规划,Gemini 4 Hydrogen 负责执行 了。
这不就是大家一直想要的强模型规划 + 快模型干活吗?😂
原本 Orchestrator(Neon)主要使用 Gemini 4 Neon 规划、Hydrogen 执行,现在官方文档已经确认,规划模型还可以选择 Claude Opus 5.5。
具体来说:
- Opus 5.5:理解需求、分析代码、制定计划、审查结果。
- Gemini 4 Hydrogen:负责修改代码、调用工具、运行测试等具体执行工作。
- Gemini 4 Neon:仍然可以作为默认规划模型,兼顾速度与推理能力。
整个过程自动切换。如果执行过程中遇到问题,还会把控制权交回规划模型重新思考,不需要人工反复切换。
在 Antigravity 的 Settings → Models → Orchestrator Settings 中,就可以配置规划和执行模型。
另外,还有两个额度方面的好消息!
第一,Antigravity 团队正在扩大 Neon 的缓存池,预计缓存命中率提升约 4 个百分点,让相同额度能够完成的工作量至少提升 20%。
第二,团队负责人 Varun Mohan 已经明确表示,由于此前缓存问题导致额度消耗过快,将在优化完成后再次重置额度!
不过具体重置时间暂未公布。
之前 Antigravity 的额度一直是大家吐槽的重点,这次不仅通过缓存优化降低实际消耗,还准备补偿一次额度重置,确实挺有诚意。
我觉得 Antigravity 这条路线越来越清晰了:把最强的模型用在最需要思考的地方,把高频执行交给更快、更便宜的模型。
未来的 Coding Agent,或许不再是谁家单个模型最强,而是谁能把不同模型组合得最好。
参考资料:
antigravity.google/docs/mode…
teapawt.net/_mohansolo/status/2123…
#Antigravity #Claude #Gemini #CodingAgent


We’re rolling out a change to increase cache hit rate on Neon by around 4% on Antigravity by massive increasing the cache pool size. This will increase what you can get done in quota by at least 20%.
Will issue a reset after it’s done since it burned quota faster!
7
3
212