

wanderer | everything about common sense
Silicon Valley
Joined March 2022
- Tweets2K
- Following754
- Followers57
- Likes1.5K




R X retweeted

Damn,Karpathy这条帖子直接把我过去半年的AI工作流全推翻了🤯
大家都在死等更强的模型,
死等更大的上下文窗口,
但Karpathy说,你们全搞错方向了,
现在AI最大的瓶颈,根本不是模型不够聪明,
是我们还在用文本这种最低带宽的方式,跟它沟通。
他推荐了一个所有人今天就能用的trick,
在任何query的最后加一句:
"structure your response as HTML"
然后让Claude直接帮你打开,
出来的效果好到离谱,
不仅仅是多了点颜色和排版,
更像是你终于给AI打开了大脑里那片10车道的视觉超级高速公路,
同样的内容,HTML的阅读效率和理解深度,是Markdown的10倍以上,
这简直就是人机交互的真正下一代范式,因为人类的输入和输出偏好,天生就是完全不对称的,
输入最自然的是音频,说话比打字快4倍,思考也更连贯,
输出最擅长的是视觉,我们大脑1/3的皮层,全用来处理视觉信息,
而我们现在,却在用文本这种单车道的土路,双向跑所有的流量,
Karpathy画了一条清晰的演进路线:
原始文本 → Markdown → HTML → 交互式神经视频,
我们现在正站在Markdown到HTML的转折点上,
最令人兴奋的是,很多人说HTML费token,生成慢,
但你算一笔账就懂了,
多花2倍的token,换你10倍的阅读速度和理解深度,
这是全世界最划算的交易了吧哈哈,
可惜我们早就被省token的思维绑架了,却忘了人类的时间才是真正的稀缺资源,
还有一个更扎心的认知,
Markdown是给AI看的格式,
HTML是给人用的格式,
AI代理之间沟通,用Markdown甚至JSON都没问题,
但所有最终要给人类消费的东西,都应该切成HTML,
这才是最优的分工,
现在我已经把所有prompt的结尾,都加上了那行字,
做对比用并排表格,做分析用彩色标注,做原型用交互式滑块,
AI不再是给我甩一大段干巴巴的文字让我啃,
它直接给我造了一个可交互的视觉思考空间,
Karpathy说,人机的心智融合才刚刚开始,
我们根本不用等Neuralink那种脑机接口,
先把HTML用起来,就是当下能摘到的最大最甜的低垂果实🍒
#AI #Karpathy

This works really well btw, at the end of your query ask your LLM to "structure your response as HTML", then view the generated file in your browser. I've also had some success asking the LLM to present its output as slideshows, etc.
More generally, imo audio is the human-preferred input to AIs but vision (images/animations/video) is the preferred output from them. Around a ~third of our brains are a massively parallel processor dedicated to vision, it is the 10-lane superhighway of information into brain. As AI improves, I think we'll see a progression that takes advantage:
1) raw text (hard/effortful to read)
2) markdown (bold, italic, headings, tables, a bit easier on the eyes) <-- current default
3) HTML (still procedural with underlying code, but a lot more flexibility on the graphics, layout, even interactivity) <-- early but forming new good default
...4,5,6,...
n) interactive neural videos/simulations
Imo the extrapolation (though the technology doesn't exist just yet) ends in some kind of interactive videos generated directly by a diffusion neural net. Many open questions as to how exact/procedural "Software 1.0" artifacts (e.g. interactive simulations) may be woven together with neural artifacts (diffusion grids), but generally something in the direction of the recently viral teapawt.net/zan2434/status/2046982…
There are also improvements necessary and pending at the input. Audio nor text nor video alone are not enough, e.g. I feel a need to point/gesture to things on the screen, similar to all the things you would do with a person physically next to you and your computer screen.
TLDR The input/output mind meld between humans and AIs is ongoing and there is a lot of work to do and significant progress to be made, way before jumping all the way into neuralink-esque BCIs and all that. For what's worth exploring at the current stage, hot tip try ask for HTML.
R X retweeted

花一天时间掌握Claude:
→ 第1级 - 24分钟:基础知识。
'Claude傻瓜指南':ruben.substack.com/p/claude-…
'Claude设置':how-to-claude.ai
→ 第2级 - 1小时:实际工作流。
'Claude协作':claude-co.work
'Claude团队版':how-claude.team
'Claude设计':claudedesign.free
'协作+项目':ruben.substack.com/p/claude-…
'Claude幻灯片':how-to-gamma.ai
'Claude技能':claude-skills.free
→ 第3级 - 3.5小时:专业技巧。
'避免奉承':ruben.substack.com/p/i-love-…
'Claude代码':claudecode.free
'Claude 101':anthropic.skilljar.com/claud…
'突破Claude限制':ruben.substack.com/p/how-to-…
'停止瞎提示':ruben.substack.com/p/stop-pr…
→ 第4级 - 8小时:专家模式。
'Claude电脑':ruben.substack.com/p/claude-…
'用Claude API构建':anthropic.skilljar.com/claud…
专业提示:别一口气看完。每次学一级。

R X retweeted

这个学习Claude Code的教程真的不错
Github上都快6w star了,才发现有这样的好东西
learn.shareai.run/


这个 Learn Claude Code 教程真的写得很好
learn.shareai.run
作为程序员,每当看到cc出了新功能,都会去猜下它大概是如何实现的,这个教程大概就带我们简单经历了一遍cc这个code agent的简易形态的开发历程。这类教程最有价值的就是背后的思考:之前的agent是遇到了什么问题,而新功能是如何解决这个问题的。
🙋 这有什么好处呢?
估计不久,大家都要从使用agent转为开发公司或者业务内部的agent,那就不可避免遇到一些问题,然后你就得考虑如何解决问题。这个教程在训练你的思维,让你学习先进agent背后的工作原理。

R X retweeted

有人问我,如何锻炼自己的口才?其实有一个非常简单但效果惊人的方法,这就是费曼练习法的一个变体:在日常生活中,随时选取你眼前的任何一个事物,用3分钟不停地描述它。无论是路边的汽车,还是桌上的一个苹果,你都可以结构化它,从颜色、形状、功能、带给你的感受,甚至联想到的故事去展开表达。关键不在于你说得多高级,而在于持续不断地输出,让自己始终保持表达状态,不停顿、不冷场。坚持练习一段时间,你会明显感觉到思维更流畅,表达更自然,面对陌生人或镜头也不再紧张,大脑关于“说话”的回路会被不断强化,让你逐渐成为一个能够清晰、有条理表达自己想法的人。
R X retweeted

最近AI圈很火的“Harness Engineering”到底是啥?🤔
刚看完这个视频,感觉讲得挺透。
简单理解就是:
Prompt Engineering 是“怎么问问题”;
Context Engineering 是“怎么给资料”;
Harness Engineering 就是“怎么给AI套缰绳”。
视频里有个比喻特形象:大模型就像一匹野马,Harness就是缰绳。没缰绳,马跑得再快也是瞎跑(产生幻觉、不可控)。
最震撼的是OpenAI那个实验:5个月写了100万行代码,而且全是AI写的,人类一行没动!但这背后全靠这套“马具”系统在兜底。
感觉现在的AI开发,拼的不仅仅是模型参数,更是谁能把这套“缰绳”设计好。视频里Anthropic那个“三人行”模式(规划+生成+评估)虽然贵点慢点,但效果确实稳。
想搞懂AI Agent怎么落地的,推荐看看。👇
R X retweeted

推荐给还没有使用Claude Code或者和我这样半吊子的人看半小时!

兄弟们!花半小时,一定要看完它!
Claude Code的缔造者Boris Cherny,亲自站上台,用整整30分钟把这个工具的全部高级用法一次性讲透了。
免费、干货真的夯到爆!。
他从最基础的全局安装开始,一路讲到:
- 如何通过CLAUDE.md在企业级、项目级、本地级层层注入上下文,让Claude真正“懂你的团队规矩”
- 怎么把团队内部工具(日志、CI、数据库)无缝插进Agent工作流
- 优化终端设置、权限管理、语音输入、通知提醒等40多个隐藏细节
- 以及Claude Code SDK的完整使用姿势
最狠的是,他反复强调:你给Claude的上下文越多,它就越聪明。
而现实是:大多数人每天都在用Claude Code,却只发挥了它10%的实力,像用ChatGPT一样简单prompt,错过了真正让生产力起飞的工程级用法。
Boris这场30分钟的分享,含金量直接秒杀市面上任何1000美元付费课程。
想把Claude Code玩成生产力基础设施的人,这条视频必须立刻收藏、反复看。
你现在用Claude Code到什么程度了?是还在简单聊天,还是已经把它当成整个工程团队在跑?
欢迎讨论。
R X retweeted

非常值得刷的视频课--麻省理工《How to AI (Almost) Anything》
这门MIT公开课教你如何用AI(几乎)做任何事情——共12节课,覆盖大量专业领域 youtu.be/0MYt0u3CW5I?list=PL…
大部分内容容易忘,建议把这份中英双语版讲义+图文笔记(社区整理)保存到NotebookLM / Claude / ChatGPT构建你自己的知识库,方便随时对话检索👇
v2su.com/4211/

R X retweeted
兄弟们,都已经2026年了!
强烈推荐了~
但最荒谬的是-顶级AI公司里不少工程师,每天调提示词、刷benchmark。
却对LLM到底怎么从零构建出来的了解,远不如斯坦福这堂2小时公开课。
它把ChatGPT、Claude这类大模型的完整诞生过程,从Transformer架构到训练技巧、Scaling law、数据配比、甚至最底层的优化细节,全都拆得清清楚楚。
抖音快手短视频能让你放松2小时,
斯坦福这堂课却能让你在2小时内,真正看懂整个AI时代的底层核心要素。
免费、公开、含金量夯到爆啊!。
很多在OpenAI、Anthropic工作的人,都没系统学过这么多。
真正想懂AI的人,现在就把抖音关掉,打开这个视频开干。
R X retweeted
Stanford CS336 上,Tatsu 讲了一节 LLM 架构课,把过去 3 年所有主流 LLM 拆开,看它们的共通模板
结论挺爆:90% 的架构选择已经收敛,你随便挑一个开源大模型,它跟其他模型在这些维度上几乎一模一样
讲师的原话
- 2024 年大家都在 cosplay Llama2
- 2025 年的主题是「怎么训得不崩」
- 2026 年的主题是「怎么扛住长上下文」
下面是 2026 年开源 LLM 的标准模板 你训自己的模型可以直接抄
【架构层 已经收敛的 7 件事】
1)Layer Norm 挪出残差流(pre-norm)
原版 Transformer 把 LN 放在残差里 几乎所有现代模型都挪到外面
原因:keep your residual stream clean 梯度反传更稳
2)RMS Norm 替代 LayerNorm
LayerNorm 的减均值 + 加 bias 那部分实际没怎么帮上忙
丢掉之后 flops 只省 0.17% 但运行时省到 25%
(瓶颈在数据搬运 计算反而次要)
3)所有 bias 项全删
跟 RMS Norm 一个道理 系统层省内存搬运
4)激活函数用 SwiGLU 或 GeGLU
gated linear unit 几乎所有现代模型都用
Llama 系 / Qwen / Mistral 用 SwiGLU
Google 系(Gemma / T5)用 GeGLU
区别极小 选哪个都行
5)位置编码用 RoPE
2024 年之后基本统一了
原理:把每对维度按位置旋转一个角度 让 inner product 只依赖相对位置
6)Transformer block 串联(不是并联)
GPT-J / Palm 试过并联 现在基本被放弃
串联的实现优化得太好了 并联省的那点系统开销不值得损失表达力
7)Layer norm 可以「撒」
哪儿不稳就在哪儿加 LN
attention 之前能加 之后能加 两边都加(double norm)也可以
现代模型很多这样做
【超参数 已经收敛的 5 个数】
1)feedforward 维度 / hidden 维度
- 非 GLU 模型:4 倍
- GLU 模型:8/3 ≈ 2.67 倍(因为 GLU 多一组矩阵 要保持总参数量)
- Llama 系:3.5 倍
- T5 1.0 试过 64 倍 后来 T5 1.1 改回标准 别学
2)head 数 × head 维度 ≈ hidden 维度
几乎所有模型都遵守 T5 是为数不多的例外
3)模型纵横比(hidden / 层数)≈ 100
太深 pipeline parallel 难做
太宽 表达力受限
100 这个数字是系统约束 + 表达力的平衡点
4)vocab size
单语模型:30K 左右(早期 GPT-2 那种)
多语 / 通用模型:100K-200K(GPT-4 / Llama 3 / Gemma 都在这个范围)
现代基本都是后者
5)weight decay
仍然普遍使用
但研究发现它在 LLM 里干的事其实是优化器干预 让你最终能收敛到更深的最优点
跟你想的「防过拟合」没什么关系
所以别因为「单 epoch 不会过拟合」就把它关掉
【稳定性 三个救命 trick】
训练大模型最怕中途 loss 突然飙升 然后 NaN 全军覆没
现代模型用三个 trick 防这件事
1)Z-loss
output softmax 的 normalizer 容易爆
加一个 (log Z)² 的正则项 让 Z 始终接近 1
DCLM / Olmo 都用
2)QK norm
attention 的 Q 和 K 在矩阵乘之前各加一个 LN
让 softmax 的输入永远是单位尺度
multimodal 圈先用起来 现在所有大模型都加
3)Logit soft cap(仅 Google 系)
attention logit 用 tanh 硬封顶
Gemma 2/3/4 都在用 但会损失一点点性能 慎用
【Attention 两个新趋势】
1)GQA(Grouped Query Attention)几乎统一
原版 multi-head 推理时 KV cache 会让算术强度崩到 1/h
GQA 共享 K 和 V 但保留多个 Q
表达力几乎不损失 推理成本砍掉 80%
现在所有要做生产部署的大模型 没有不用 GQA 的
2)局部 + 全局 attention 交替
处理长上下文的新方式
Cohere Command A 起头 现在 Llama 4 / Gemma 4 / Olmo 3 全在用
比如每 4 层有 1 层 full attention 其他 3 层是 sliding window 只看附近的 token
比纯 SSM 更稳 比纯 full attention 便宜得多
(Qwen 3.5 做了变体 把 sliding window 那 3 层换成 SSM)
收尾一句
如果你正在训自己的 LLM,上面这一套就是 2026 年的「默认配置」 不需要重新发明,直接抄
如果你只是想看懂 GitHub 上那些 modeling_xxx.py
这一份足够你不再被术语吓住

Anthropic pays $750,000+ a year for engineers who can build LLM architectures from scratch. Stanford taught the entire thing in 1 hour lecture & released it for free.
Bookmark & watch this today before someone takes it down.
Readers added context they thought people might want to know
The video is Lecture 3 on architectures and hyperparameters from Stanford's 19-lecture CS336 course "Language Modeling from Scratch," which covers the full process including data, training, and evaluation; one lecture does not teach building LLMs from scratch. youtube.com/watch?v=ptFiH_… stanford-cs336.github.io/spring2025/
R X retweeted
不管你用的啥模型, 推荐一份CLAUDE.md
来自Andrej Karpathy skills和X爆火的agent工作流,可以直接复制,包含Agent整体约束、工作流编排和任务管理⤵️


2026年了,大模型卷成这样,最能拉开真实差距的到底是什么?
不是生图、不是视频、更不是Agent。
依旧是文本。
代码、推理、多模态,全在文本这块地基上盖楼。地基不稳,上面再漂亮也晃。
所以我看模型,第一件事永远是刷LMArena文本榜。
今天刚更新,文心5.1 Preview直接干到国内第一!
Top 15里唯一一个国产模型,硬刚在GPT-5.5和DeepSeek-V4-Pro前面。
我人都看傻了,真的没想到。
更离谱的是背后技术:文心这次用「弹性训练」,一次训练直接出多种规模模型,预训练成本据说只有同规模的6%,效果却领先。
这还只是Preview!
正式版5月百度Create大会就要发布,到时候分数大概率还得再跳。
千帆平台已经开放邀测,我马上拿真实任务去跑。
正在挑主力文本模型的朋友,这波真值得重点关注了。
你们觉得文心这次能彻底翻身吗?👀


R X retweeted

写的非常详细的入门教程
RL 很恶心的点就在于你什么都要会:pretrain、inference、theory、infra
现在我也有了可以推荐给别人入门的读物,比我当时东看一点西看一点好太多了🥺
很多现代 LLM 的教学其实跳过了相当一部分的基础知识,比如 CNN、Q-Learning 这一类经典内容。我感觉我也是填鸭式地在学习这些内容,需要耐下心来慢慢地去看那些最旧最老最传统的东西
很感谢苏剑林的 blog 带我入门,我也想能写出一些带别人入门的东西,只不过即使是用 LLM 辅助写 notes 也相当折磨人,然后知乎上还没什么人看
当然还是有很多人喜欢看我写的垃圾 notes 的,还被行业杰青大佬订阅了,这种事跟 paper 被人关注了一样开心
Website: walkinglabs.github.io/hands-…


比较有趣的入门教程
该项目希望用一条更“实践优先”的路径来学习现代强化学习:从经典控制出发,逐步连接到 LLM 后训练基础、DPO/GRPO/RLVR、Agentic RL 和 VLM RL 等现代应用。
GitHub: github.com/walkinglabs/hands…
WebPage: walkinglabs.github.io/hands-…


R X retweeted

想转行做 AI 工程师?你大概率会先被两样东西劝退:碎片化教程,以及一眼就知道是 AI 拼出来的长文,既不成体系也不落地。
我在 GitHub 上挖到一个更靠谱的:AI Engineering Field Guide。它不是“经验贴”,而是基于 1765 份真实职位描述 + 实际面试经历整理出来的开源指南,数据驱动,直接对准求职和上手。
它把 AI 工程师这份工作的关键信息拆得很清楚:岗位在招什么、技能怎么配、面试怎么走、常见题型和真实案例长什么样。更重要的是,还按数据/后端/前端等不同背景,给出了可执行的转型学习路径。
GitHub:github.com/alexeygrigorev/ai…
内容覆盖角色定位与技能地图、完整面试准备清单、精选学习资源合集,以及真实的市场数据与项目案例;还收录了 OpenAI、Anthropic、Google、Meta 等 51 家公司的面试流程与经验整理,并附带 17 个 take-home 作业的真实案例分析。
如果你在认真考虑转型 AI 工程师,或想系统搞清楚这岗位到底在做什么、怎么准备,这份指南值得直接收藏。


R X retweeted

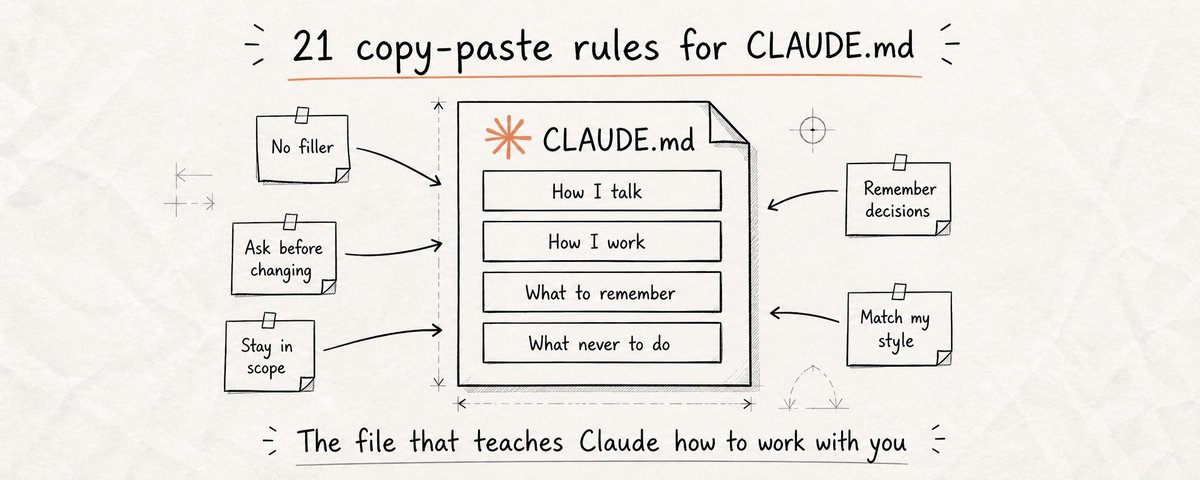
CLAUDE.md 终于有人把最全用法讲清楚了
原来很多人用 Claude 这么久,其实只用了它20%的能力。
作者直接把 CLAUDE.md 的核心玩法摊开了——一个简单文件,就能让 Claude 每次打开会话都不再从零开始,记住你的偏好、规则和上下文。
CLAUDE.md 不是只有程序员才需要的东西。写手用它锁死自己的语气,营销人用它定义受众,研究者用它固定输出结构,老板用它把公司背景一次性喂给 Claude。
没有它,你每次都要重复解释自己;有了它,Claude 就像一个越来越懂你的长期同事。
作者分享的核心玩法很简单:
在项目文件夹里新建一个叫 CLAUDE.md 的文件(大写,无空格),然后把规则直接写进去就行。Claude Code 每次启动会自动读取它,不用额外操作。
里面最实用的几条(我挑我觉得最立刻能用的):
• 干掉所有“Great question!”之类的废话,开场直接给答案
• 大动作前先列2-3个方案,让你选方向再执行
• 不确定的时候主动说“我不确定”,别自信满满地编
• 长度匹配任务需求,别简单问题写四段,长任务却只给骨架
• 改东西前先确认,别擅自大改文件
• 专注用户问的问题,别顺手“顺便优化”其他地方
• 每次结束时总结改了什么、没改什么
• 永远不替你做外部动作(发邮件、发帖、改数据库)除非你明确说 yes
作者还提到 Andrej Karpathy 那版爆火的 CLAUDE.md 里4条核心规则,基本可以直接抄进去。
我看完后的感觉是,这东西就像给 Claude 装了一个永久记忆体和行为守则。设置一次,后面每次使用都省一大堆重复劳动。
尤其是对重度用户来说,真的值得现在就建一个试试。
AI 工具越来越强,但真正决定你能用到什么程度的,是你愿不愿意把这些“幕后规则”先搭好。
CLAUDE.md 就是其中最简单、回报最高的一个。

R X retweeted
20 个 Claude Code 技巧:
1. Esc+Esc:将您的会话回退到任何之前的检查点;将其视为免费的撤销功能,让代理尝试风险更改。
2. CTRL+V:直接将截图粘贴到 Claude Code 中。
3. CTRL+G:打开您的编辑器来撰写长提示,而不是在终端中输入它们。
4. CTRL+R:搜索您的提示历史记录。
5. /rewind:回滚更改到检查点,然后提供更具体的反馈并重试。
6. /rewind → "Summarize from here":选择一个检查点并仅压缩其后的消息,保持宝贵的前文上下文完整。
7. /insights:生成使用报告,然后将其附加到 Claude 会话中,并询问改进工作流程的经验教训。
8. /memory:保存应在所有项目中持久化的个人偏好。
9. /statusline:永久显示您当前正在使用的上下文量。
10. cat error.log | claude "fix this":直接管道传输错误,而不是复制/粘贴,从而为模型提供更多上下文。
11. .claudeignore:将此文件添加到您的项目中,以列出代理不应读取或修改的路径。
12. #:以 # 开头一条消息,将其保存为 CLAUDE .md 文件中的持久指令。
13. "ultrathink":在提示中的任何位置插入这个词,将模型的努力程度提升到 HIGH,用于复杂推理任务。
14. /diff:打开交互式查看器,查看未提交的更改和每轮差异。
15. /effort max:当您想最大化 Claude 的能力时使用(这很昂贵!)
16. /loop:本地调度一个重复任务。
17. /schedule:类似于 /loop,但作业在云端运行,而不是本地。
18. claude --worktree:在隔离的 git 工作树中启动一个会话,以便并行运行更多 Claude 实例。
19. /sandbox:在具有文件和网络隔离的沙箱中运行 Claude。
20. /voice:激活语音输入并按住空格键来说出您的提示。


20 Claude Code tips:
1. Esc+Esc: Rewind your session to any previous checkpoint; treat it as free undo so you can let the agent attempt risky changes.
2. CTRL+V: Paste a screenshot directly into Claude Code.
3. CTRL+G: Open your editor to compose long prompts instead of typing them in the terminal.
4. CTRL+R: Search your prompt history.
5. /rewind: Roll back changes to a checkpoint, then give more specific feedback and try again.
6. /rewind → "Summarize from here": Pick a checkpoint and compress only the messages after it, keeping the valuable earlier context intact.
7. /insights: Generate a usage report, then attach it to a Claude session and ask for lessons to improve your workflow.
8. /memory: Save personal preferences that should persist across all your projects.
9. /statusline: Permanently display how much context you're currently using.
10. cat error.log | claude "fix this": Pipe errors straight in instead of copy/pasting, giving the model way more context.
11. .claudeignore: Add this file to your project to list paths the agent shouldn't read or modify.
12. #: Start a message with # to save it as a persistent instruction in your CLAUDE .md file.
13. "ultrathink": Drop this word anywhere in a prompt to bump the model's effort to HIGH for complex reasoning tasks.
14. /diff: Open an interactive viewer for uncommitted changes and per-turn diffs.
15. /effort max: Use this when you want to maximize Claude's abilities (it's expensive!)
16. /loop: Schedule a recurring task locally.
17. /schedule: Like /loop, but the job runs in the cloud and not locally.
18. claude --worktree: Spin up a session in an isolated git worktree so you can run more Claude instances in parallel.
19. /sandbox: Run Claude in a sandbox with file and network isolation.
20. /voice: Activate voice input and hold the space bar to speak your prompts.

