
CTO @ Archdesk | Systems where physics meets economics. Ex-Hacker. Ex-Fintech CEO. Nullius in verba. 🖖 AI does not fail. Human judgment does.
POLAND, Kraków (Cracow)
Joined September 2008
- Tweets4.6K
- Following727
- Followers527
- Likes2.1K






Michał Piszczek retweeted

Archdesk CTO Michał Piszczek 花了一个通宵实测:在 24GB 卡上跑 30B 稠密模型加投机解码,最快的量化方案反而第一个出局。
《DFlash 改变了 token per second 的含义》
我花了一个晚上,试图把一个 30B 的稠密模型、256K 上下文、视觉模块和投机解码塞进一块 24 GB 的 GPU。最快的量化输了。困惑度最低的量化也输了。赢的是那个让整个系统变得有用的配置,而不是任何单一数字好看。
最终方案是 Meta Muse Glimmer 30B 跑在 NVIDIA RTX PRO 4000 Blackwell SFF(功耗帽 70 瓦)上。一张卡同时承载目标模型、一个独立的视觉投影层、一个五层 DFlash drafter 和 262,144 token 的上下文槽位。代码任务跑到 84.64 tok/s。在代码、散文、推理和基础设施混合负载下,跌到 38.34 tok/s。当 KV 缓存真的填满 262,116 个输入 token 后,解码再次跌到 21.56 tok/s。
相同的权重。相同的 GPU。相同的 drafter。三台完全不同的机器——取决于你在让它们生成什么,以及光标在内存里的位置。
有了投机解码,tok/s 不再纯粹是硬件跑分。它也是可预测性跑分。
这就是有用的结论。DFlash 不只是让这个模型变快了。它改变了吞吐量到底衡量什么。
DFlash 不是更快的 Glimmer
Muse Glimmer 30B 是一个稠密模型,约 29.6B 参数,52 层,原生 131,072 token 上下文,可扩展到 262,144。「稠密」在这里是关键:每生成一个目标 token,整个模型都被激活。没有 MoE 那种只跑一小部分参数的捷径。
DFlash 坐在它旁边。drafter 有五层,并行准备一个候选 token 块。在这个 llama.cpp 配置中,n_max=15 意味着至多 15 个草稿候选 token 围绕一个 16 token 块。Glimmer 随后用完整目标模型验证那块。候选 token 只有在与目标模型的续写完全匹配时才存活。第一个不匹配就终止被接受的序列前缀。
drafter 不是盲自动补全。它从目标模型的第 1、13、25、37、49 层接收特征,在提议下一个块之前,将 Glimmer 内部状态的信息注入自己的缓存。这就是 DFlash 论文的核心思路:轻量级块扩散模型并行起草,昂贵的自回归模型做验证。
DFlash 并没有让 Glimmer 的每次前向传播变便宜。它试图用一次前向传播买好几个输出 token。当它猜得准,验证成本就被分摊到一组被接受的序列前缀上。当它猜得差,drafter 和验证工作就成了净开销。
这也是为什么在相同采样器下,投机解码可以无损于目标模型:drafter 提议,目标模型始终是权威。一个弱的 drafter 应该降速,而不是降智。如果输出质量发生实质性变化,先怀疑量化、采样差异或实现 bug,而不是怀疑投机解码本身。
代码和规划是不同的负载
在相同的 Q5_K_M 目标模型上,常规解码 17.98 tok/s。DFlash 长代码任务 80.87 tok/s,4.50 倍加速。256K 最佳调优跑到了 84.64 tok/s,token 接受率 38.67%。
然后我跑了混合负载:代码、散文、推理和基础设施。吞吐量跌到 38.34 tok/s,全局接受率跌到 14.41%。
不同负载的吞吐量对比:
• 常规解码(代码):17.98 tok/s,接受率不适用——仅目标模型
• DFlash(代码):80.87 tok/s,接受率 36.18%——可预测的结构化输出
• DFlash(最佳调优代码):84.64 tok/s,接受率 38.67%——256K 槽位,视觉模块已加载
• DFlash(混合 agent 工作):38.34 tok/s,接受率 14.41%——代码、散文、规划、基础设施
• DFlash(KV 缓存已满):21.56 tok/s,接受率随负载变化——262,116 输入 token
代码对投机解码异常友好。语法、缩进、API、重复标识符、样板代码和局部模式约束了后续 token。在 for (int i = 0; i < 之后,合理的续写并不多。drafter 经常能在分叉前走好几个 token。
规划则完全不同。在「最安全的迁移策略是」之后,多种续写可以同时成立。drafter 选一个,Glimmer 选另一个。两种续写都不一定错,但一个精确 token 匹配的验证器看到不匹配,就丢弃剩余推测前缀,开启新一轮。
这意味着一个 agent 至少有两种吞吐量体制。在实现阶段——重复编辑、代码补全、JSON、命令行和受 schema 约束的工具调用——可以飞。在架构设计、模糊推理或对话解释阶段,DFlash 可能花更多时间在问目标模型:「你确定是这个确切的路径?」
一个单一平均值掩盖了这种差异。如果一个 agent 基准测试包含 80% 的代码生成,DFlash 看起来逆天。如果它包含长规划轨迹和分叉的散文,同一套配置看起来只是还行。两个结果都不是假的。负载分布本身就是基准测试的一部分。
接受率陷阱
最直观的指标是接受率:提议草案 token 中通过了验证的比例。它有用,但单看它会指向错误配置。
不同最大草案长度对比:
• 4 token:接受率 47.46%,吞吐量 34.50 tok/s
• 8 token:接受率 27.00%,吞吐量 40.54 tok/s
• 12 token:接受率 20.33%,吞吐量 42.22 tok/s
• 15 token:接受率 17.99%,吞吐量 47.20 tok/s
草案 4 在接受率上赢了,在吞吐量上输了。草案 15 的接受率低得多,但生成速度快了 36.8%。更长的块提议了更多错误 token,但被接受的序列前缀更有效地分摊了每次昂贵的目标模型验证。
更好的配套指标是平均接受长度,通常写作 τ:每次目标模型前向传播平均获得多少个连续推测 token。在我的代码运行中,τ 达到了 6.39。这才是更接近经济学问题的数字:一次昂贵的验证买了多少输出 token?
即便如此,τ 单独也不够。drafter 延迟、验证成本、批次形状、后端同步和 KV 缓存位置都会影响结果。但 τ 比裸接受率更好地解释了机制。
CPU 在悄悄给 GPU 拉手刹
最重要的性能修复不是新的量化方案,而是移除了一个边界穿越。
drafter 在 GPU 上运行,但贪心 token 选择仍然经过 CPU 侧路径。这在一个价值全在于便宜并行化的循环中强制引入了 device-to-host 传输和同步。GPU 可以完成它的矩阵运算,然后等着主机选 draft ID。
llama.cpp GPU-argmax 改动将 ggml_argmax 直接加入 drafter 的后端计算图。我的调试追踪显示,启用 DFlash 后计算图从 179 个节点增长到 180 个。选出的 draft token 留在后端路径里,而不是让 CPU 当节拍器。
在混合五组 256 token 测试中,仅这一个改动就让吞吐量从 36.30 升到 38.34 tok/s,提升 5.6%。这个数字听起来不大,但当负载变得足够可预测、DFlash 能叠加这个节省时,效果就放大了。在最终的代码配置中,目标模型单独跑了 17.98 tok/s,而 DFlash 加 GPU argmax 跑到了 80.87 tok/s。
这个教训比这个模型更广。投机解码器是一个流水线,不是一个复选框。目标模型可以被优化到极致,但一个微小的主机侧操作会让整个草案循环串行化。如果利用率、接受率和墙上时钟吞吐量不一致,先检查计算图边界和同步,再考虑买更大的 GPU。
两个集成 bug 让 NVFP4 看起来比实际更差
NVFP4 最初产生了错误的输出。轻松的结论是 Blackwell FP4 不成熟或检查点有问题。张量对比讲了一个不同的故事:采样权重的相关性约 0.993,而嵌入层和语言模型头部的相关性更高。打包的权重不是主要问题。
我找到了两个独立的集成故障:
1. 通用压缩张量 NVFP4 转换路径跳过了 Muse 特有的 Q/K RoPE 置换和常量 Q/K 规范的构建。 一个模型可以成功加载但仍然在语义上错误——如果架构特定的张量变换被省略了。
2. Muse 运行时加载了 *.scale 张量但没有将其全部传入计算图。 Q、K、V 和输出投影用了它们的 scale,但注意力门控以及 FFN 的上、门、下矩阵没有用。九行改动恢复了这四条 scale 路径,停止了激活值爆炸。
修复之后,NVFP4 生成了干净文本,并在一个混合配置中成了吞吐量领先者。这一点很重要,因为「模型能跑」是对新量化格式的一个很弱的测试。你需要语义输出、激活值健康检查、逐张量转换对比、困惑度,以及一个有代表性的生成负载。
运行时 bug 可以假装成糟糕的量化。转换 bug 可以假装成糟糕的模型。采样默认值可以假装成慢速的 drafter。推理工程很大程度就是拒绝第一个看似合理的解释。
最快的量化还是输了
实验性的混合方案将原生 NVFP4 与 Q4 注意力处理和更高精度的头部组合在一起。它在代码上跑到了 94.36 tok/s,接受率 38.69%。这是当晚最快的结果。
它也在 WikiText-2 困惑度上表现更差:5.6493 对 Q5_K_M 的 5.5420。速度提升是真的,质量损失也是真的。对一个生产编码 agent,正确的决定是拒绝它。
各量化方案对比:
• Q5_K_M:困惑度 5.5420±0.1179,代码 80.87 tok/s,接受率 36.18%——选中
• Meta kquant(17 GB):困惑度 5.5620±0.1182,代码 83.92 tok/s,接受率 34.68%——速度备选
• Q4:困惑度 5.5797,代码 82.00 tok/s,接受率 31.77%——密度良好
• Hybrid NVFP4/Q4:困惑度 5.6493,代码 94.36 tok/s,接受率 38.69%——因质量被拒绝
• NVFP4(BF16 头):困惑度 5.6937,代码 69.10 tok/s,接受率 26.41%——拒绝
相反的极端也输了。Q5_K_XL 将困惑度从 5.5420 改善到 5.5278,仅 0.26%。这个差异远小于测试的 ±0.1179 不确定性。但在混合负载下,它从 38.34 跌到 33.50 tok/s,大约慢了 13%,且 DFlash 接受率更差。
所以困惑度赢家买入了一个在统计上没有说服力的质量改善,付出了两位数的吞吐量代价。Q5_K_M 落在帕累托前沿上:比更小量化方案更好的实测质量,比 Q5_K_XL 好得多的 DFlash 兼容性,还剩足够 VRAM 给 256K 上下文加视觉模块。
为什么量化标签不等于模型
「Q4 vs Q5」对现代推理工作来说太粗糙了。一个模型不是一块均匀敏感的数值。嵌入层、注意力投影、门控、前馈张量、规范层和 lm_head 对量化的容忍度各不相同。
重要性矩阵(imatrix)校准通过代表性激活来测量哪些权重真正重要。混合量化方案则在错误真正有害的地方分配更多比特,在无关紧要的地方去掉它们。Unsloth 的动态 GGUF 变体、K-quant 和混合 NVFP4 实验,都是这个思路的不同表达:文件的平均每权重比特数告诉你大小,但不告诉你这些比特被分配得多聪明。
Blackwell 原生 NVFP4 增加了一个新维度。硬件支持可以让 4-bit 算术极快,但格式支持不会抹去架构敏感性。把大的嵌入层或 lm_head 保留为 BF16 可以维持质量,但占用几个 GB。量化它们节省 VRAM,但可能不成比例地损害 logits。对注意力和 FFN 一视同仁可能浪费质量或速度。最好的方案是张量感知的、架构感知的,并且用实际 drafter 测量过。
DFlash 让这种耦合更紧了。两个困惑度几乎相同的目标量化方案,可能暴露出不同的隐藏特征给 drafter,导致不同的接受长度。量化质量和投机兼容性是两个独立的轴。困惑度单独无法选出赢家。
一个隐藏的采样默认值吞掉了 8%
Meta 推荐 Muse Glimmer 使用 temperature 1.0、top-p 0.95、top-k 64。我三个都设了。服务器仍然应用了 llama.cpp 的默认 min-p=0.05。
用 min-p=0 移除这个未被请求的第四个过滤器后,256K 视觉版最终结果从 78.29 升到 84.64 tok/s。接受率从 36.18% 升到 38.67%。同样的模型。同样的量化。同样的 GPU。8.1% 的提升,来自让采样器匹配模型的文档默认值。
采样决定了哪个候选 token 成为权威,因此它也决定了 drafter 的序列前缀是否存活。一份报告如果写了 temperature 但省略了 top-p、top-k、min-p 和草案采样,是不可复现的。
256K 上下文:没填满就不算测过
一个服务器接受 --ctx-size 262144 几乎不说明任何问题。KV 内存可能懒分配,CUDA 工作缓冲区在 prefill 期间才增长,长缓存下的注意力机制还会改变解码成本。「能加载」不是压力测试。
我填满了它:
• 输入:262,116 token,随后输出。
• 结果:没有 OOM。
• Prompt 处理速度:371.24 tok/s。
• 远端缓存解码:21.56 tok/s。
• VRAM:22,920 / 24,467 MiB,即 93.68%。
• 剩余 VRAM:1,547 MiB。
独立的量化视觉投影层也保持加载,真实图像请求通过了。最终的短代码运行在 256K 配置下不比等效的 128K 配置慢——因为更大的空槽位在 Q8 KV 下开销很低。远端的情况不同:一旦缓存被真正占据,解码跌到了 21.56 tok/s。
这就是仅加载表格掩盖掉的长上下文税。上下文容量和上下文性能,是两个不同的声明。
最终配置
胜出的方案不是每个维度上最快的组件,而是最好的完整系统:
• 目标模型:Muse Glimmer 30B UD-Q5_K_M
• 上下文:262,144 token
• 视觉:量化 Muse mmproj 加载于同一 GPU
• 投机解码:dflash-kquant,n_max=15
• KV 缓存:目标模型 Q8,drafter(体量小得多)F16
• 执行:GPU argmax、CUDA graph 优化、batch/ubatch 1024/256、目标模型与草案线程 8/8
• 采样:temperature 1.0、top-p 0.95、top-k 64、min-p 0
• 实测短代码结果:84.64 tok/s,接受率 38.67%
目标 KV 用 Q8 比 F16 更好的权衡:节省了约 740 MiB 同时提升了此配置的吞吐量。drafter KV 保留 F16 仅比 Q4 多约 32 MiB,性能略好。小缓存不应该以与大缓存同样的激进程度去优化。
这与我在任务路由而非供应商路由中使用的原则一致:围绕昂贵的约束来优化系统,而不是对每个组件一视同仁。
DFlash 在哪里闪耀,在哪里暴毙
DFlash 在输出有窄续写空间时表现极好:
• 代码补全和重复性实现
• 结构化 JSON 和受 schema 约束的输出
• 样板代码、测试生成、迁移和可预测的重构
• 命令序列和语法稳定的工具调用
• drafter 的目标模型特征对下一个块有强约束的领域
在多种续写路径都合法时表现变弱:
• 架构规划和开放式推理
• 创意散文和对话式回答
• 高温度生成
• 频繁切换话题或插入检索结果
• 非常长的已占据 KV 缓存——此时每次目标模型验证本身就变得更贵
还有运维成本。drafter 消耗模型内存和它自己的 KV 缓存。视觉模块消耗更多。更长的草案块可能浪费算力。后端支持必须让循环保持在设备上。目标模型和 drafter 必须在词汇表、架构钩子和采样行为上一致。一个 1.6 GB 的伴生模块在代码上给 4.5 倍加速,是划算的。同一个伴生模块在发散性对话上给边际收益,可能就不值了。
正确的问题不是「DFlash 能用吗?」,而是「我的生产输出中有多大比例足够可预测,让 DFlash 分摊目标模型的前向传播?」
一份有用的投机解码基准测试必须报告什么
单个 tok/s 数字现在信息不足。至少报告:
• 目标模型和确切量化配方。包括混合张量、imatrix 使用、精度例外和文件大小
• Drafter 和块长度。「启用了 DFlash」太过模糊
• 任务分布。分别报告代码、规划、对话、工具调用和混合 agent 工作
• 接受率和平均接受长度 τ。其一无其二可能误导
• 所有采样参数。包括隐藏默认值如 min-p
• Prefill 和解码分开。不要把 prompt 摄入与生成混在一起
• KV 缓存位置。空的 256K 和已占据的 256K 是不同的负载
• 真实填充后的 VRAM。加载时的分配不够
• 后端路径。说明草案 token 选择是否留在 GPU 上
• 质量与速度并行。至少困惑度加一个有代表性任务评估
这就是可预测性调整吞吐量:在声明的输出分布、草案配置、采样器、量化和 KV 缓存位置下测量的有效生成速度。它不如一个英雄数字方便。但它离生产现实近得多。
关键结论
• DFlash 没有加速 Glimmer 的单次前向传播。它减少了目标模型需要运行的次数——一次前向传播拿到多个验证通过的 token
• 同样的 GPU 和权重,代码跑 84.64 tok/s,混合 agent 工作跑 38.34 tok/s。输出的可预测性是吞吐量的一部分
• 只看接受率选择了错误的草案长度。草案 15 比草案 4 更快,尽管接受率低得多
• 将 drafter argmax 从 CPU 移到 GPU 计算图,从最热的循环中移除了一个同步边界
• 最快的 NVFP4 混合方案输了,因为困惑度更差。Q5_K_XL 输了,因为统计上很弱的 0.26% 困惑度改善付出了约 13% 吞吐量代价
• 量化标签掩盖了张量层级的决策。imatrix 校准、精度例外、架构变换和 DFlash 兼容性都很关键
• 一个隐藏的 min-p 默认值吞掉了 8.1%。采样是性能配置的一部分
• 256K 配置在 93.68% VRAM 下承受住了真实的 262,116 token 填充,但远端缓存解码跌到了 21.56 tok/s
下次有人贴出 tok/s 数字,问他:模型生成了什么?每次目标模型前向传播有多少个草案 token 通过了验证?草案选择留在 GPU 上了吗?光标在 KV 缓存的哪个位置?没有这些事实,那不是基准测试——那只是一张截图。
原文:piszczek.pl/blog/dflash-chan…
#DFlash #投机解码 #本地LLM

Michał Piszczek retweeted

BLACKSTONE MULLS $36B ANTHROPIC CHIP FINANCING
Blackstone, one of the world’s largest alternative asset managers, has reportedly begun early talks with investors about arranging at least $36B in debt to finance Anthropic’s use of Google’s custom AI chips.
If completed at the proposed size, it would surpass the $35B package arranged by Apollo and Blackstone two months ago, which financed Anthropic’s use of Google chips across five data centers.
The size, structure and Blackstone’s role are still under discussion and could change.
Source: Bloomberg

Michał Piszczek retweeted

That work will change around AI is inevitable, but the way work changes is not. I think firms with a lack of imagination will see AI as an opportunity to cut people, but firms with the vision to expand human roles & make them better with AI will thrive. danshapiro.com/blog/2026/07/…
Michał Piszczek retweeted

so what do you do for the closed ones? lean harder on tool calls and outputs, or just accept less signal?
Michał Piszczek retweeted

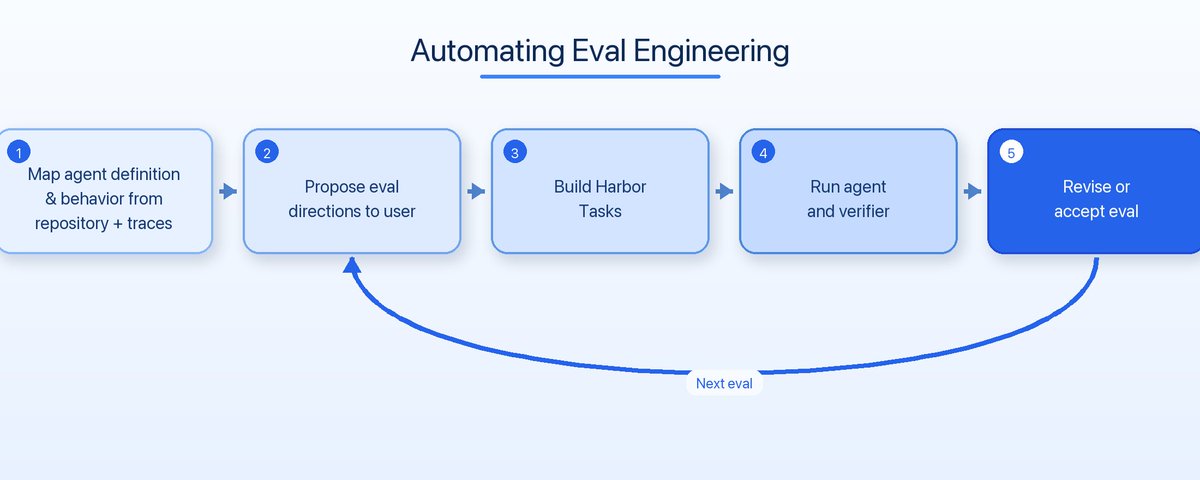
If you train or serve models, you depend on MLIR whether or not you have ever written a line of it.
XLA lowers through it, Triton is built on it, Mojo is MLIR-native, and Torch-MLIR, IREE, and ONNX-MLIR exist to funnel their respective frontends into it.
The reason a single piece of infrastructure ended up underneath so many otherwise-competing stacks is worth understanding, because it explains a lot about how modern ML compilers are actually built, and where their seams are.
This post is a tour of MLIR: what it is, the dialect idea that makes it different, how a tensor operation is progressively lowered to machine code, and what the infrastructure does and does not give you.
hiraditya.github.io/posts/ml…

Michał Piszczek retweeted

The only thing worse than having the CEO knee-deep in building stuff with AI is not having the CEO knee-deep in building stuff with AI.
Michał Piszczek retweeted

oh yeah totally agree. Porque no los dos?
you should give your dev ai agent the same access you would give real devs — ability to copy some prod data but otherwise have it work against a dev database.
Michał Piszczek retweeted

Claude Code just raised weekly limits by 50%.
This puts Claude Code rate limits on par with Codex.
I cancelled my Max plan twice over rate limits.
SpaceXAI deal doubled the five hour limits.
Removed peak hour limits.
Now weekly limits up 50%.
Three rate limit increases in two weeks.
Anthropic is not playing around anymore.
Claude Code with Claude Opus 4.7 now has unlimited limits.


Michał Piszczek retweeted

Introducing ChatGPT Health — a dedicated space for health conversations in ChatGPT. You can securely connect medical records and wellness apps so responses are grounded in your own health information.
Designed to help you navigate medical care, not replace it.
Join the waitlist to get early access.
openai.com/index/introducing…


Michał Piszczek retweeted
StackOverflow graph of questions asked per month.
Holy shit.

ALT A graph of stack overflow questions asked per month. It’s almost a perfect curve starting at 0 on the far left, in 2009, peaking in the middle in 2017 at about 200,000, then dropping down to near 0 today on the right.


Michał Piszczek retweeted

🧟♀️ After days and nights of toil: FrankenPHP 1.10 is alive! 🧟♂️
The creature is awake and brings unprecedented power to your #PHP applications:
🐘 PHP 8.5 support
🪽 New mercure_publish() function for easy real-time broadcasting with @MercureRealTime
⚙️ Enhanced extensions & custom workers (hello high-performance gRPC and WebSockets servers!)
Downloads and changelog, right from our laboratory: github.com/php/frankenphp/re…

Michał Piszczek retweeted

#Angular v20 is here! 🎉
Here's the important stuff ⬇️

ALT The Angular logo, a stylized letter 'A' in purple, alongside the text "VERSION 20" also in purple.
Michał Piszczek retweeted

🌟 Symfony 7.3.0 released
➡️ symfony.com/blog/symfony-7-3…

Michał Piszczek retweeted

Wstrząsające relacje dawnych znajomych kandydata PiS. ⚠️ Deklarują, że są gotowi złożyć zeznania przed sądem❗ Czytaj więcej ➡️ wiadomosci.onet.pl/wybory/wy…
