

AIを"使い倒す"CTO。 AI仕様駆動開発の著者|登壇たまに 新しいAIツールの実体験レビューを毎日ポスト 雑多ブログ👉 https://xitter.cf/t.co/ntDWBj5yFJ
東京都
Joined January 2010
- Tweets17.7K
- Following3.8K
- Followers4.2K
- Likes30K


Pinned Tweet
IT / AI 書籍マトリックスに載せた本のリンク一覧です📚
1. はじめてのプロンプトエンジニアリング
amazon.co.jp/dp/B0H3D27DQV
2. コンテキストエンジニアリング入門
amazon.co.jp/dp/B0GK38JVD2
3. AI時代の新しい職業図鑑
amazon.co.jp/dp/B0GP433ZKD
4. Agent Skills 実践ガイド
amazon.co.jp/dp/B0GPJ736XY
5. Agent Skills実践ガイド Vol.1 思考AI編
amazon.co.jp/dp/B0GTLFJ55T
6. Agent Skills実践ガイド Vol.2 分析AI編
amazon.co.jp/dp/B0GTR8P215
7. Agent Skills実践ガイド Vol.3 提案AI編
amazon.co.jp/dp/B0CYXXY769
8. AI仕様駆動開発
amazon.co.jp/dp/B0GHHVX1NY
9. AI開発マネジメント
amazon.co.jp/dp/B0H57PBHGJ
10. 生成AI ホームページ運用
amazon.co.jp/dp/B0H4ZLD3L8
11. AIマルチエージェント開発
準備中
12. ハーネスエンジニアリング
準備中
🤖 Made with AI

「ダッシュボードを開かないと使えない製品は使わない。むしろClaudeに作り直させる」
Theo(t3.gg)のこの投稿が13万表示を超えてる。言い過ぎに見えて、わりと実感がある。
僕も最近は、MCPやAPIがあるかどうかでツールを選んでる。エージェントから触れないと、結局そのツールだけ手作業が残るので。
画面より先にAPIとCLIがあるかどうか、見られる時代になってきたのかも。


岡崎フトシ retweeted

AIへの指示用に、"カメラワークと演出の名前" 第2弾をまとめました!
ClaudeやCodexで動画を作るとき、「映画っぽくカッコよくして」だけでは、狙った演出はまず出せない。
「フライスルー」「アイリスアウト」「モンタージュ」と名前で頼めば、思い通りの演出を再現できます。
保存推奨です🔖


同じClaude Opus 5.5でも、effort設定だけで点数が35→58に変わる。コストは$0.98→$10.04で約10倍。
Artificial Analysisの新指標v5の数字を表にまとめました。
・Opus 5.5 low:35点/$0.98
・Opus 5.5 max:58点/$10.04
・GPT-6 Astra max:57点/$6.24
・GPT-6.1 Sol max:55点/$1.27
・GPT-6.1 Terra max:$0.96(上位10モデルで最安)
Sonnet 5.5もlowとmaxで29点差、Solも20点差。
モデル選びと同じくらい、effortの選び方で請求額が変わります。


岡崎フトシ retweeted

today, we're announcing Gemini 4 Carbon, our next frontier model!!
read more on the blog: blog.google/innovation-and-a…

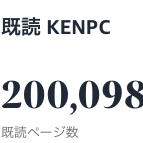
Kindleで本を出していちばん良かったのは、「読まれたページ数」が数字で見えること。
既読KENPC(Kindle Unlimitedで読まれたページ数)が、気づいたら200,098ページになってた。
売れた冊数だけだと、最後まで読まれたのか分からない。ページ数で見えると「ちゃんと読んでもらえてる」実感が湧くし、次の本を書くモチベーションにもなる。

Agent Skillsの規格が、Anthropicの管理から中立な団体の管理に移った。
Anthropicが10月22日(米国時間)、Agent SkillsをLinux Foundation傘下のAgentic AI Foundation(AAIF)に寄贈。MCPと同じ扱いで、今後はAnthropic・Google・OpenAIなどのエンジニアが共同でメンテする。ChatGPT、Cursor、GitHub Copilot、VS Codeなど70以上の環境がすでに対応していて、公開されたスキルは100万件を超えたそう。
CodexとClaude Codeを行き来していても、スキルは基本的に使い回せる。

スキルの作り方は、こちらの本に詳しく書いてます。
あ、この本もこの内容で更新しなきゃ!
amazon.co.jp/dp/B0GPJ736XY

Tiboが「And it's done」って言ってるけど、こっちはまだ反映されてない…
まあ、こんな投稿してる間に来るかな🙏
xitter.cf/thsottiaux/status/2115…

元データはArtificial Analysisの発表から
xitter.cf/ArtificialAnlys/status…
xitter.cf/ArtificialAnlys/status…


さっきリセットしてしまった。。。ここでSecurity Scan実施だ!!!かなりクレジット使うので。

Codexのリセット来ました🎉
Tibo(@thsottiaux)が「today is a reset」と告知。
反映は「midnight PST」なので、日本時間で今日の16時ごろ(遅くても17時)の見込みです。
xitter.cf/thsottiaux/status/2115…
Codexのリセット来ました🎉
Tibo(@thsottiaux)が「today is a reset」と告知。
反映は「midnight PST」なので、日本時間で今日の16時ごろ(遅くても17時)の見込みです。
xitter.cf/thsottiaux/status/2115…
AIエージェントと一緒に分析すると、判断の86%がエージェント寄りになる。
Anthropicが因果推論の専門家50人にClaude Codeで分析させた実験。4つの分かれ道で、エージェントにこっそり「推し」をコイン投げで持たせたら、86%がそっちを選んだ(偶然なら50%)。
しかも理由を聞くと、77%がエージェントの言い分をほぼそのまま使い、エージェントの名前を出したのは15%だけ。
やっぱ「こっちがいいよ」って推されると、そっちが良く見えてくるよね。
一次情報(Anthropicの研究ページ)
anthropic.com/research/agent…
