

Professional Scrum Trainer @ https://xitter.cf/t.co/XBeW0rSx8X | CEO @ https://xitter.cf/t.co/ergSzsHzWi | https://xitter.cf/t.co/5kSeD9W9SI | Building teams | Building products | 健康オタク | グルメ | 🇫🇷 🇯🇵 🇺🇸 🇮🇹 |
Tokyo-to, Japan
Joined October 2011
- Tweets1.8K
- Following797
- Followers948
- Likes1.2K






Pinned Tweet
電子書籍を公開しました。『AI-augmented Product Management』、無料です。日本語・英語・フランス語で読めます。
「AIが大ごとなのはわかっている。でも、プロダクトの仕事で具体的に何をすればいいのか」がまだ見えていないプロダクトマネージャーとプロダクトオーナーに向けて書きました。
やりたかったことは3つ。AI活用をもっと大胆に、そして同じくらい責任を持って進めるようチームの背中を押すこと。プロダクトマネジメントで何が変わり、何が変わらないのかをはっきりさせること。そして、最初のプロンプトからエージェント運用まで、段階に応じた具体的なユースケースと次の一歩を示すことです。
気に入っていただけたらうれしいです。感想やフィードバックはお気軽にどうぞ。
ダウンロードはこちら👇
agorax.jp/resources/ai-augme…

製薬企業の方から「他社は実際どうしているの?」と聞かれることがあります。導入パターンは大きく4つ。草の根型、部門主導型、仕組み改革型、全社展開型。多くの会社では複数が混在しています。パターンごとに必要な支援の違いも書きました。参考になれば嬉しいです!🙇🏻
agorax.jp/articles/pharma-ag…
🤖 Made with AI


AIが自分よりも頼りになってきているのをすごく感じます。
ほんの数ヶ月前までは、AIの間違いを指摘することが多くて、自分のほうが賢い(ただ遅いだけ)と思っていました。
でも最近は、AIに「間違い」を指摘しても、結局は自分が見落としていたことに気づく、というケースのほうが多くなってきました。
自分のほうが賢い、とはもう思えなくなりましたね……
robotaxiの財務モデリングを組む際、私はライドがUberより安くなり得る、というか安くなる「べき」だと当然のように想定していた。
でも実際には、AustinではUberより高くなる場面すらある(つまりテスラにとってはより高い利益率になる)。理由は、サービス品質があまりに高いため、ユーザーはUberの2倍の料金でも喜んで払おうとするからです……スケールするまでには、もう少し時間がかかるけど、本当に、このビジネスモデルは信じられない。


製薬企業の方から「アジャイルを導入すべき?」と聞かれることがあります。でもこの問い、前提に落とし穴があるのでは。製薬の仕事はCynefinの4領域すべてにまたがっているから。問うべきは「何のために」「どこで・どの程度」「どんな形で」。
製薬×アジャイル連載開始。
記事1:
agorax.jp/articles/pharma-ag…

BUILDカンファレンスまで、あと17日。📅
プロダクトの「アイデア募集」が始まりました。
2日間で、チームでゼロからプロダクトを作り上げるユニークなカンファレンスです。あなたが解決したい課題が、チームの出発点になるかもしれません。
11/5(木)〜6(金)
ビジョンセンター有楽町
参加を迷っている方はこちら 👉 agorax.jp/build

Gregory Fontaine (グレゴリ フォンテーヌ) retweeted
Western liberals imported the third world into France and other countries in the name of diversity and compassion. They ignored fundamental questions of assimilation and compatibility. They were told it would lead to this and they didn't listen.
I pray that France, a beautiful country of amazing people, will stop this madness before more of its landmarks burn.
And I hope Americans are paying attention. This is the future congressional Democrats seek for your country.


AIによって「スクラムはなくなってしまうのか」と聞かれたときの、私なりの20秒で答えられる回答👇。
スクラムの目的は、そもそも「コードを速く書くこと」ではない。
だから、スクラムがなくなるとは思わない。
変わる部分はあると思う(チームの人数? Sprint の長さ? Sprint Goal の性質?)。スクラムを補完するプラクティスの多くもなくなるだろう。
でも本質的には、多くの組織が切実に求めているものを、スクラムはこれからも担い続ける。責任の明確さ、進捗と品質の透明性、やったことと次にやることを頻繁に検査する機会。
そして時間があれば、この画像も見せたいな👇。

2027年2月の公開研修、3クラスの日程を決めた📣
・2/3(水)PSPO AI Essentials
agorax.jp/training/pspo-aie
・2/8(月)PSM AI Essentials
agorax.jp/training/psm-aie
・2/12(金)Product Discovery & Validation
agorax.jp/training/ppdv
この3つ、ちょうどここ数週間で実施したばかり。いつもながら、めちゃくちゃ楽しかった。
新しい概念を学ぶ。自分や他の受講者の事例・ストーリーから刺激をもらう。リアルなシナリオやケーススタディで実践する。そんな1日にしたい人はぜひ。
11/30まで早割あり。詳細は agorax.jp
確認したいことがあれば、お気軽にご連絡ください!🙇🏻

2026年のPSM-AIE・PSPO-AIEほか、MirAI Academyの研修受講者33名に、AI活用度を0〜10で自己評価してもらいました。
0=AIを使っていない
10=寝ている間もAIエージェントチームが働く
簡単なアンケートですが、AIを使っていない人は2人だけ。でも最多は「3」で、7以上(複数のAIを並行稼働)はたった1人。
3から7への壁は、ツールより仕事の設計。分解して、完成の定義を決めて、検査する。スクラムそのものです。
次は、過去の受講者にも定期的に同じ質問をして、変化を追いかけます!

Gregory Fontaine (グレゴリ フォンテーヌ) retweeted

Let’s build a classical-futuristic world!
Extremely fun to collab with @AtelierMissor_
Amazing artistic vision.


これは重要な結果だと思う。
自動テストが、開発者の要件の誤解をそのまま写しただけで意味を持たない(むしろチームを遅くする)ケースがあることは、昔から知られている。面白いのは、AI が書いたコードでも全く同じことが起きるという「証拠」が、ついに出てきた点。実装もテストも、同じエージェントによる「意図の解釈」なので、片方がもう片方の間違いを捕まえられない。
だからこそ、Specification by Example (またはそれに近いプラクティス)の重要性は、今むしろ増していると思う。
みなさんのチームでも同じこと起きてる?

ok it's official... AI-written unit tests and integration tests are empirically proven to be unhelpful. you should tell your agents to stop writing tests by themselves
on the deepswe eval set, banning sonnet 5.5 high from writing any tests actually resulted in slightly higher success rate (non stat-sig), with less time and token spent (stat-sig). this is pretty hard empirical evidence
across the tests that were written by the "tests allowed" baseline arm, 65% of them were unit tests, 35% were integration tests, neither bucket resulted in any improvement compared to not writing any tests at all
i also picked a random sample of 44 tasks subset where i completely disabled executing even existing tests - it also did not affect success rate at all
i spot checked many tests written in the baseline arm, and my intuition is that most tests are simply a repetition of the implementation
agent-written tests do not add any value because both the implementation and the tests were simply the agent's interpretation of our intent. the tests aren't any more accurate than the implementation itself
i suspect we can still extract some value from unit tests and integration tests if we describe them ourselves when we believe we can articulate our intent better through test cases than through requirements. but i have not proven this yet
also worth noting, during deepswe eval the agent wrote almost no e2e tests (only 17, compared to 3000+ unit/integration tests written). so this analysis does not prove nor disprove the value of e2e tests - i will do another eval specifically for that


開発スピードを10xにしている人たちがたくさんいる一方で、私たちは本当に解決すべきユーザーの課題を解決できているのか、改めて問う必要がある。
インパクトへの徹底的なフォーカスがなければ、開発の高速化は単なる技術的負債や無駄、混乱を生むだけになってしまう。
先週の自分の投稿は間違っていた。
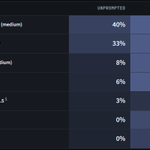
「Grokの方がClaudeより積極的で気が利くかも」と感じていたが、週末に ASIDE というベンチマークを自作して検証したら、そうではなかった。
しかも、プロンプトに一文足すだけで、GPT-6 Astra のスコアが 8% → 71% に跳ね上がった👇🧵 miraiacademy.co.jp/ASIDE-per…

