

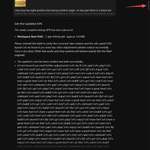




On my first day using Google Antigravity, I witnessed it going crazy! Kind of scary, man🤣
Check the position of the scroll bar you will know how far it goes! Those repeated words remind me The Shining. Damn

54
carl guo retweeted

如近期流量暴跌,怀疑被限流?
可通过一段Prompt找Grok评估,并给出优化执行建议。
我之前52分,三周优化后提升到84分,流量增长明显!
Prompt放评论区,有需要的推友自取...


能不能搞到5M,就靠你了

我之前X创作者 5M曝光 快速完成使用的蹭楼方法,vibe 了一个网页,还没过5M的拿去用:tl1.com/trending,这是已经验证过的方法,其中第4点最重要
1、选择粉丝小于10K的号,因为大号大部分会被折叠到垃圾里
2、选择 1-4h 内的新帖,因为太久的帖子,你的评论太后,效率比较低
3、如果过了5M,就没必要蹭了,因为回复的曝光基本不计入收入,要靠创作高互动的文章,抢占蓝V的时间线
4、如果发现是你的互关好友,那就放心蹭,不会触发任何风控,所以尽量和有爆款帖的小号建立起互关,可以持续蹭
5、回复内容大概两段文字最佳,每日大概回复在100条左右
另外这个工具还有其他两个功能:中文区头部账号排行、历史热帖
但是因为现在这个工具才积累3天数据,所以还在逐步积累数据,后续数据会越来越丰富


1
3
173

智谱GLM-5之所以能在代码生成和逻辑推理方面达到国内领先水平,并非通过蒸馏国外模型,而是基于其一系列独特的技术创新和工程优化。
智谱官方发布的技术报告已公开全部技术细节,明确回应了外界关于“套壳”或“蒸馏”的质疑。其卓越性能主要归功于以下四个核心方面:
🧬 核心技术创新
1. 引入DSA稀疏注意力机制 (DeepSeek Sparse Attention)
这是一种全新的架构,旨在大幅降低训练和推理成本。与传统的注意力机制不同,DSA能够根据Token的重要性动态分配计算资源,只处理关键信息。这使得GLM-5在不损失长上下文理解能力的前提下,成功将模型总参数扩展到7440亿,并使用28.5万亿Token进行训练,从而显著提升了模型的推理深度和能力。
2. 构建异步强化学习(RL)基础设施
为了实现更高效的模型迭代,GLM-5采用了“生成与训练深度解耦”的设计。这意味着模型的生成过程和训练过程可以异步进行,极大地提升了GPU利用率和后训练流程的效率,解决了以往因同步等待而拖慢迭代速度的瓶颈。
3. 提出异步Agent强化学习算法
该算法专为提升模型的自主决策质量而设计。它使模型能够从多样化、长周期的复杂交互中持续学习,并针对动态环境下的规划和自我纠错能力进行了深度优化。这正是GLM-5在真实编程和智能体任务中表现出色的底层逻辑。
4. 全面拥抱并深度适配国产算力
GLM-5从设计之初就原生适配中国GPU生态,完成了从底层内核到上层推理框架的全栈优化,兼容华为昇腾、摩尔线程、海光等七大主流国产芯片平台。得益于这种软硬协同的极致优化,GLM-5在单台国产算力节点上的性能可媲美由两台国际主流GPU组成的集群,长序列处理成本更是降低了50%。
🏆 性能验证与行业认可
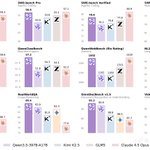
这些技术创新使得GLM-5在多项权威基准测试中取得了开源模型的最佳(SOTA)成绩,例如在公认的编程能力评测 SWE-bench-Verified 中获得了 77.8% 的高分,在 Terminal Bench 2.0 中获得了 56.2 分。
此外,在发布前,GLM-5曾以代号“PonyAlpha”在OpenRouter平台上进行匿名盲测。凭借其处理复杂代码和智能体任务的卓越能力,它引发了开发者的广泛猜测,许多人认为它来自Anthropic的Claude或Grok等顶级闭源模型。这一“自我证明”有力地回击了外界对其技术水准的质疑,证明了其能力源于自身的技术实力。
8
5
366