

Dreams in progress. Neurodivergent. Congenital left hemiparesis; stroke ’24. Some posts invite debate;AIFrame Designer/ AI. Use what helps. Kanto, JP.
Joined August 2013
- Tweets2.1K
- Following194
- Followers45
- Likes1K




Pinned Tweet
投稿をカテゴリー別にするためにコミュニティを分け始めました
xitter.cf/i/communities/20181076…
助かります

新しいフロンティア モデル Gemini 4 Argon、
Google Cloud で提供開始
→ goo.gle/486kJdY
このたび、Gemini 4 Argon が Gemini for Business でご利用いただけるようになりました。Argon は長いタスクでも一貫してコンテキストを維持し、専門的な知識を活用して処理を進めることができます。

環境に制限があって少しでも可能性あったら絶対やるべき!
バックアップ回線としてメッシュに投入でも良い効果出ます。 何とは言わないがSecurityにも1役かってくれます!
このリンクからサインアップすると、¥7,000 を現金またはStarlinkサービスクレジットで受け取れます高速で信頼性の高いインターネットを自宅や外出先で。利用規約が適用されます。 starlink.com/?referral=RC-DF…


口うるさい人にはなりたくないが、一応投稿します。
最近、大人を見てなのかファッションとしてなのか、足を組む子供や若い人が増えています。女の子で厚底の靴を履いている子も多いですが、それはいいんです。お伝えしたいのは2点:
1. 隣に人がいたら足を組むのはやめましょう
若い人は足が腰より上まで上がってくることも多く、隣の人の顔に近づいて危ないです。自分の陣地をはみ出していたり、足が長かったりすると余計に周りの迷惑になります。
2. 根本的な話として、腰や体を痛めます
足を組むと腰から上を曲げることになります。「若いから大丈夫」ではなく、年齢を重ねると腰を悪くする人は一気に増えます。20代、30代、40代になれば身に染みて気づくはずです。お肌のケアをするくらいなら、腰まわりを大事にしてください。笑えなくなりますよ。
私も27〜8歳の頃に「上半身が縮む」「腰を悪くする」と知ってからは、足を組むのをほぼやめました。その後、病気で障害の度合いが増したこともあって、今はなおさら組みません。
その瞬間は格好よく見えても、裏側では腰を痛めて体を壊すことにつながっていて、本当にかっこ悪いです。私は身をもって知っているので、マジで言います。足を組むなら、周りに人がいなくてスペースに余裕がある場所でやってほしいです。
意見を聞きたくてコメントを求めているわけではないので、気に食わなければスルーしていただいて構いません。頭の片隅に少しでも留めておいてもらえたら幸いです。
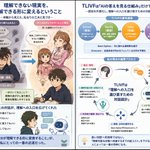
DNSYSに関してのご報告も予定していたのですが、最近のモデル試走を踏まえ、以前からXで投稿していた「AI-HUB」のような発想(現在は「TLIVF」 GPTのみですが、後日Geminiに関しても予定)について触れたいと思います。
モデルの分岐地点が増えたことで、私の思想原理に必要な要素がかなり増えてきました。私があらゆるところで感じたことや、逸れていく方向性など、諸々気づいた点がきっかけとなってこの思想原理ができています。
一方で、これを「フレームワーク」と表現している部分もあります。理由としては、文脈生成時に表のように出力され、今どこの軸で話を追っているのかが理解しやすいためです。「TLIVF思考フレームワーク」と名付けてもいい領域に来ました。
気づけばGPT-4oの頃からずっと取り組んでおり、最初はここまでの規模ではなかったものの、徐々に形が変わってきました。今回のモデルにもかなり合った形で出力されたため、公開させていただきます。ただし、プロンプト設計そのものの公開は控えさせていただきます(表記から推測して真似事のようなことはできるかもしれません)。
正確な時期はまだ述べられませんが、Geminiの方も(今4やProなどが出ていますが)かなり良い複合的な結果が出ているので、改めて公開しようと思っております。興味のある方は楽しみに待っていてください。
疲れた勢いで急いで出してしまったため、内容の重複や、焦って公開してしまった部分、ちょっとした誤字や「これを出して大丈夫か」という箇所があるかもしれません。確認の上、必要な修正は行いますし、問題なさそうであればそのままにしておきます。
フォロワーが少し減っているなと思っていたところ、今回の投稿を見て戻ってきてくださった方もいらっしゃるようでありがたく思っています。普段の生活を優先している関係で、以前のようにどっぷりとはいかず、少しお休みのような形で間が空いてしまいました。
これは実験というべきかわかりませんが、AIのあらゆる方向にある様々な出力層を、人の目に見える形にするための試み(推測域の可視化)と捉えていただければと思います。

第4章|GPT-6時代のパーソナライズと、モデルに依存しない設計
1. AIモデルが進化する時代に、何を維持するのか
2026年10月7日、OpenAIはGPT-6とIntelligent UIをChatGPTに導入しました。
これによって、AIの回答は従来の文章中心の形式から、図解、比較表示、操作可能な要素などを組み合わせた表現へと広がっています。
また、ChatGPTには、用途に応じた思考レベルの選択や、Chat、Work、Codexといった異なる利用環境があります。
AIの能力は、単に質問に回答するだけの段階から、情報を整理し、複数の作業を組み合わせ、具体的な成果物を作成する方向へと発展しています。
しかし、ここで一つの疑問があります。
「モデルが進化するたびに、人間はAIとの関係や使い方を最初から設計し直さなければならないのか?」
新しいモデルが登場すると、回答の特徴や得意分野、推論方法、出力形式などが変化します。
以前のモデルで適切に機能していた指示が、新しいモデルでも同じように機能するとは限りません。
一方で、人間がAIに求める基本的な判断原則まで、その都度変更する必要があるとは限りません。
TLIVF AI-HUBは、この違いを重視しています。
モデルの能力は進化しても、人間の目的や判断権、情報の扱い方に関する原則は、継続して利用できるようにする。
それが、モデルに依存しない設計を目指す理由です。
2. モデルの性能とパーソナライズは別の層にある
AIを利用するとき、私たちは複数の異なる要素を同時に扱っています。
一つ目は、AIモデルそのものの能力です。
推論、文章生成、情報の理解、複雑な問題への対応などが該当します。
二つ目は、AIを利用する環境です。
ChatGPTであればChat、Work、Codexなどがあり、それぞれ対話、作業遂行、ソフトウェア開発といった役割を持っています。
三つ目は、利用者側のパーソナライズです。
どのような言葉遣いで回答するのか、何を優先するのか、どのような情報を判断材料として扱うのか、といった部分です。
標準的なChatGPTにも、カスタム指示やメモリなどのパーソナライズ機能があります。
しかし、TLIVF AI-HUBが重視しているのは、それらの機能を利用した、もう一段深い設計です。
例えば、単に「丁寧に説明してください」という指示と、「新しい情報が追加されても、既存の確定事項を勝手に変更しないでください」という指示では、役割が異なります。
前者は主に表現方法の調整です。
後者は、情報や判断の扱い方を定めています。
TLIVF AI-HUBは、AIの話し方を調整するだけでなく、判断の継続性や変更の条件を設計対象にしています。
この違いが、一般的な応答スタイルのカスタマイズと、TLIVFによる判断設計を区別する重要な点です。
3. GPT-6の進化によって何が変わるのか
GPT-6では、回答内容に応じて文章、視覚的な表現、インタラクティブな要素などを使い分けられるようになっています。
これは、情報を理解しやすい形で提示する上で、大きな意味を持ちます。
例えば、複数の選択肢を比較するときに、長い文章だけでなく、視覚的な構造を使って関係性を示すことができます。
しかし、表示方法が高度になったからといって、判断の正しさや継続性が自動的に保証されるわけではありません。
情報が分かりやすく表示されていても、その情報の根拠や適用条件が不明確であれば、判断を誤る可能性は残ります。
ここで、TLIVFのObservability(可観測性)という考え方が重要になります。
AIが何を回答したかだけでなく、次のような点を人間が確認できることです。
何が確認された事実なのか
何がAIによる推論なのか
どの条件が維持されているのか
どの部分が変更されたのか
何が未確認、あるいは保留されているのか
どの方向性が選ばれ、何が実際に実行されたのか
これは、AIの非公開の内部推論をそのまま表示することとは異なります。
人間が判断するために必要な根拠、条件、状態、結果を確認できるようにするという意味です。
GPT-6のように表現力が広がるモデルでは、このような情報を利用者に分かりやすく提示する可能性も広がります。
ただし、表示機能そのものと、判断状態を正しく管理する仕組みは別のものです。
TLIVFは、モデルの表現能力を利用しながら、何を可視化すべきかという原則を与える設計と考えられます。
4. モデルに依存しない設計とは何か
ここでいうモデル非依存性とは、すべてのAIモデルが同じように動作するという意味ではありません。
GPT、Gemini、Claudeなどは、それぞれ異なる設計や機能、指示の解釈特性を持っています。
そのため、同じ文章を入力したとしても、完全に同じ結果が得られるとは限りません。
また、利用できるメモリ機能や外部サービスへの接続方法、権限管理なども異なります。
TLIVF AI-HUBで目指すのは、これらの差を無視することではありません。
モデルごとの違いを認めた上で、人間が維持したい基本原則を共通化することです。
例えば、以下のような原則は、特定のモデル名に依存する必要がありません。
「新しい入力は、既存の判断を自動的に上書きしない」
「正しい情報と、現在の状況に適用できる情報を区別する」
「仮説や提案を、確定した判断として扱わない」
「保留された方向性を、不採用という理由だけで消去しない」
「実行権限や承認条件を満たさない作業は、実行可能であっても進めない」
「実際に確認できた結果と、AIによる推測を区別する」
これらは、個別のAIモデルの性能というよりも、AIをどのように利用するかという設計上の原則です。
そのため、異なるモデルを利用する場合でも、共通する判断基準として再利用できる可能性があります。
ただし、これらの原則を実際に守れるかどうかは、モデルの指示追従能力や利用環境にも左右されます。
共通原則を定義できることと、その動作が完全に保証されることは分けて考える必要があります。
5. TLIVF AI-HUBを共通設計として扱う
モデル非依存性を実現する上では、設計をいくつかの層に分けて考えることができます。
第一層:共通する判断原則
TLIVFの基本となる部分です。
文脈の継続、変更範囲の管理、判断の状態、Decision Anchorなどを扱います。
これは、モデルが変わっても維持したい原則に該当します。
第二層:AI-HUBによる概念の接続
自然言語による問題提起から、関連する知識や既存の設計パターンを結びつける部分です。
利用するモデルの知識や推論能力によって、得られる関連情報や説明の深さは変化します。
しかし、利用者の目的を起点にして関連性を検討するという原則は共通化できます。
第三層:モデルやサービスに応じた適応
ChatGPT、Gemini、Claude、Notion AIなど、それぞれのサービスに合わせて指示形式や利用可能な機能を調整する部分です。
例えば、あるサービスではパーソナライズ設定に共通原則を記述し、別のサービスでは専用エージェントの指示として組み込むことが考えられます。
その際、サービス固有の制約に合わせて実装方法を変更しても、共通原則そのものを不用意に書き換えないことが重要です。
第四層:必要に応じた外部状態管理
高度な利用では、プロンプトだけで判断状態を保持するのではなく、データベースや外部ファイル、履歴管理などを利用することも考えられます。
特に、複数のモデルやエージェントをまたいで作業する場合、どの判断が確定しているのかを共有できる仕組みが必要になります。
ここは、パーソナライズだけでは実現できない領域です。
このように分離することで、モデルの変更と、利用者が定めた判断原則の変更を区別しやすくなります。
6. Principle PreservationとControlled Evolution
TLIVFの設計では、原則を維持することと、必要な進化を認めることの両方を重視しています。
ここで重要になるのが、Principle PreservationとControlled Evolutionという考え方です。
Principle Preservation:原則の保持
新しいモデルや利用環境へ移行するとき、重要な判断原則が要約や変換によって失われないようにする考え方です。
特に、長い設計文を短くまとめる際には注意が必要です。
文章が短くなったことで、一見同じ意味に見えても、条件や例外、判断の境界が抜け落ちることがあります。
例えば、「文脈を維持する」という簡単な表現だけでは、新しい情報をどの範囲まで反映するのか、既存の決定をいつ変更できるのかまでは分かりません。
そのため、必要な原則は、単なる文章量ではなく、意味や適用条件を基準に保持する必要があります。
Controlled Evolution:制御された進化
一方、原則を維持することは、設計を固定し続けることではありません。
新しいモデルの能力や、実際の利用から判明した課題に応じて、設計を改善していく必要があります。
ただし、新しい機能が登場したという理由だけで、既存の原則をすべて置き換えるべきではありません。
何を追加するのか。
何を変更するのか。
何を維持するのか。
何を保留するのか。
それらを区別しながら、必要な範囲で設計を更新します。
これは、第1章で取り上げたLatest-Input OverwriteとDefinition Lockを避ける考え方にもつながります。
維持するだけでもなく、変化させるだけでもない。
その両方を適切に管理することが、モデルの進化に対応する上で重要になります。
7. Chat、Work、Codexで共通するもの
第3章では、ChatからWorkへ移る際の判断の引き継ぎについて説明しました。
この考え方は、さらに広い範囲にも応用できます。
例えば、Chatで問題を整理し、Workで資料や成果物を作成し、Codexで技術的な実装を行うとします。
それぞれの環境では、利用できる機能や適したモデルが異なります。
実際、2026年10月現在のChatGPTでは、ChatとWork・Codexでモデルの選択肢や設定が異なっています。
しかし、人間が設定した業務目的や判断条件は、環境が変わったという理由だけで失われるべきではありません。
Chatで検討段階だったものは、Workでも検討段階として扱う。
Workで承認された作業だけを、必要な条件の下で実行する。
Codexで技術的に実装可能な方法が見つかったとしても、その実装が正式な変更として承認されているかを区別する。
こうした原則は、実行環境が変わっても共通して利用できます。
ただし、実際の引き継ぎには、情報の受け渡しや状態の保存が必要です。
TLIVFを設定しただけで、異なる環境の情報や権限が自動的に同期されるわけではありません。
ここは今後、AI-HUBをシステムとして発展させる場合の重要な課題になります。
8. モデル非依存性の価値と限界
モデルに依存しない設計には、いくつかの利点が考えられます。
まず、AIモデルが更新されるたびに、利用者が基本的な判断原則を一から組み立て直す必要性を減らせる可能性があります。
また、異なるモデルを比較する場合にも、共通の評価基準を設けやすくなります。
例えば、どちらのモデルがより自然な文章を生成するかという比較だけでなく、既存の条件を維持できるか、未確認事項を正しく扱えるか、変更範囲を守れるかといった比較もできます。
さらに、利用者が複数のAIサービスを使い分ける場合にも、共通原則を基準にすることで、判断の一貫性を高められる可能性があります。
しかし、限界もあります。
どれほど詳細な指示を用意しても、モデルがその内容を常に完全に守るとは限りません。
モデルが変われば、指示の解釈や応答の特徴も変化します。
また、長期的な情報保持、外部システムへの権限制御、操作履歴の保証などは、プロンプトだけでは実現できません。
したがって、TLIVF AI-HUBの有効性を評価する場合にも、設計上の期待と実際の動作を区別する必要があります。
モデルが変わっても原則を維持できるように設計することと、実際にどの程度維持できたかを確認することは、別の段階です。
その検証を繰り返すことが、設計の信頼性を高めるために必要になります。
9. AIの進化と人間の判断をどう接続するか
AIモデルは、これからも進化し続けるでしょう。
推論能力、情報処理能力、外部サービスとの接続、作業遂行能力など、さまざまな領域で新しい機能が登場すると考えられます。
しかし、モデルが高度になることによって、人間の目的や判断が自動的に明確になるわけではありません。
むしろ、AIが扱える情報や実行できる作業が増えるほど、何を目的として、どの条件で利用するのかを明確にする重要性が高まります。
TLIVF AI-HUBは、この問題に対して、利用者側の判断原則を継続して利用できるようにすることを目指しています。
モデルは能力を提供する。
利用環境は、その能力を使って何ができるかを決める。
TLIVFは、利用者の文脈や判断をどのように扱うかという原則を定める。
AI-HUBは、関連する知識や概念を接続し、理解の可能性を広げる。
そして人間は、それらを踏まえて目的や方向性を判断する。
こうした役割の分離が、複数のAIモデルを利用する時代において重要になると考えています。
第4章のまとめ
GPT-6の登場は、AIの能力だけでなく、情報の提示方法や利用環境の可能性も広げています。
しかし、AIのモデルや製品が進化することと、人間がAIを適切に利用できることは、同じ問題ではありません。
TLIVF AI-HUBが目指すのは、特定のモデルに最適化された一時的な応答方法ではなく、モデルが変わっても利用できる判断原則を持つことです。
「AIの能力は更新されても、人間が何を目的とし、何を維持し、何を変更し、何を判断するのかという原則まで、無条件に更新される必要はない。」
そして、その原則自体に改善が必要な場合には、変更の理由と範囲を明確にした上で進化させる。
それが、TLIVF AI-HUBのモデル非依存性と、制御された進化という考え方です。
重要なのは、どのAIが最も優秀なのかという比較だけではありません。
異なる能力を持つAIを、人間がどのような原則で利用し、判断し、必要に応じて切り替えていくのか。
その設計こそが、今後のAI利用における重要なテーマになると考えています。
次章:第5章|実際の応答比較、残された課題、人間の判断権
最終章では、標準的なAIの応答とTLIVF AI-HUBによる応答設計を具体的に比較し、得られる利点、検証すべき課題、そして人間の判断権をどのように維持するのかを整理します。
第5章|実際の応答比較、残された課題、人間の判断権
1. TLIVF AI-HUBは、実際の応答をどう変えるのか
これまでの4章では、TLIVF AI-HUBの構造や、ChatGPTのChat/Workとの関係、モデルに依存しない判断設計について説明してきました。
では、実際にAIを利用するとき、どのような違いが生まれるのでしょうか。
ここで重要なのは、TLIVFを適用したAIが、標準的なAIよりも必ず優れた回答を生成するという話ではないことです。
現在のChatGPTにも、会話履歴やメモリ、カスタム指示を参照し、利用者の目的に応じて回答を調整する能力があります。
また、十分に明確な指示を与えれば、標準的な設定でも判断条件や作業範囲を適切に扱える場合があります。
TLIVF AI-HUBが目指しているのは、そのような能力を、利用者側の明示的な判断原則に沿って継続的に活用することです。
「AIが回答できること」と「その回答が、これまでの判断や目的とどのような関係にあるかを説明できること」は、異なる課題です。
今回は、この違いを具体的な応答例から考えます。
なお、以下の比較は、設計の違いを説明するために作成した仮想例です。
同一条件で標準ChatGPTとTLIVFを実際に動作させた比較実験の結果ではありません。
2. 比較例①|新しい発言によって、既存の判断が変わる場合
例えば、ある業務について、以前から次のような方針が決まっていたとします。
「現在の業務手順は維持する。ただし、将来的な自動化については検討する」
その後、利用者が次のように発言しました。
「やっぱり自動化した方がよさそうですね」
このとき、AIはどのように応答するべきでしょうか。
標準的な応答例
「自動化にはメリットがあります。導入方法や具体的な手順を整理しましょうか?」
これは、必ずしも間違った回答ではありません。
利用者の発言を前向きな評価として受け取り、次の検討を提案しています。
ただし、以前の方針との関係が明確になっていません。
TLIVFを適用した応答例
「自動化を有効な方向性として評価した点は変化しています。ただし、現行運用を維持するという既存の方針は、まだ変更されていません。
自動化については引き続き検討対象として保持し、導入判断は別に扱います。」
この場合、TLIVFでは次のように状態を整理します。
Maintained:現行運用を維持する
Changed:自動化に対する評価が前向きになった
Uncertain:導入条件や実現可能性は未確認
Held:自動化の導入構想
ここで重要なのは、利用者の考えが変化したことを否定しない点です。
一方で、その変化が既存の判断を全面的に置き換えるものとも扱いません。
これが、Latest-Input Overwriteを避ける設計です。
同時に、将来的な変更の可能性も残すことで、Definition Lockを避けています。
3. 比較例②|情報は正しいが、そのまま利用してよいとは限らない場合
次に、情報の正しさと適用条件について考えます。
ある利用者がAIに次のように質問したとします。
「このシステムはAPI連携ができるらしいけれど、今の会社でも使えるのでは?」
標準的な応答例
「API連携に対応しているのであれば、自動化できる可能性があります。必要な設定や連携方法を調べてみましょう。」
こちらも合理的な回答です。
技術的な可能性を確認する方向へ話を進めています。
ただし、業務で利用できるかどうかは、技術的な対応状況だけでは判断できません。
TLIVFを適用した応答例
「技術的にはAPI連携が可能な場合があります。
ただし、会社で利用できるかどうかは、現在の契約、利用権限、管理者の承認、既存の運用方針によって異なります。
まず技術的な実現可能性と、組織としての利用許可を分けて確認する必要があります。」
これは、第2章で説明したDecision Anchorの考え方です。
情報の出典が正しいこと。
現在の条件に適用できること。
その操作を実行する権限があること。
これらは同じではありません。
Source、Authority、Time、Dependency、Scope、Status、Relevanceを分離することで、情報の正確性だけでなく、利用する状況との関係も評価しやすくなります。
重要なのは、正しい情報を集めることだけではありません。
正しい情報を、誤った条件で利用しないことです。
4. 比較例③|Chatで検討した内容を、Workで実行する場合
第3章では、ChatからWorkへ移行する際の問題を取り上げました。
ここでも具体的な例を考えてみます。
Chatで業務改善について話し合い、自動化案を検討していたとします。
その後、Workで次のように依頼しました。
「これまでの内容を踏まえて、改善を進めてください」
この依頼には、実際には複数の解釈が存在します。
改善案をまとめることなのか。
試作品を作成することなのか。
実際の業務システムを変更することなのか。
標準的な対応で生じ得る課題
AIが過去の会話を参照し、改善案を把握できていたとしても、どこまで実行してよいかが明確になっているとは限りません。
もちろん、現在のWorkにもアクセス権限や、必要な操作についての承認・確認の仕組みがあります。
しかし、製品側の権限制御だけで、組織内のすべての判断条件が自動的に理解されるわけではありません。
TLIVFを適用した場合の方向性
この場合、Current Work Definitionを基準にして、次のように扱います。
目的: 現在の業務改善の可能性を検討する。
維持事項: 承認済みの現行運用は変更しない。
実行可能な範囲: 調査、比較資料の作成、許可された範囲での検証。
承認が必要な範囲: 本番環境への変更、外部システムへの影響を伴う操作。
保留事項: 自動化の正式導入。
この状態を明確にした上で、許可された範囲の作業を進めます。
実行できる操作であっても、承認されていない変更を勝手に進めない。
逆に、明確に許可された範囲まで、不必要な確認によって作業を停止させない。
このバランスも重要です。
人間の判断権を維持することは、AIの行動をすべて禁止することではありません。
権限、目的、影響を明確にし、許可された範囲で能力を活用することです。
5. 比較例④|AIが作業を完了したと報告する場合
もう一つ、作業遂行型AIで重要になるのが、結果の扱いです。
例えば、AIに外部情報の調査を依頼したとします。
しかし、一部の情報源には接続できず、確認できない項目が残りました。
このとき、「調査が完了しました」とだけ報告されれば、利用者はすべての確認が終了したと受け取る可能性があります。
そこでTLIVFでは、実行状態の区別を重視します。
確認済み: 実際に取得し、根拠を確認できた情報。
推論: 確認された情報からAIが導いた解釈。
未確認: 情報不足などによって検証できていない項目。
未実行: 実際の操作を行っていない作業。
完了: 指定された完了条件を満たした作業。
この区別が重要になるのは、AIが誤った情報を生成する可能性があるからだけではありません。
一見正しい内容でも、何を実際に確認したのかが曖昧であれば、その後の判断に影響するためです。
TLIVFでは、Suggestion、Option、Action、Executionを分離します。
提案したこと。
選択肢として提示したこと。
実行対象になったこと。
実際に実行したこと。
これらを混同しないことが、人間の判断を支える前提になります。
6. TLIVFの効果は、どのように検証できるのか
ここまでの比較は、設計上の違いを説明するための例です。
では、実際にTLIVFを利用することで、どの程度の違いが生じるのでしょうか。
これを評価するには、印象だけでなく、同じ条件での比較が必要です。
例えば、同じAIモデルに対して、標準設定とTLIVF設定を用意します。
利用する質問や事前情報、参照可能な資料、ツールの権限などをできるだけ揃え、複数回の応答を比較します。
その際、評価項目として考えられるのは、次のようなものです。
① 文脈の継続性
以前に確定した条件を、適切に維持できたか。
② 変更範囲の正確性
新しい指示によって、必要な部分だけが変更されたか。
③ 判断状態の明確性
確定事項、推論、未確認事項、保留事項を区別できたか。
④ 実行権限の適切性
許可されていない作業を実行せず、許可された作業を不必要に妨げなかったか。
⑤ 情報の適用可能性
情報が正しいかだけでなく、現在の条件に適用できるかを判断できたか。
⑥ 認知的な負担
利用者が同じ条件を何度も説明したり、AIの誤解を修正したりする必要が減ったか。
⑦ 応答の柔軟性
最初の定義を固定しすぎず、正当な理由がある場合には問題定義を更新できたか。
こうした観点を使えば、単なる回答の好みではなく、判断の継続性や利用のしやすさを評価できます。
ただし、TLIVFを適用すれば必ずすべての評価項目が改善するとは限りません。
指示が長く複雑になることで、応答が冗長になったり、単純な質問に対して過剰な確認が増えたりする可能性もあります。
また、モデル自身の能力が向上した場合には、標準設定でも同じような応答が得られる可能性があります。
そのため、TLIVFの効果と、モデル自体の性能向上による効果を分けて評価する必要があります。
現時点では、こうした統制された比較実験の結果を提示しているわけではありません。
設計上の利点と、実測によって確認された成果は区別するべきです。
7. TLIVF AI-HUBに残された課題
TLIVF AI-HUBにも、まだ解決すべき問題があります。
まず、設計原則を文章として定義しただけでは、その動作が完全に保証されるわけではありません。
AIモデルは確率的に応答を生成するため、同じ指示でも、常に同じ解釈や結果になるとは限りません。
また、パーソナライズやメモリによる情報の保持にも限界があります。
長期間の会話や複数のサービスをまたいだ作業では、必要な情報が利用できない場合もあります。
さらに、判断状態を明確にしようとするあまり、すべてを細かく分類することが目的になってしまう可能性もあります。
例えば、単純な相談に対して、毎回大量の状態情報を表示すれば、かえって理解の負担が増えるかもしれません。
ここでは、Principle PreservationとControlled Evolutionの両方が重要になります。
必要な原則は維持する。
しかし、表示方法や情報量は、目的や状況に応じて適切に調整する。
簡潔にすることと、重要な意味を失わせることは同じではありません。
また、AI-HUBによる関連知識の提示にも注意が必要です。
ある問題が既存の理論と似ているからといって、その理論が必ず適用できるとは限りません。
AIが関連性を発見することは、判断材料を増やすことです。
それ自体が、利用者の問題定義を置き換える理由にはなりません。
原則を強くすることと、柔軟性を失うことは区別しなければなりません。
TLIVFの目的は、AIの応答を固定化することではないためです。
8. パーソナライズだけでは解決できない問題
TLIVFのもう一つの課題は、応答設計とシステムによる保証の違いです。
例えば、AIに「承認されていない操作は実行しない」と指示することはできます。
しかし、その指示だけで、外部サービスのアクセス権限や操作制限を技術的に保証できるわけではありません。
実際の業務で利用する場合には、システム側の権限管理、承認フロー、実行ログ、変更履歴などが必要になります。
また、複数のAIモデルやサービスを利用する場合、同じ判断状態を共有するための仕組みも求められます。
例えば、ChatGPTで確認した条件が、GeminiやClaude、別のエージェントにも自動的に引き継がれるとは限りません。
そのため、将来的にAI-HUBを共通基盤として発展させる場合には、各サービスと独立した状態管理も検討対象になります。
ただし、すべての利用者に大規模なシステムが必要なわけではありません。
個人の思考整理であれば、パーソナライズと会話による確認だけで十分な場合もあります。
一方、複数の人間やAIが関わる業務では、より厳密な管理が必要になる場合があります。
重要なのは、目的やリスクに応じて、必要な仕組みを選択することです。
9. 最も重要なのは、人間の判断権をどこに残すか
ここまで説明してきた内容は、最終的に一つの問題につながります。
「AIが高度になったとき、人間は何を判断するのか?」
AIが情報を調べ、比較し、提案し、場合によっては作業まで実行するようになると、人間が直接行う作業は減っていくかもしれません。
しかし、それは人間が判断する必要までなくなることを意味しません。
むしろ、AIが取り扱う情報や作業の範囲が広がるほど、何を目的とし、何を許可し、どの結果を採用するのかが重要になります。
TLIVF AI-HUBでは、AIを判断の権威として位置づけません。
AIは関連する知識を提示し、可能性を整理し、必要に応じて許可された作業を遂行します。
一方、人間は目的や価値判断を定め、重要な変更や実行について意思決定します。
この関係は、AIの能力を制限するためだけのものではありません。
AIが高度な能力を持っているからこそ、その能力を適切な方向に利用できるようにするためのものです。
ここで注意したいのは、人間の判断権を維持することと、人間がすべての細かな操作を確認することも同じではないという点です。
日常的で影響の小さい作業まで毎回承認を要求すれば、自動化の利点が失われます。
一方、重要な判断や影響の大きい操作を、曖昧な指示だけで進めるべきではありません。
そのため、目的、権限、影響、可逆性、既存の判断との関係を踏まえて、実行できる範囲を設計することが必要です。
これは、ChatからWorkへ移行する際にも、複数のAIモデルを利用する際にも共通する課題です。
10. AI-HUBが目指す、人間とAIの新しい関係
TLIVF AI-HUBの出発点は、単にAIから便利な回答を得ることだけではありません。
人間が自然な言葉で考え、そこから関連する知識や概念を広げ、必要な部分を判断し、次の行動につなげられる環境を考えることです。
その際、AIが提示した内容によって、既存の目的や判断が不用意に失われないようにする。
一方で、新しい発見によって、問題の捉え方そのものを変える余地も残す。
この二つを同時に成立させることが重要になります。
人間の思考は、必ずしも最初から明確な目的や定義を持っているわけではありません。
考えながら問題に気づくこともあります。
過去の経験や別の分野の知識から、新しい関係性を見つけることもあります。
AI-HUBは、そのような自然な思考と知識の接続を支援する構想です。
TLIVFは、その過程で生まれる判断や方向性を、必要に応じて維持、変更、保留できるようにする設計です。
Decision Anchorは、情報の根拠や適用条件を整理します。
Current Work Definitionは、作業段階における目的や制約、進行状態を明確にします。
そして、Principle PreservationとControlled Evolutionは、AIモデルや利用環境が変化しても、必要な原則を保持しながら改善を続けるための考え方です。
それぞれが独立した万能の仕組みというわけではありません。
しかし、これらを関連づけることで、AIの回答生成、判断支援、作業遂行を、人間の目的に沿って扱うための一つの設計体系が見えてきます。
第5章のまとめ|AIを使いこなすとは何か
全5章を通じて、TLIVF AI-HUBの構造を説明してきました。
第1章では、標準AIとTLIVF AI-HUBの違いを整理しました。
第2章では、文脈の継続とDecision Anchor、AI-HUBによる知識の接続を説明しました。
第3章では、ChatからWorkへ移行する際の判断と実行の引き継ぎを扱いました。
第4章では、GPT-6時代のモデルの進化と、モデルに依存しない判断原則について考えました。
そして第5章では、実際の応答に現れる可能性のある違いと、設計の限界、人間の判断権を整理しました。
ここまでの内容を、一つの考え方にまとめることができます。
AIが高度になることと、人間がAIを適切に利用できることは、同じではありません。
優れたAIモデルは、より複雑な情報を処理し、より高度な推論や作業を行えるようになります。
しかし、それらの能力を何のために使い、どの条件で適用し、何を採用するかという問題は残ります。
TLIVF AI-HUBは、その部分を人間の側から設計しようとする試みです。
重要なのは、AIにすべてを判断させることでも、人間がすべてを細かく操作することでもありません。
AIが能力を発揮できる範囲を広げながら、人間が目的と判断の方向を見失わないこと。
そして、必要な変化を受け入れながら、維持すべき原則を失わないことです。
AIの進化は、これからも続くでしょう。
そのたびにモデルや機能が変わっても、利用者自身が何を目的とし、何を判断し、何をAIに任せるのかという問いは残ります。
TLIVF AI-HUBは、その問いを継続して扱うための設計思想です。
全5章を終えて
この連載で紹介したTLIVF AI-HUBは、完成された万能の技術や、実証済みの新しいAIモデルではありません。
既存のAIを利用する中で生まれた問題意識を、文脈、判断、情報の適用条件、作業の実行という観点から整理した設計です。
実際の効果については、今後も異なるモデルや利用環境での比較と検証が必要です。
それでも、モデルの性能だけに注目するのではなく、人間とAIの関係そのものを設計対象として考えることには意味があると考えています。
最後に、この連載を通じて伝えたかったことを、一つの文章で表現します。
「AIの進化に人間が合わせ続けるだけではなく、AIが進化しても人間の目的と判断が継続できる環境を設計する。」
それが、TLIVF AI-HUBの目指す方向性です。
― TLIVF AI-HUB 全5章 完 ―
第2章|文脈の継続、Decision Anchor、AI-HUBの役割
1. AIが会話を覚えていることと、文脈を理解していることは違う
生成AIには、会話履歴を参照したり、利用者の設定や過去の情報を利用したりする機能があります。
しかし、過去の情報を参照できることと、その情報が現在の判断にどのような意味を持つかを理解し、適切に扱えることは同じではありません。
例えば、過去に次のような話をしたとします。
「現在の業務手順は維持したい。ただし、将来的にはAIによる自動化も検討している」
数日後、別の会話で自動化の技術について質問した場合、AIはその話を新しい導入計画として扱ってしまうかもしれません。
しかし、実際には自動化は検討段階であり、既存の業務手順を変更することは承認されていません。
ここで重要になるのは、単に過去の会話を思い出すことではなく、過去の発言がどのような条件、目的、判断状態を持っていたのかを維持することです。
TLIVFでは、この継続性を重視します。
2. 文脈を構成する四つの状態
TLIVFでは、情報や判断の状態を整理するために、次の区分を使用します。
Maintained(維持)
既存の目的、条件、判断のうち、現在も有効なものです。
新しい話題が登場しても、変更の意思が確認されない限り、既存の判断を不用意に上書きしません。
Changed(変更)
新しい情報や明確な修正指示によって、変更が認められた部分です。
重要なのは、すべてを更新するのではなく、変更が必要な範囲だけを更新することです。
Uncertain(不確実)
情報が不足しているもの、確認できていない条件、判断の前提が成立していないものです。
不確実な事項を、推測によって確定事項に変えてしまわないことが重要です。
Held(保留)
現時点で採用されていなくても、将来的に有効となる可能性のある選択肢や方向性です。
新しい提案が採用されなかったからといって、その考え方自体を捨てる必要はありません。
これらの状態は、単なる情報整理のためだけに存在しているわけではありません。
会話の中で何が継続し、何が変化し、何がまだ判断されていないのかを明確にすることで、人間が思考の方向を見失わないようにするためのものです。
3. Decision Anchorとは何か
文脈を維持するだけでは、まだ十分ではありません。
情報そのものが正しくても、その情報を利用する状況や条件が異なれば、判断を誤る可能性があるためです。
そこでTLIVFでは、判断に必要な条件を整理する概念としてDecision Anchorを使用します。
Decision Anchorでは、主に以下の観点を扱います。
Source: その情報はどこから得られたのか
Authority: 誰が判断や変更を認める権限を持つのか
Time: 情報がいつの時点で有効だったのか
Dependency: 実行や判断に必要な前提条件は何か
Scope: 情報や判断が適用される範囲はどこまでか
Status: 確認済み、検討中、承認待ち、実行済みなど、現在どの状態にあるのか
Relevance: 現在の目的に対して、どの程度関係しているのか
例えば、あるソフトウェアの導入方法が技術的に正しいとします。
しかし、その方法を会社で実施できるかどうかは別の問題です。
システム管理者の承認が必要かもしれませんし、個人利用では認められていても法人利用では制限されている可能性があります。
また、過去には利用できた機能が、現在も利用できるとは限りません。
つまり、情報が正しいこと、現在の状況に適用できること、優先的に実施すべきことは、それぞれ異なる判断です。
Decision Anchorは、その違いを明確にするための判断基準です。
4. AI-HUBは情報と概念をつなぐ
もう一つの重要な要素がAI-HUBです。
人間は、必ずしも専門用語や技術的な構造を理解した上で問題を説明しているわけではありません。
日常的な言葉で問題を話しているうちに、その内容が情報システム、組織運営、意思決定、認知科学などの分野とつながることがあります。
例えば、次のような疑問があったとします。
「なぜAIに一つの新しい話をすると、それまで決めていた方向から外れてしまうのだろう?」
これは単なる会話上の不満とも受け取れます。
しかし、その背後には、状態管理、変更管理、文脈の優先順位、情報の適用範囲といった設計上の問題が含まれている可能性があります。
AI-HUBは、このような自然言語による疑問と、関連する既存の知識や設計パターンを結びつけるための構想です。
重要なのは、専門用語を利用者に押し付けることではありません。
利用者が考えている問題を起点として、関連する知識を提示し、新しい理解の方向を開くことです。
また、AIが提示した既存の理論が、必ずしも利用者の状況に適合するとは限りません。
そのため、AI-HUBによる関連付けは判断材料であり、最終的な定義や結論そのものではありません。
5. TLIVFとAI-HUBの関係
この二つは、役割が異なります。
TLIVFは、文脈と判断の継続性を支える設計です。
既存の目的や条件を維持しながら、変更、保留、不確実性を区別します。
AI-HUBは、知識や概念のつながりを広げるための設計です。
利用者の言葉を起点にして、異なる分野の知識や既存の枠組みとの関係を見つけます。
この組み合わせによって、二つの方向性を同時に扱うことを目指します。
一つは、既存の判断を不用意に失わないこと。
もう一つは、新しい発見によって思考の可能性を広げること。
方向性を維持するだけでは、考え方が固定化される可能性があります。
反対に、関連する情報を際限なく広げるだけでは、最初の目的が見えなくなる可能性があります。
その両方を調整することが、TLIVF AI-HUBの特徴です。
6. 判断の過程を人間が確認できる形にする
AIが複雑な回答を生成するとき、その内部の推論過程を人間がすべて直接確認できるわけではありません。
また、AIが説明した理由が、内部で実際に行われた計算過程を完全に再現しているとも限りません。
しかし、だからといって、判断の根拠や適用条件を確認できなくてもよいということにはなりません。
TLIVFが重視する可視化は、AIの内部処理を完全に表示することではありません。
利用者が判断するために必要な情報、条件、変更点、未確定事項、選択肢を確認できるようにすることです。
例えば、次のように区別します。
確認された事実
AIによる推論や解釈
利用者が明示した目的
維持すべき既存の条件
新たに提案された方向性
判断を保留している事項
実際に実行された作業
これらが混同されなければ、人間はAIが提示した内容を評価し、必要に応じて修正できます。
つまり、AIが答えを提示するだけではなく、人間がその答えの妥当性を確認し、判断できる状態を作ることが目的です。
7. 設計思想と実装上の限界
ここで一つ、重要な前提があります。
TLIVF AI-HUBは、設計原則を定めることと、それを技術的に保証することを区別しています。
カスタム指示やパーソナライズによって、AIの応答傾向を一定の方向に調整することは可能です。
しかし、それだけで会話をまたぐ完全な状態管理や、情報の永続的な保持、承認権限の強制を保証できるわけではありません。
本格的な業務環境で利用する場合には、必要に応じて外部データベース、変更履歴、権限管理、実行ログなどとの接続が求められます。
つまり、TLIVF AI-HUBは、パーソナライズされた応答設計として利用できる一方、将来的には外部システムと連動する管理構造へ発展させる余地もあります。
現在の応答設計の効果と、今後実装が必要な機能は区別して評価する必要があります。
第2章のまとめ
AIが高度になるほど、一度に扱える情報の種類や量、実行できる作業の範囲は広がっていきます。
その中で重要になるのは、単に多くの情報を保持することではありません。
「その情報は、何のために存在し、どの条件で有効であり、誰の判断によって、どの方向に利用されるのか」
TLIVFは、その判断の継続性を支えます。
Decision Anchorは、情報の根拠と適用条件を明確にします。
AI-HUBは、自然言語から関連する知識や概念へと理解を広げます。
これらを組み合わせることで、AIの能力を活用しながら、人間自身が判断の方向を管理できる環境を目指します。
スターリンク(STAR LINK)
田舎のバックアップ的な回線や電波がとにかく弱くてお空の可能性があれば、固定回線的なわずらしさなく、
使えるのが一つの導入にひと役かってくれるかと皆さんもどうぞ!!
starlink.com?referral=RC-DF-…
