

材料開発×マテリアルズインフォマティクス|実験回数を減らすためのデータ活用|Python・ベイズ最適化|化学メーカー勤務|未経験からデータサイエンティストへ(元プロセス開発エンジニア)|noteで実務に使えるPythonテンプレ&キャリアに関する情報を発信中
Osaka, Japan
Joined April 2021
- Tweets668
- Following107
- Followers1.3K
- Likes458





Pinned Tweet
材料開発で「実験回数を減らしたい」と思ったことはありませんか?
ベイズ最適化をコピペで即実行可能なPythonテンプレートにまとめました。
・今日から使えるコード&サンプルデータ付き
・実務目線で設計&解説
・ベイズ最適化が何か分かる!
詳細はこちら↓
note.com/sukechannel/n/n6ac4…

以下の記事で
個人的に2025年気になった3選で「秘密計算」を取り上げています。
note.com/sukechannel/n/n5b27…


『レゾナック、ZenmuTechとの共創により秘密計算を活用したMI基盤を構築』
・2023年からZenmuTechと連携
・秘密分散方式
・パートナーのA社はどこなん?
レゾナックからも秘密計算の報告。秘密計算は話題の技術で、いくつかの協業体制があるので、今後どうなるか注目です!
prtimes.jp/main/html/rd/p/00…
『レゾナック、ZenmuTechとの共創により秘密計算を活用したMI基盤を構築』
・2023年からZenmuTechと連携
・秘密分散方式
・パートナーのA社はどこなん?
レゾナックからも秘密計算の報告。秘密計算は話題の技術で、いくつかの協業体制があるので、今後どうなるか注目です!
prtimes.jp/main/html/rd/p/00…
未経験からデータサイエンティストに転職したとき、勉強した内容をQiitaで発信していました。
「こんなことができるんですね!」と採用につながりました。
学んだことを発信するのは、自分にできることを伝える手段にもなると実感しています。
当時の記事の一例はこちら👇
qiita.com/oki_kosuke/items/4…

『データサイエンティストを目指すなら、何から勉強すればいい?』
統計学、Python、機械学習…
学ぶことが多いからこそ、全部を一気に勉強する必要はないと思っています。
まずはPythonでデータを分析しながら、必要な統計や機械学習を学ぶのが一つ。
みなさんは、最初に何から勉強しましたか?
K.Oki@製造系データサイエンティスト retweeted

nature.com/articles/s41524-0… 直感的インターフェースでベイズ最適化を材料研究に導入するPythonフレームワーク「Bgolearn」。単一および多目的最適化、多様な代理モデルの提案と不確実性の定量化。その有効性を超高硬度高エントロピー合金の探索などで実証。 #マテリアルズ・インフォマティクス
機械学習の「特徴量重要度」が高い変数ほど、予測に重要だと思っていませんか?
実は、算出方法によって見えてくるものが違います。
Feature Importance、Permutation Importance、SHAPの違いをまとめてみました👇
qiita.com/oki_kosuke/items/4…

K.Oki@製造系データサイエンティスト retweeted

マテリアルズインフォマティクスの最新ニュース。
村田製作所さんは、実験データとマルチAIエージェントを連携した研究開発システムを構築したそうです。計画・データ解析・レポート作成により業務スピードを22倍高速化できるとのこと。
AIエージェント活用が進んでる。
corporate.murata.com/ja-jp/n…

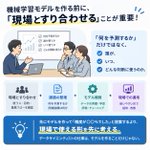
『機械学習モデルを作る前に、現場とすり合わせる』ことが重要!
「何を予測するか」だけではなく、
誰が、いつ、どんな判断に使うのか。
「精度が○○%でした」と提案する前に、現場で使える形を考える。
データサイエンティストの仕事は、モデルを作ることだけじゃない。
🤖 Made with AI

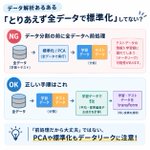
【データ解析あるある】
「とりあえず全データで標準化」してない?
PCAや標準化は、分析の最初についやってしまいがち。
でも、データ分割前に全データへ前処理をすると、テストデータの情報が学習側に漏れることがある。
「前処理だから大丈夫」ではない。
PCAや標準化もデータリークに注意!
🤖 Made with AI

材料開発×AI、次は「予測」だけじゃない!
147文献を調査した「AI駆動型マテリアル研究開発」のレポートが興味深かった。
自動・自律実験の開発の方向性と、日本の現在地が整理されていた点が面白かった。
AIが研究開発そのものをどう支援していくのか。今後が楽しみです👇
jst.go.jp/crds/column/kaiset…

「データサイエンティストになるなら、まず何を勉強する?」
私が転職前にやっていたのは、
・Python
・統計
・機械学習
……を全部完璧にすることではありませんでした。
まず手を動かして、分からないところを調べる。
この繰り返しが、結果的に一番身についたと感じています。
【データ解析あるある】
「標準化すると、データはどうなる?」
標準化すると、
平均値 → 0
標準偏差 → 1
になります。
これによって、単位やスケールが違う変数を比較しやすくなる。
「標準化=データを小さくする」
ではありません。
🤖 Made with AI

K.Oki@製造系データサイエンティスト retweeted

子育てしながら統計検定準1級に4か月半で合格し、未経験からデータサイエンティストへの転職を果たされた林田さんにインタビューさせていただきました(リンクはリプ欄)
撮影当日の林田さんのパフォーマンスが圧巻で、公開後22時間の再生回数が私のチャンネル史上最多となったのもひとえに彼女の実力の賜物😌

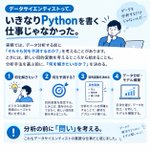
『データサイエンティストって、いきなりPythonを書く仕事じゃなかった。』
実務では、データ分析する前に
「そもそも何を予測するのか?」
を考えることがあります。
ときには、新しい目的変数を考えるところから始まることも。
分析手法を選ぶ前に、「何を解きたいのか?」を決める。
🤖 Made with AI

K.Oki@製造系データサイエンティスト retweeted

原子・結合の局所特徴量を集める決定版ツール「BONAFIDE」がすごい!🧪✨
分子全体ではなく【原子・結合に特化した局所記述子 590種】を統一APIで一気通貫に計算できるPythonパッケージ(Apache 2.0)。
GitHub👇
github.com/MolecularAI/atom-…
#ケモインフォマティクス #機械学習 #Python

【データ解析あるある】
「R²=0.8なら、良いモデル?」
実は、データの範囲も確認したい。
同じような関係性でも、
データを狭い範囲で集めた場合と、広い範囲で集めた場合では、R²が変わることがある。
R²の数字だけでモデルを評価するのは危険。
データの範囲も大事!
🤖 Made with AI

K.Oki@製造系データサイエンティスト retweeted

◾️世界の化学企業の歴史
1995年の世界化学企業トップ10。30年後も同じ会社・同じ事業のまま残っているのは、BASFの1社だけです。
2位 Hoechst(ドイツ)は、いくつもの会社に分割されて名前ごと消えました。
3位 Dow(アメリカ)は2025年も5位。ただし2017年に5位のDuPontと合併し、その2年後に3社へ分割。名前は同じでも、中身は別の会社です。
4位 Bayer(ドイツ)は2015年に材料事業を切り離し、2018年にモンサントを買収。いまや化学品は売上の2割で、農薬と医薬の会社です。順位は36位まで下がりました。
5位 DuPont(アメリカ)は1802年創業の名門ですが、Dowとの合併と分割を経て、2025年はトップ10から姿を消しました。
7位のイギリスICIも、2008年に買収されて消滅。10位の台湾プラスチックは自力で成長を続けてきたものの、中国・サウジ勢が上がってくる中で、2025年は13位とトップ10圏外です。
ただ、消えた会社の事業そのものは残っています。売られた先で、別の会社の一部になっただけです。
たとえばIneos。1995年の表には影も形もありませんが、BPやBASFが手放した事業を次々に買い集めて、2015年には世界6位まで来ました。
では、日本の化学メーカーはこの30年どうだったのか。続きはリプ欄のNoteにて👇

【データ解析あるある】
「決定係数R²がマイナスって、どういうこと?」
R²って0〜1のイメージがあるけど、マイナスになることがあります。
これは、
「平均値を予測するだけのモデルより、予測が悪かった」
ということ。
R²がマイナスでも、計算ミスではない!
R²って、意外と奥が深い。
🤖 Made with AI
