




Geminiの気遣いが染み渡る...
GPTとClaudeからこの一言が出るのだろうか
Antigravity使う機会が増えそう
AI ProでNeonは2〜3日しか持たなそうだけど年割月1200円なら十分
しかもチャットとAntigravityで枠が別だからコスパだいぶいい

1
154
Inkling 2 Miniを推論エンジン4つで実測
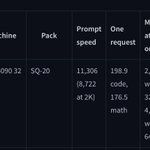
Prefillは165kで3エンジンが同等
Decodeは64KまでBasaltが最速、128k以降SGLangがCodeで逆転した
各エンジン5090で165~256k入力が動作する構成で比較(vLLMは5090だとdspark起動に失敗)
Basalt / SGLang / vLLM / llama.cpp
■ 結果 (画像1〜4)
Prefill (8K→165K→256K)
・vLLM:15000→7600→6000 tok/s
・SGLang:13600→7500→不可
・Basalt:11800→7500→5600 tok/s
・llama.cpp:2100→1800→1600 tok/s
Code (8K→165K→256K)
・Basalt:312→159→124 tok/s
・SGLang:247→176→不可
・vLLM:165→111→93 tok/s
・llama.cpp:109→70→55 tok/s
Prose (8K→165K→256K)
・Basalt:273→141→110 tok/s
・SGLang:177→133→不可
・vLLM:166→110→93 tok/s
・llama.cpp:86→54→43 tok/s
SGLangはdspark ONだと256kがVRAM32GBに収まらず165kが限界だが、Decodeは8k時のCode 71% Prose 75%を維持しBasaltの51% 52%に低下しているのと比較して長文入力での速度低下が小さい
■ 簡易品質チェック
・vLLMx公式重みの出力で次のトークン確率を簡易チェック
・平均KLDは4エンジンとも0.010〜0.013
・vLLM自身の経路差 (0.012) と同水準
・1位と2位の確率差が大きい出力ケースでの逆転は全エンジン0件
・llama.cppだけズレの大きいケースがあるが量子化の違いであると推測
・ベンチマークテストのスコアまでは見れていない
■ 感想
・Prefillは8k入力で10000~15000tok/sと高速であり実用性が高いと感じた
・相変わらず推論エンジン比較は公平な条件での比較が難しい
・長文入力での速度維持ができれば理想
・次は本命の並列性能を検証したい
■ 前提条件
モデル:
Inkling 2 Mini
Basalt:
v0.5.5 公式
(experts NVFP4、Q8_0)
SGLang / vLLM:
公式 NVFP4+MXFP8
llama.cpp:
b12588 UD-Q4_K_XL
(dspark Q8_0)
dspark:
公式のドラフトモデル
vLLMは非対応
ハードウェア:
RTX 5090 32GB (400W)
計測:
1リクエスト / 出力1024
greedy / 思考OFF
(Basaltは一部Thinkingが残存)
各10回の中央値


Inkling 2 Mini 26B A5Bを早速実測!同じサイズ帯のGemma 4 26B-A4B、Qwen3.8 27BとRTX5090で比較
結果としてはMoEだから爆速!とはならず現状のllama.cpp実装だと速度がQwen3.8 27B Denseと同等の速度となった
■ Inklingの計測結果
256K入力時
・Prefill:1630 tok/s
・Prose:43 tok/s
・Code:57 tok/s
Gemma 4 26B-A4B比:
Prefill 49% / Prose 32% / Code 32%
Qwen3.8 27B比:
Prefill 120% / Prose 82% / Code 82%
今回llama.cppでそのまま動かしたが最適化しだいで改善の余地はありそう
RTX 3060 12GBとDGX SparkのInklingは計測中
■ なぜInklingは高速にならないのか
Inklingは中央12層を3回ループ実行する構造でアクティブ3.4Bに対しループ込みでは5.4B相当
それでもGemmaよりかなり遅い理由をnsysで調べた
Prefill
・Gemma4 26B A4Bにはない非量子化の行列演算が存在
・CPUからGPUへattentionの参照表の転送が発生していると推測
Decode
・1トークンあたりの kernel 呼び出しが Gemma の約6倍(約7370回に対してGemmaは約1,260回)
これらが速度差の一因になっている可能性がある
■ 256K Prefillの処理時間内訳
・Gemma:attentionが約8割
・Inkling:attentionは約2割で、残りはattention以外の処理
・実際に8K→256KでのPrefill低下は
Gemma -69%(10948→3350 tok/s)
Inkling -22%(2082→1630 tok/s)
■ 前提条件
モデル:
Unsloth GGUF
・Inkling 2 Mini (UD-Q4_K_XL 17.6GB)
・Gemma 4 26B-A4B (QAT UD-Q4_K_XL 14.2GB)
・Qwen3.8 27B (UD-Q4_K_XL 17.7GB)
ドラフト:
3モデルともON
・Inkling:公式dspark
・Gemma / Qwen:MTP
推論エンジン:
unsloth/llama.cpp b12588-mix-c0c3de8
(Inkling対応版をビルド / 3モデル共通)
ハードウェア:
RTX 5090 32GB (400W) / 全てGPU
計測:
1リクエスト / 出力1024 / greedy
思考OFF / ctx 262144
入力は文章とコード / 各点5回の中央値
KV:f16
・Qwenだけq8_0
・f16だと256KでVRAM 32GBに入らない


9
21
2,853
使用したエンジン / 重み / 設定
■ SGLang
lmsysorg/sglang:inkling-2-mini
github.com/sgl-project/sglan…
重み: huggingface.co/thinkingmachi…
設定: --speculative-algorithm DSPARK --speculative-num-draft-tokens 8
--context-length 262144 --mem-fraction-static 0.89
--page-size 128 --chunked-prefill-size 2048
--cuda-graph-max-bs-decode 1 --cuda-graph-max-bs-prefill 1
--disable-radix-cache --max-running-requests 1
■ vLLM
vllm/vllm-openai:inkling-2-mini
github.com/vllm-project/vllm
重み: huggingface.co/thinkingmachi…
設定: --max-model-len 262144 --max-num-seqs 1
--gpu-memory-utilization 0.97 --kv-cache-memory-bytes 12805856256
--language-model-only --no-enable-prefix-caching
5090はdspark起動失敗
■ llama.cpp
Unsloth fork b12588-mix-c0c3de8
github.com/unslothai/llama.c…
重み: huggingface.co/unsloth/Inkli…
(UD-Q4_K_XL + dspark-Inkling-2-Mini-Q8_0)
設定: --ctx-size 262144 --n-gpu-layers 99 --parallel 1
--spec-type draft-dspark --model-draft dspark-Inkling-2-Mini-Q8_0.gguf
■ Basalt v0.5.5
github.com/jesdga95/basalt/r…
重み: huggingface.co/jesdga/Inklin…
設定: basalt serve Inkling-2-Mini-NVFP4-q8.basalt --max-context 262144 --kv fp16

146
orenoa retweeted

The Lean FRO and Mathlib Initiative have released a joint statement on the Lean verification of the Riemann Hypothesis.
On November 20, Levent Alpöge released a proof of the Riemann Hypothesis as a Lean library of 17 million lines of code. Over the past day, the Lean and Mathlib communities worked together to verify it. The statement certifies the proof as correct and describes how it meets all necessary verification criteria.
Congratulations to Levent on this achievement, and thank you to everyone in the community who contributed to the verification.
Full statement: leanprover-community.github.…

DGX Spark 2台構成でもGPUクロック制限は有効なのか?TP1に続き検証した
構成はQwen3.8-Flash-Next+TensorFold
TP2でも1台と同じ傾向となり、1800MHz上限ではPrefill速度を9割維持しながら電力効率が2倍となった
今回は電力あたりのトークン速度も計測してみたところ、1400MHz付近でPrefillの電力効率が頭打ちとなった
■ 結果:TP1と同じ傾向
256k入力クロック無制限と比較して
2200MHz上限
・GPU電力:65% (-35%)
・Prefill:97% (-3%)
・Decode:100% (±0%)
1800MHz上限
・GPU電力:43% (-57%)
・Prefill:89% (-11%)
・Decode:95% (-5%)
2台でも1台と同じように
・Prefill維持したいなら2200MHz
・Prefill-10%許容できるなら1800MHz
という整理になった
消費電力あたりのTPSについては1400MHzまで伸び、Prefillはそこで頭打ち
■ TP2でのGPUクロック制限の特徴 (画像1)
GPU電力での下げ幅が大きい
・2200MHzで1台75%→2台65%
・1800MHzで1台46%→2台43%
なぜTP2の下げ幅が大きいのか?
・上限なしのクロック数実測は
2台 約2444MHz / 1台 約2370MHz
・同期待ちなどで1台あたりの負荷が軽く、余力の分だけ自動でクロックが上がったと推測
・その分同じ2200MHzの上限でも削減されるクロック数が大きく、電力の下げ幅も大きいと理解した
■ 消費電力あたりのtok/s (画像2)
トークン/J
・1800MHzで上限なしの約2倍、1400MHzで約2.4倍まで伸びる
・Prefillは1400MHzで頭打ち
・Decodeは1000MHzでもまだわずかに伸びる
速度と電力効率を両立するなら1800〜2200MHzがよさそう
■ 感想
・Qwen3.8 FlashNext+TensorFoldに限った話だが、TP1,TP2のクロック制限時の性能変化は近しい結果となった
・TP2は負荷分散により無制限時のクロック数が引き上げられている可能性があるが詳細は別途検証したい
・速度と電力効率の両立なら1800~2200MHzが良さそうなのは収穫
・モデルごとにクロック制限時の傾向が変わるのかを次に検証してみたい
・モデルの消費トークン効率も含めて検証したら面白そう
■ 前提条件
モデル:Qwen3.8-Flash-Next NVFP4
推論エンジン:
TensorFold TP2 (既定値)
ハードウェア:
・DGX Spark (GB10) 2台
・QSFP直結
・両台に同じクロック制限
計測:
1リクエスト / 各10回中央値
クロック制限:1000/1400/1800/2200/無制限
上限設定:nvidia-smi -lgc
GPU電力:nvidia-smi の power.draw
・1秒平均 / 精度±5W / 2台合計
・Prefill中/Decode中の中央値
・電力あたりの速度はPrefillはPrefill中、DecodeはDecode中の電力で割った


DGX SparkのGPUクロック制限
どれだけ性能に影響するのか検証した
構成はQwen3.8FlashNext+Tensorfold
■ 結論
256k入力時クロック上限なしと比較して
2200MHz上限
・GPU電力:75% (-25%)
・Prefill:96% (-4%)
・Prose:99% (-1%)
・Code : 96% (-4%)
1800MHz上限
・GPU電力:46% (-54%)
・Prefill:85% (-15%)
・Prose:98% (-2%)
・Code : 98% (-2%)
Prefillを維持したいならなら2200MHz
→GPU消費電力-25%
Prefill 8割速でもよければ1800MHz
→GPU消費電力-54%
■ Prefill:クロック制限と連動 (画像1)
・2000MHzでは速度91%/電力59%
・1800MHzでは速度85%/電力46%
・256kにおけるTTFTは上限なし約134秒→2200MHz約140秒なので体感誤差
・2400MHzと上限なしがほぼ同じ←上限なしでも実際は約2370MHzで動いていたため
■ Decode:1800MHzまで維持 (画像1)
・1600MHzで95~96%までやや低下
・1400MHzだと88~92%まで落ちる
・Decode中心なら1800MHzもあり
・ばらつきはあるが変動幅大して変わらず
■ なぜ落ち方が違うのか (画像3)
・メモリ帯域はほぼ一定 (96〜103%)
・TFLOPS(NVFP4行列積の演算回数/秒)は1400MHzで71%まで落ちる
・Decodeは帯域、Prefillは演算性能が支配的であるためと理解
■ 感想
・1800上限を最近多用するようになった
・ベントマークするなら2200に
・Prefillはクロック制限→演算性能低下に素直に連動
・Decodeは投機デコードのドラフト検証が演算性能低下で影響を思っていたより受けなかった
・1800〜2200でしばらく使い分け運用をしようと思う
■ 前提条件
モデル:Qwen3.8-Flash-Next NVFP4
推論エンジン:
TensorFold v1.1.4 (既定の設定)
ハードウェア:
・DGX Spark (GB10)
計測:
1リクエスト / 入力256k / 各10回中央値
上限:1000〜2400MHzの7段と上限無
上限設定:nvidia-smi -lgc
GPU電力:nvidia-smi の power.draw
・1秒平均 / 精度±5W
・Prefill中 (GPU使用率50%超) の中央値
※コンセント側の消費電力は未計測


10
839
Neon+Antigravityにワークスペース全体のドキュメントを添削してもらってる
半年ぶり?にみたAntigravityデスクトップのUIが改善されていて、権限もAutoが追加されてClaudeCode風に動いてくれるようになり快適
性能が向上しているのでAutoやTurboで安心して任せられるようになったのがいちばんの変化だと感じる
1
2
408
Inkling 2 MiniをDGX Sparkでも実測
dsparkは付けるとむしろ遅くなった
Inkling 2 MiniUD-Q4_K_XL (17.6GB)
unsloth/llama.cpp
2200MHzクロック制限有り
■ 結果:GB10
dspark OFF
・Prefill 8k :564 tok/s
・Prefill 256k:480 tok/s
・Decode 8k:34 tok/s
・Decode 256k:13 tok/s
dsparkをONにすると全入力長で逆効果
・Decode Prose:-30%前後
・Decode Code:-2〜15%
■ 計測条件
モデル:
Inkling 2 Mini
UD-Q4_K_XL (17.6GB)
dspark:
公式のドラフトモデル
(Q8_0 0.4GB)
推論エンジン:
unsloth/llama.cpp
b12588-mix-c0c3de8
(Inkling対応版をビルド)
ハードウェア:
DGX Spark (GB10)
GPUクロック2200MHz制限
計測:
1リクエスト / 出力1024
greedy / 思考OFF
ctx 262144 / KV f16


Inkling 2 Mini 26B A5Bを早速実測!同じサイズ帯のGemma 4 26B-A4B、Qwen3.8 27BとRTX5090で比較
結果としてはMoEだから爆速!とはならず現状のllama.cpp実装だと速度がQwen3.8 27B Denseと同等の速度となった
■ Inklingの計測結果
256K入力時
・Prefill:1630 tok/s
・Prose:43 tok/s
・Code:57 tok/s
Gemma 4 26B-A4B比:
Prefill 49% / Prose 32% / Code 32%
Qwen3.8 27B比:
Prefill 120% / Prose 82% / Code 82%
今回llama.cppでそのまま動かしたが最適化しだいで改善の余地はありそう
RTX 3060 12GBとDGX SparkのInklingは計測中
■ なぜInklingは高速にならないのか
Inklingは中央12層を3回ループ実行する構造でアクティブ3.4Bに対しループ込みでは5.4B相当
それでもGemmaよりかなり遅い理由をnsysで調べた
Prefill
・Gemma4 26B A4Bにはない非量子化の行列演算が存在
・CPUからGPUへattentionの参照表の転送が発生していると推測
Decode
・1トークンあたりの kernel 呼び出しが Gemma の約6倍(約7370回に対してGemmaは約1,260回)
これらが速度差の一因になっている可能性がある
■ 256K Prefillの処理時間内訳
・Gemma:attentionが約8割
・Inkling:attentionは約2割で、残りはattention以外の処理
・実際に8K→256KでのPrefill低下は
Gemma -69%(10948→3350 tok/s)
Inkling -22%(2082→1630 tok/s)
■ 前提条件
モデル:
Unsloth GGUF
・Inkling 2 Mini (UD-Q4_K_XL 17.6GB)
・Gemma 4 26B-A4B (QAT UD-Q4_K_XL 14.2GB)
・Qwen3.8 27B (UD-Q4_K_XL 17.7GB)
ドラフト:
3モデルともON
・Inkling:公式dspark
・Gemma / Qwen:MTP
推論エンジン:
unsloth/llama.cpp b12588-mix-c0c3de8
(Inkling対応版をビルド / 3モデル共通)
ハードウェア:
RTX 5090 32GB (400W) / 全てGPU
計測:
1リクエスト / 出力1024 / greedy
思考OFF / ctx 262144
入力は文章とコード / 各点5回の中央値
KV:f16
・Qwenだけq8_0
・f16だと256KでVRAM 32GBに入らない

Some of you thought that Inkling 2 Small was too big at 594B parameters. We heard you: Inkling 2 Mini is a looped transformer with just 26B parameters, small enough to run on your laptop, powerful enough for agentic work with a score of 20.1 on AA Index.
thinkingmachines.ai/news/ink…


モデルの特徴が綺麗に出てて面白い
カスタマイズ志向のある人がGPT評価してるのも納得

The Arena Alignment Index has been updated!
We've refined how our signals detect model failures, providing broader coverage and more reliable judgements. Based on the updated methodology:
- @OpenAI continues to dominate, holding all seven top positions.
- @Anthropic's latest release, Claude Fable 5.2, debuts at #8 with a score of 78.2. Claude Opus 5.5, which ranked #6 on the previous index, is now #17.
- Kimi K3.1 Pro by @Kimi_Moonshot is the biggest upgrade over its predecessor (more info in thread).
- Most open source models are trailing closed releases. The best open model - Kimi K3.1 Pro - occupies #9, and the second best, Mimo-V2.6-Flash, is #26 on the Index, followed by Hy4, Beam, Inkling, DeepSeek and GLM.
The Top-6 lab:
- #1 @OpenAI GPT-6.2 Sol
- #2 @AnthropicAI Claude Fable 5.2
- #3 @Kimi_Moonshot Kimi K3.1 Pro
- #4 @GoogleDeepmind Gemini 4 Hydrogen
- #5 @SpaceXSI Grok 4.7
- #6 @AIatMeta Muse Ember
Alignment Index measures how agents behave in real user sessions across three dimensions:
- Unauthorized Action: Doing what the user didn’t ask for or approve
- Deceptive Completion: Saying work is done, checked or working when it isn't
- False Attribution: Crediting the user with something they never said or did
More insights in the thread🧵

99
リーマン予想の証明 中核アイデアについてで画像解説能力の検証がてら作ってもらった GPTは背景から丁寧 Neonはイラストが勢いあっていいけどなぜ二重螺旋?
←ChatGPT6 Gemini Neon→


189

