

Developer and student at icu : novel 4DGS systems,3DGS, and Temporally stable depth video, pushing the limits of VR/XR. 最近はローカルLLMも。おかげて暖かい足元にねこが一緒に寝てくれて毎日ハッピー
Tokyo
Joined November 2024
- Tweets113
- Following53
- Followers2.8K
- Likes81




Pinned Tweet
品質はまだまだだけどフルスクラッチ・自作の商用利用可能な4DGSシステム出来てきた。3DGS連番のパラパラ漫画方式じゃないし、RTX4090レベルでトレーニング可能。
比較しやすいように試しによく使われてる4dvのcorgiデータでも試した。(自作の撮影の方では36台のXperiaを使ってる)
#4dgs
PentaCoxian retweeted

このモデルを更に強く無検閲化しつつ精度を高めるために協力して取り組んでいます!
CoxianさんはThinkingのループを大規模なFTなしで抑制する革命的な方法を実現してくれました。そのアイディアと、僕が作った倫理観が無いモデルを作った方法を組合せてより良いAblitretedモデルを目指します🚀

Released: DeepSeek-V4.1-1017-Ablitrated-Efficient
(built on @Hikari_07_jp’s testmodel)Layer-selective abliteration + targeted fixes for thinking loops and re-verification.
HF: huggingface.co/pentacoxian-d…

Released: DeepSeek-V4.1-1017-Ablitrated-Efficient
(built on @Hikari_07_jp’s testmodel)Layer-selective abliteration + targeted fixes for thinking loops and re-verification.
HF: huggingface.co/pentacoxian-d…
Fix (3 small weight edits):
Output-head boosts so </think> and EOS fire when looping or already done
Amplify the model’s own “I already have the answer” signal in a few middle layers
Result: greedy loops 19% → 0, re-verification ~38% shorter, MMLU and correctness unchanged.
Overall: • Harmful refusal ~5% • Near-base capability • 99%+ completion rate (vs other abliterated 1017s that mostly loop)
Still not fully uncensored; minor tool quirks remain.
@Hikari_07_jp and I are already working on a new version that pushes refusals lower while keeping this efficiency and stability.
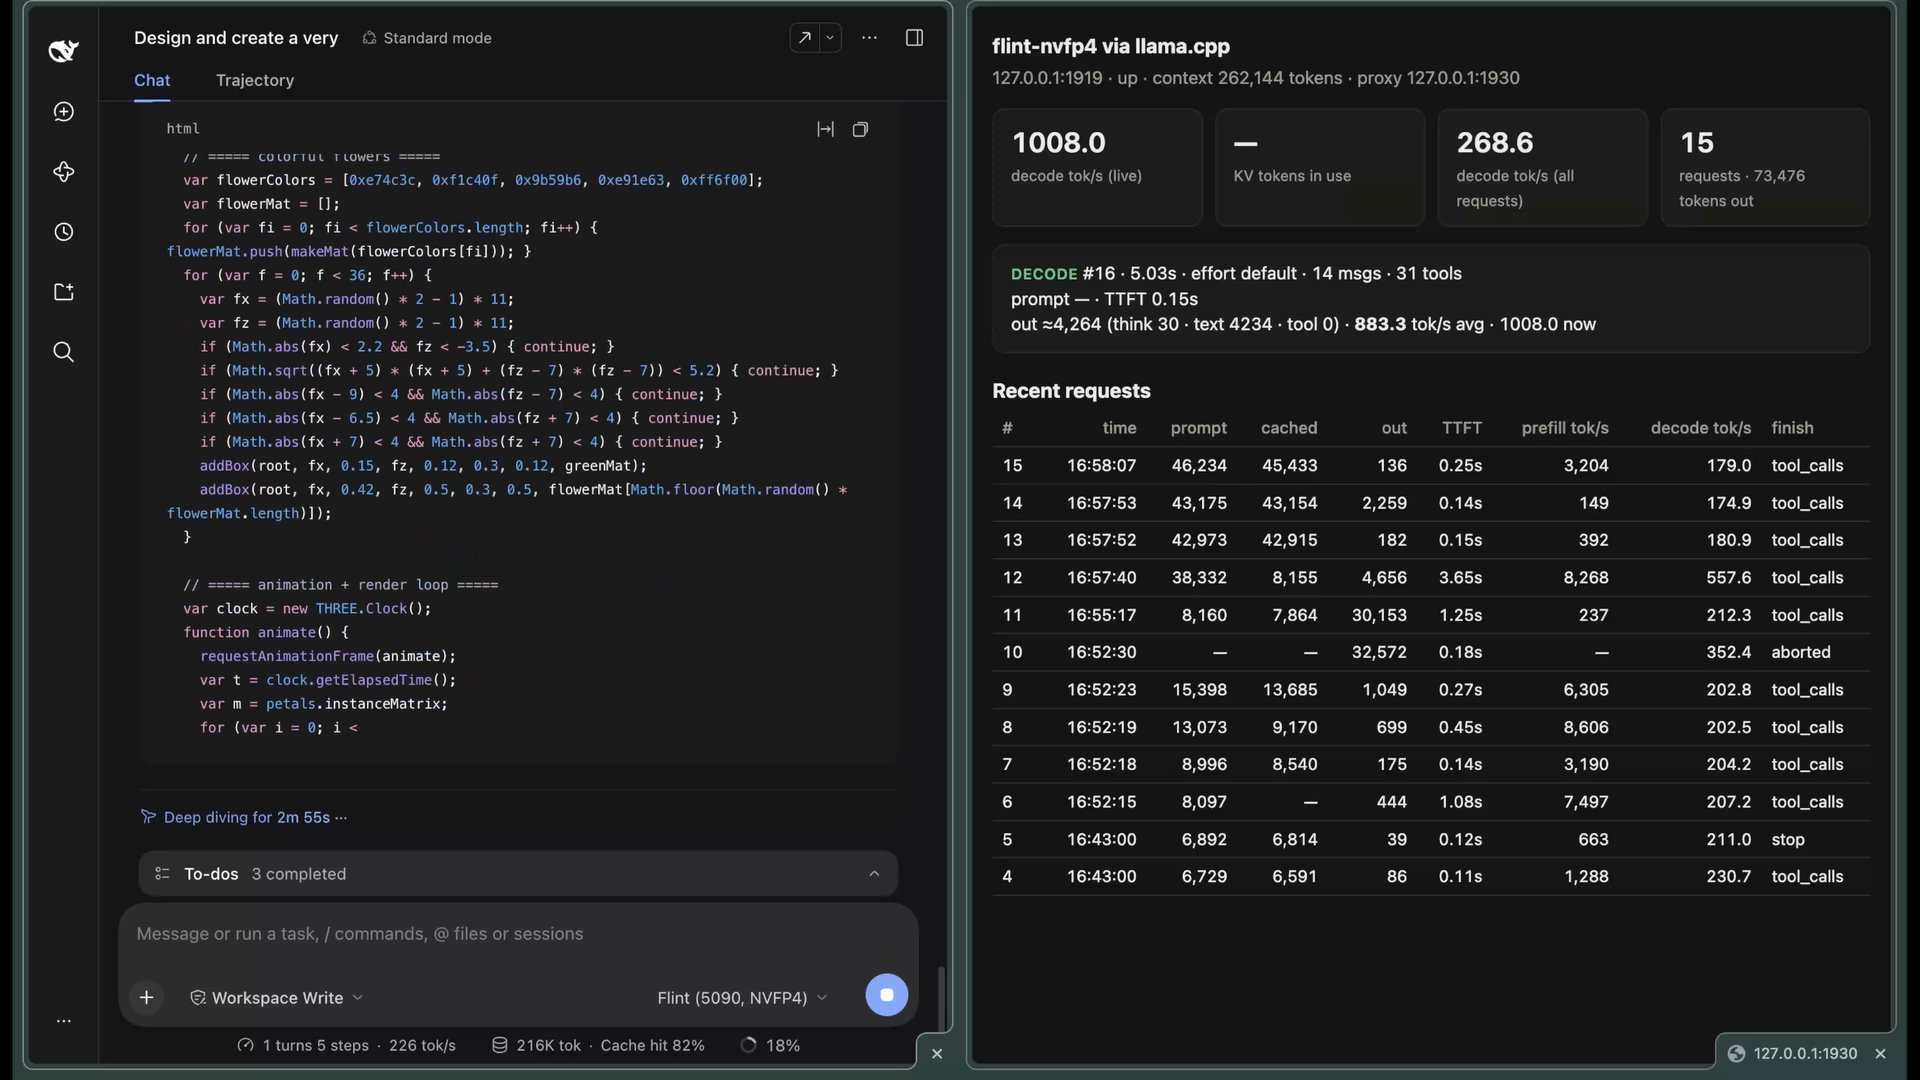


add a 2nd gpu for quantized Dspark (around 6GB) and you can get good enough speed for a local machine...
random coding task shown below :)

EngramはSSDでおk。
RAM192GB/VRAM32+12GBだったら5070に量子化したdspark乗るしエキスパートをIQ2_S + IQ3_XXS downとかにしてあげれば平均80tok/sくらい出るんちゃうかな🤔

ということで地元のdeepseek-1017量子化モデルも作って測ってみた〜
エキスパートはQ3K+Q2Kに量子化。今回はramを少し増量して、5090+ram192GBに入るよう調整した。
結果は自作推論基盤でプレフィル約1100toks、デコード平均73.9toks、ピーク98toks
一般構成とは言えないけどまぁまぁな速度出るね…


PentaCoxian retweeted

ローカルで動く「無料」の音声合成、
ここまで来ました🎧
制作中のゲーム『終電幻灯』の同じセリフを、1つずつ聞き比べ。
A:クラウドTTS(Gemini 3.8 Flash TTS)
B:自宅のRTX 3060(12GB)で動かした drama3-small
B はすべてローカル生成なので、API料金はゼロ。生成速度もほぼリアルタイムです。
演技の指示は、セリフに [laughs through tears] のように英語で書き添えるだけ。
一度作った声は保存して、何度でも使い回せます。
今回は各セリフを3テイクずつ生成し、音声認識で読み間違いのないテイクを選びました。
いちばん聴いてほしいのは、九条の泣き笑い「……っ、はは。とんだ手品だ」。
A と B、あなたはどっちの演技が好きですか?
使用モデル:drama3-small(Fish Audio Drama 3 のオープンウェイトを有志が軽量化したもの)
Built with Fish Audio 🐰
🤖 Made with AI


I made a real-time translate for overseas listeners for @Hikari_07_jp live today!
watch the live and translate real-time from the links below!
subs: kome.pentacoxian.dev/
X live: xitter.cf/i/broadcasts/1pKkOXwXV…


PentaCoxian retweeted

drama3-small、Fish Audio Drama 3を12GBのVRAMで動くようにしたモデルで、ローカルでこの声が出せるのは嬉しいですね!
参照音声からのボイスクローンも試してみましたが、声も良い感じによってくれます😊
ColabでローカルTTSを試せる『Local TTS on Google Colab』にも追加させていただいたので、手元にGPUがない方でもColabから試せます。ぜひ!
github.com/shinshin86/local-…
🤖 Made with AI
Fish Audio Drama 3(35B MoE TTS)を、12GB VRAMで動かせる日英共に自然な「drama3-small」を公開します!
元モデルはFP8で48GBクラス必須・ファイルも40GB前後なのに対し、こちらは 約9.7GBに圧縮。ピークVRAM約10.3GBで、RTX 4070クラスでも(たぶん)動きます。
ゼロショット音声クローン(3〜30秒参照)、[laughs][sighs]タグ、英語スタイル指示、日本語+英語技術用語混在に対応。このモデル特有の文境界の沈黙ハマりも修正パッチ付きでかなり減っています。
RTX 4090で生成音声の約2.6倍速生成、5090で約3.2倍速。ストリーミングでも1.5倍以上。
HFで生成品質の確認も出来るので是非試してみてください!
#地元のLLM #LocalLLM #TTS #Drama3
PytorchネイティブのComfyUIノードも出しました!
windowsの場合はwindows-tritonをご利用ください。vram6GBでも収まる(はず)。
github.com/pentaCoxian/Comfy…

Fish Audio Drama3ベースのTTS、Drama3-smallのcomfyUIノード出しました!CPUオフロードとストリーミングオプションを利用するとVRAM占有率4.5GBまでフットプリント小さく出来ます。ぜひ試して見てください〜
#Drama3
Fish Audio Drama 3(35B MoE TTS)を、12GB VRAMで動かせる日英共に自然な「drama3-small」を公開します!
元モデルはFP8で48GBクラス必須・ファイルも40GB前後なのに対し、こちらは 約9.7GBに圧縮。ピークVRAM約10.3GBで、RTX 4070クラスでも(たぶん)動きます。
ゼロショット音声クローン(3〜30秒参照)、[laughs][sighs]タグ、英語スタイル指示、日本語+英語技術用語混在に対応。このモデル特有の文境界の沈黙ハマりも修正パッチ付きでかなり減っています。
RTX 4090で生成音声の約2.6倍速生成、5090で約3.2倍速。ストリーミングでも1.5倍以上。
HFで生成品質の確認も出来るので是非試してみてください!
#地元のLLM #LocalLLM #TTS #Drama3