

Senior Software Engineer. Testing AI models on real-world projects. What works, what doesn’t, at what cost ↓
France
Joined September 2015
- Tweets1.4K
- Following3K
- Followers7.4K
- Likes7.3K




Pierre ✺ retweeted

Everyday tasks? No sweat. Faster graphics? Nailed it. On-device AI? You bet.
It’s the new 14-inch MacBook Pro and iMac, faster than ever and supercharged by M6.
Pierre ✺ retweeted

Si vous passez déjà vingt minutes aux toilettes avec votre téléphone, ouvrez GTA V dans le navigateur. Jambes lourdes garanties, si le téléphone tient le coup.
gta.deloskiyt.pl
Pas d'appli, pas de cloud gaming : c'est votre téléphone qui fait tourner le moteur de Rockstar. Derrière la blague, il y a un sacré travail d'ingénierie.
1/ Le code source de GTA V a fuité fin 2023, après le piratage de Rockstar. Quelqu'un l'a traduit en WebAssembly, une sorte de langue universelle que tous les navigateurs savent exécuter presque aussi vite qu'un vrai logiciel.
2/ Le jeu a été écrit pour parler à la carte graphique d'un PC Windows. Un interprète se glisse au milieu : le jeu croit toujours parler à Windows, et l'interprète traduit chaque ordre dans la langue graphique du navigateur.
3/ Le jeu complet pèse plus de 20 Go, mais il reste sur le serveur. Votre navigateur ne télécharge que les morceaux dont il a besoin, au fur et à mesure que vous avancez dans la ville, un peu comme Netflix charge un film.
Ce genre de chantier, c'était des mois de travail pour une équipe de spécialistes. Celui qui a montré le jeu le premier explique qu'il a été porté avec l'IA.
Le site d'origine a sauté en quelques heures. Celui-là est une copie, et il risque de tomber à son tour. Profitez-en tant qu'il est là.
Pierre ✺ retweeted

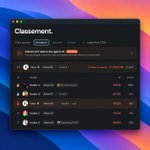
we're ranking people on who is working the most, with regularity, insane focus, no distraction
join the competition.

🏆 top #5 deep workers of the week
who are they?
1. Pierre
senior software engineer
2. max
building RANGEWX, making cybersecurity training accessible
3. flosrn
full-stack developer, freelance
4. Le Chat
marketing digital & SEO
5. Mowgli
building 3D workspace, interactive strips, prototypes

Pierre ✺ retweeted
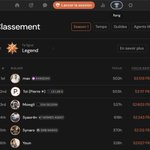
Pierre, légende du Lab X, est désormais numéro 1 sur @Promethee_io, une app géniale avec beaucoup d’engouement de la communauté pour être proactif et monter dans le ladder aux yeux de tous!
C'est acté : comme je suis moins actif, et pour le récompenser, je lui confie le rôle de créateur du Lab X sur Promethee. C'est aussi une façon de le remercier de faire vivre notre communauté au-delà du groupe Telegram.
Donc pour nous rejoindre, envoyez un MP à @pgllmt, builder et vrai charbonneur. Et suivez-le sur X : il partage beaucoup sur l'IA, toujours de qualité.

🏆 #1 Legend on Prométhée (Strava for builders)
Barely. Max is 97 points back.
Locked in today. Finishing the week first !

Pierre ✺ retweeted
Supersocks dans Silicon Carne !!
Merci au grand Carlos pour l'invitation. Vrai plaisir de débattre une vingtaine de minutes de la sortie de Mistral Large 4 avec deux monstres, @JiliJeanlouis et @epelboin. Ça commence à 53''.
Ce qu'on s'est dit :
1) Les chiffres seuls ne font pas rêver : 1 000 milliards de paramètres, 49 milliards actifs, environ 4 000 GPU entraînés en France, 38 à l'indice Artificial Analysis, au niveau de GPT-6 Luna. Pas devant les modèles chinois, mais la France monte sur le podium, 3e après les US et la Chine.
2) Pour Jean-Louis, le vrai sujet est ailleurs : une architecture maison, pas de distillation, leurs propres données et leur propre compute. Ils savent enfin faire leurs pizzas eux-mêmes. Pas encore la meilleure margarita, mais ils ne dépendent plus de personne.
3) Pour moi, c'est un point de départ. Arthur l'a confirmé : il reste de la marge en RL et le modèle va s'améliorer. Sur les benchs cyber, il passe déjà devant Luna, et il se défend bien en finance et en juridique. La cible, c'est le B2B qui veut héberger son modèle chez lui, et la bataille de l'agentique. Un first of a kind, pas un pilot.
4) Le vélo aux roues qui tournent à l'envers fait rire sur X, mais un test du pélican ne dit pas grand-chose de la valeur d'un modèle.
5) Carlos a posé la bonne question : « suffisant », d'accord, mais jusqu'à quand, au rythme où vont les autres ? Jean-Louis a conclu : difficile de faire des margaritas si on t'interdit la tomate, c'est-à-dire les retours des utilisateurs.
Si SC en parle, c'est forcément qu'il y a du bon… oups
La pâte à pizza est prête, il ne reste plus qu'à y mettre les bons ingrédients.


Pierre ✺ retweeted
19h pour le live !! L’afterwork agentique de ce vendredi avec les membres du Lab X notre groupe telegram et quelques invités.
On fera monter ceux qui veulent partager leurs projets et leurs usages de l’IA

Pierre ✺ retweeted
Petit live demain soir avec les membres du Lab X, notre communauté Telegram !
Rendez-vous à 19h ici sur X.
On parlera de l’actu IA, de nos usages au quotidien et, bien sûr, on vous fera découvrir un peu plus l’envers du décor de notre communauté.

Pierre ✺ retweeted
introducing Promethee, an app that turns your work into a multiplayer game, to perform.
now available for everyone.
promethee.io
Pierre ✺ retweeted
Ils nous a bait sur demain : où ça va tomber ? Astra consomme toujours autant, les 100 % sont partis dans la journée. Ne nous oublie pas, Tibo : samedi à 10 h PST, c’est trop tard, c’est le reset quoi qu’il en soit.

Pierre ✺ retweeted
Plus de 40 personnes en live pour le Space improvisé d’hier, c’était bien sympa ! On était juste un peu trop absorbés par la présentation d’OpenAI pour beaucoup discuter 😅
Merci à @leploutos, @pgllmt, @optimikee, @leonardoballand et aux membres du Lab X qui sont passés prendre le micro et contribuer. Et bien sûr, merci à tous ceux qui nous ont écoutés !
Je retrouve avec le Lab X une ambiance que je n’avais pas connue depuis mes meilleures guildes sur WoW. On est plus de 250 à partager ce qu’on builde depuis mars, ce qu’on essaie d’apprendre, ce qui marche et ce qui coince. Ces moments improvisés prolongent les échanges qu’on a tous les jours sur Telegram.
La communauté est gratuite et ouverte à tous les profils. Pour nous rejoindre : le-lab-x.com
Et promis @RayaneRachid_, la prochaine fois, on arrivera à te faire monter 😂

OpenAI DevDay 2026 : on le vit ensemble.
Ce soir 19H sur X Space avec Les membres du Lab X, @leploutos , @leonardoballand, @pgllmt et quelques invités.
Live, réactions, annonces et débrief à chaud.
See you there. 🫡

Pierre ✺ retweeted
OpenAI DevDay 2026 : on le vit ensemble.
Ce soir 19H sur X Space avec Les membres du Lab X, @leploutos , @leonardoballand, @pgllmt et quelques invités.
Live, réactions, annonces et débrief à chaud.
See you there. 🫡
Pierre ✺ retweeted

Please welcome GPT-6 Sol and GPT-6 Luna to the GPT-6 universe.
GPT-6 Sol and Luna build on the advances behind GPT-6 Astra, bringing much of its strengths into faster and more affordable models to support work at scale.
We’ve also made caching and inference more efficient, and we’re passing the savings directly to you: 50% lower API prices for Sol and Luna compared with GPT‑5.6 promotional pricing.

Pierre ✺ retweeted
GLM 5.3 Flash n’est pas le modèle auquel je confierais seul une décision d’architecture.
En revanche, c’est peut-être celui auquel je confierais le volume : audits, correctifs cadrés, documentation, sous-tâches et itérations.
J’ai détaillé où il est vraiment intéressant, et où il vaut mieux choisir un autre modèle ↓

Pierre ✺ retweeted
Je pense qu’on sous-estime encore complètement ce qu’est en train de devenir Grok Bot.
Je l’utilise sur mon ordinateur de travail, configuré comme un agent GTM avec ses propres instructions et son propre environnement. Il n’a pas besoin d’obtenir des permissions sur le poste ni de fouiller directement dans mes fichiers : il travaille dans sa VM.
Sur cet aspect, on se rapproche davantage de GPT Work que d’un simple chatbot.
L’interface est très bonne, l’interaction est naturelle et, surtout, on dispose des plugins Cursor. À partir de là, on peut déjà pousser le produit beaucoup plus loin que ses usages par défaut.
Composio est également très intéressant pour ajouter rapidement un grand nombre d’applications et d’appels API. Pour tout ce qui vit dans le cloud, cela ouvre déjà énormément de possibilités.
Mais mes outils les plus importants ne vivent pas uniquement dans des SaaS.
J’ai d’un côté mon coffre Obsidian, dans lequel se trouvent mes projets, ma mémoire, mes décisions, mes recherches, mes instructions et une bonne partie des skills que j’utilise depuis longtemps.
De l’autre, j’ai Hermes, installé sur son propre serveur à la maison, connecté à son environnement et capable d’aller beaucoup plus loin qu’un agent enfermé dans la VM de Grok Bot.
J’ai donc poussé le concept un peu plus loin et créé deux plugins personnels.
Le premier transforme Obsidian en Librarian (mon bibliothéquaire) pour Grok Bot.
Depuis Grok Bot, je peux demander au Librarian de retrouver une décision, une note projet, une personne, une ancienne réflexion ou le contexte complet d’un sujet.
Le bridge donne un accès très encadré au coffre.
Le second plugin connecte Grok Bot à mon agent Hermes.
Hermes reste sur son serveur, avec ses propres instructions, ses outils et les accès à l’infrastructure hôte que j’ai choisi de lui donner. Mais je peux désormais le solliciter directement depuis l’interface de Grok Bot.
Cela ne remplace pas Hermes Desktop ni Hermes sur Telegram, que j’adore toujours utiliser.
Cela ajoute simplement une nouvelle porte d’entrée.
Je peux discuter avec mon agent GTM dans Grok Bot, demander au Librarian de retrouver le contexte d’un projet, puis solliciter Hermes lorsqu’il faut aller plus loin depuis mon infrastructure personnelle.
C’est là que les deux mondes se marient vraiment bien.
Composio et les plugins classiques donnent accès aux applications et aux API cloud.
Le bridge Obsidian donne accès à ma mémoire personnelle.
Le bridge Hermes donne accès à mon agent auto-hébergé et à ce qu’il sait faire depuis son propre environnement.
Et Grok Bot devient l’interface commune pour interagir avec tout ça.
Je ne cherche pas à remplacer les outils que j’utilise déjà. Je profite simplement de l’UI et de l’environnement proposés par Grok Bot tout en conservant Obsidian et Hermes là où ils sont les meilleurs.
Pour moi, c’est ça le power usage de Grok Bot : ne pas le considérer comme une nouvelle fenêtre de chat isolée, mais comme une interface sur laquelle on peut venir brancher sa propre stack.
J’ai mis les deux repos à disposition de ceux qui voudraient reproduire ce type de configuration ou construire leurs propres variantes :
GrokBot ↔ Obsidian Bridge github.com/iamsupersocks/gro…
GrokBot ↔ Hermes Bridge github.com/iamsupersocks/gro…

Hermes sur GrokBot, ça vous intéresse ?
Ce que j’aime avec GrokBot, c’est sa simplicité. Chaque bot tourne dans sa propre VM, le système est isolé et, sur mon PC du boulot, j’ai simplement eu à télécharger l’app.
Je m’en sers comme d’un petit groupe d’agents GTM pour le sales et la génération de leads. Tout reste séparé de mon environnement personnel, sans installation compliquée sur la machine.
À l’usage, je découvre quand même quelques complexités. GrokBot reste aussi assez limité face à Hermes : les power users atteindront vite ses limites dès qu’ils voudront contrôler plus finement leurs agents et leurs interactions.
Je me suis donc amusé à connecter Hermes à GrokBot.
Au lieu de passer par Telegram dans l’app web, j’écris à un bot GrokBot qui transmet la demande à mon Hermes sur le homelab, puis me renvoie sa réponse. GrokBot sert d’interface isolée ; Hermes conserve le raisonnement, la mémoire et les outils que j’utilise déjà.
Ça me permet aussi d’utiliser un quota GrokBot aujourd’hui largement sous-exploité, tout en gardant mon meilleur ami Hermes dans le bazar.
Le même principe pourrait fonctionner avec Codex ou d’autres agents. Ça ouvre pas mal de possibilités, même si mon montage actuel mérite sûrement de meilleures pratiques.
Si ça vous intéresse, je peux faire un petit repo GitHub pour vous permettre de reproduire le montage. Ce n’est pas très compliqué une fois les pièces alignées, mais ça m’a pris un peu de temps pour trouver le bon chemin.

Pierre ✺ retweeted

Après plusieurs mois de ponçage d’Hermes, de lecture de docs et de tests en tout genre, voilà mon guide ultime pour optimiser les tokens de tes agents Hermes.
Tools, skills, mémoire, cache, compression, subagents, MCP… 👇


Pierre ✺ retweeted
Qwen3.8-Flash 125b Now available!!

⚡Meet Qwen3.8-Flash, a multimodal MoE and an early preview of the Qwen4 architecture, now open-weight!
The production version Qwen3.8-Flash will be available soon via QwenCloud API at just $ 0.16/1M input tokens and $ 0.47/1M output tokens.
125B parameters + 51B N-gram embeddings, with just 6B activated per token. Unmatched cost-efficiency.
What's new: 🥳
- Next architecture: GDN + QSA hybrid attention, Gated Residual, N-gram Embedding & Muon optimizer, serving as a precursor to the architecture used in Qwen4.
- Dramatically lower training and inference costs: trained at just 1/9 the cost of Qwen3.7-Plus, while outperforming it across the board with especially strong gains in coding and office tasks.
- Strong performance: scoring 58.7 on DeepSWE 1.1, 62.5 on SWE-bench Pro, 73.9 on CoWorkBench, 84.5 on AndroidWorld, and 95.7 on MathVision (with CI).
- 262K native context, extensible to 1M with YaRN.
We’re also releasing the weights for Qwen3.8-Flash-Next, giving the community an early look at the new architecture we’re exploring for Qwen4.🚀
We can't wait to see what you build with Qwen3.8-Flash!👀👇
- Blog: qwen.ai/blog?id=qwen3.8-flas…
- Technical Report: github.com/QwenLM/Qwen3.8-Fl…
- Hugging Face: huggingface.co/Qwen/Qwen3.8-…
- ModelScope: modelscope.cn/models/Qwen/Qw…
