

Fondateur Agence @JIN_liveFR 🤖 #IA fan - Auteur du Manuel de Survie à l’IA (2025)
Paris
Joined May 2008
- Tweets20.7K
- Following2.6K
- Followers9K
- Likes4.4K






C’est assez détestable en plein lancement du nouveau modèle de Mistral qui est plutôt correct et remet l’Europe au niveau des Chinois.
Et c’est sur qu’avec un modèle Chinois entraîné au charbon et avec la ligne du PCC Ecosia sera un vrai emblème de souveraineté et d’écologie.

Le foutage de gueule par Ecosia pour tacler Mistral est total et ça me rend très en colère. Je passe sur le fait que le nucléaire français serait un problème écologique. Débile mais habituel en Allemagne. Leur autre argument sur le fait que Mistral ne serait pas tout à fait européen, et que ça ne serait pas conforme aux engagements de souveraineté numérique européenne d'Ecosia, mise sur la grande crédulité d'internautes mal informés, et ça ce n'est pas acceptable.
J'ai toujours applaudi la joint venture formée entre Ecosia et Qwant pour créer un service commun de résultats de recherche européens, et je leur souhaite de réussir. Mais elle est encore loin de fournir aux deux parties leur indépendance technologique. Ecosia continue à servir très massivement les résultats fournis par les API de Bing et Google. C'est même écrit en toutes lettre sur leur site : "Les résultats de recherche et les publicités associées sur Ecosia proviennent de nos partenaires Microsoft Bing, Google et EUSP (European Search Perspective)" (fr.support.ecosia.org/articl…).
La joint-venture entre Ecosia et Qwant devait servir à accélérer la souveraineté numérique européenne. Pas à permettre à un acteur allemand de venir cracher dans un média américain (Politico) sur un acteur français en lui reprochant d'avoir des investisseurs américains, alors que lui-même voit la très grande majorité si ce n'est l'intégralité de ses revenus versés par Microsoft et Google.
Ce n'est pas correct et de mon point de vue c'est même révoltant. Je vous encourage à ne plus utiliser Ecosia.
Quand un médecin ou un patient pose une question de santé à ChatGPT, la réponse ne vient pas forcément des médias que l'on vise en RP.
Sur 43 médias santé de référence, 9 interdisent à la recherche ChatGPT de lire leurs pages, dont Le Figaro, Les Echos, BFM, France Info et l'APM. Ils restent visibles dans Google, jamais dans ChatGPT.
Côté médecins, dans les réponses IA de Google, La Revue du Praticien est citée 11 fois plus que Le Quotidien du Médecin, avec moins d'audience.
Ce sont les premiers relevés de l'étude JIN Health menée sur des centaines de requêtes de patients et de médecins, dans 10 aires thérapeutiques (diabète, cancer du sein, Alzheimer, endométriose...).
Nathalie Lauer et Anne-Laure Brisseau présentent les résultats le jeudi 15 octobre à 11h30 : quelles sources ChatGPT, AI Overviews et Gemini retiennent, et comment bâtir une stratégie RP conforme qui rend votre information citée.
45 minutes + Q&A. Inscription : watch.getcontrast.io/registe…
Mistral 4 est loin des IA frontières US, mais permet d’espérer un certain niveau de souveraineté. Bonne analyse à lire.

Quelques points sur Mistral pas encore lus dans le débat public :
1. mistral large 4 est exactement aussi bon que ce que les Américains arrivent à produire à puissance de calcul égale. Cela signifie que l’écart est désormais sur de la taille de centre de calcul, probablement pas sur la compétence.
2. Étant données les prévisions de montée en charge de Mistral dans le calcul, ils devraient pouvoir produire un modèle de niveau Opus 5.5 dans 12 à 18 mois.
3. Cela peut paraître lointain, mais il faut bien comprendre à quoi ça sert d’avoir des modèles français. Essentiellement, au-delà de la question que tout le monde connaît de sécurité des données et de dépendance étrangère pour le fonctionnement de ses entreprises, à deux autres choses : 1. La souveraineté régalienne. 2. La balance des paiements.
La souveraineté régalienne aujourd’hui se joue avant tout sur la cybersecurité : la capacité à sécuriser son infrastructure militaire et civile de façon autonome pour ne pas être vulnérable aux IA étrangères.
Surprise surprise, Mistral Large 4 est particulièrement bon dans ce domaine. Ce n’est bien sûr pas un hasard.
La balance des paiements : le grand risque qui nous pend au nez, c’est que les entreprises françaises dépensent en masse en tokens américains, et souvent au détriment des salaires français, ce qui a pour conséquence que l’argent français s’enfuie de l’autre côté de l’Atlantique, vidant notre pays de ses richesses.
Or pour des usages entreprises, la course à la frontière n’est pas infinie. Quiconque a déjà utilisé opus 5.5 avec son harnais cowork sait qu’il y a déjà de quoi faire fonctionner l’essentiel des postes de l’économie de services. En d’autres termes nous arrivons en haut de la sigmoïde : les progrès subséquents des modèles frontières seront clés pour le progrès scientifique, pour des usages très avancés, mais pas forcément pour suppléer les fonctions marketing et comptabilité des boîtes du cac40.
Nous sommes donc à 18 mois d’avoir un Mistral qui peut faire le gros de ce dont a besoin l’économie française. Et ainsi stopper l’hémorragie de cash.
4. Le goulet d’étranglement est de plus en plus le harnais, la couche d’orchestration et d’exécution qui permet au modèle d’évoluer dans des environnements complexes, de se connecter à des outils, de gérer de multiples agents en parallèle, etc. Or il se trouve que nous avons en France aussi Dust, qui excelle sur cette couche. (Encore un truc de X d’ailleurs. Avez-vous pensé à remercier Napoléon et ses blocs de granit récemment ? Parce que de la même façon que nous vivons encore 75 ans plus tard sur les efforts de De Gaulle avec la dissuasion et le parc nucléaire, nous vivons en bonne partie sur de l’héritage TECHNOLOGIQUE napoléonien. Pour la Patrie les sciences et la gloire les amis.)
5. Pour continuer le parallèle. De la même façon que notre dissuasion nucléaire est toute petite par rapport à l’américaine ou la russe, mais que comme disait De Gaulle, on hésite à attaquer un pays qui peut tuer 80 millions de tes habitants en un instant, même si toi tu peux raser la France, la France est en train de construire une indépendance IA de taille réduite, mais rendant le service effectif minimum pour rester une véritable puissance. Et la France est le seul pays sur terre aux côtés de la Chine et des US à réussir cela. Au lieu de pleurnicher sur le fait que ML4 ne fait pas de jolies fusées en vectoriel, on devrait plutôt prendre du recul et se rendre compte de l’immensité de l’accomplissement.
6. Rien n’est joué et tout peut s’écrouler bien sûr. La survie d’une nation se joue à chaque instant.
Il faut encore monter en charge, construire masse de nucléaire et de centres de calcul, développer une industrie de puces d’inférence. Dans un contexte de chaos.
Mais merde. Même à terre, même après des décennies de déréliction, la France reste la France.


La startup Tavus annonce que son avatar vidéo Griffin a passé « le test de Turing ». Dans son étude, 26 participants sur 54 ont cru parler à un humain après un appel d'une minute (48%). Avec son modèle précédent, c'était 1 sur 41.
Impressionnant, mais pourtant : le test de Turing est déjà passé.
En 1950, Alan Turing décrit son « jeu de l'imitation ». Un juge discute par écrit avec un humain et une machine, puis désigne l'humain.
Turing prédit que vers l'an 2000, un juge moyen n'aura pas plus de 70% de chances de démasquer la machine après cinq minutes d'échange. Autrement dit, elle le trompera au moins 3 fois sur 10.
En 2014, le chatbot Eugene Goostman revendique la victoire avec 33% des juges trompés, juste au-dessus du seuil de Turing. Il se présentait comme un ado ukrainien de 13 ans, ce qui excusait ses fautes. Le résultat a été largement contesté.
LE VRAI TEST A EU LIEU EN 2025
Deux chercheurs de l'UC San Diego refont le test avec le protocole d'origine (284 participants, cinq minutes de conversation en parallèle avec un humain et une IA). GPT-4.5, à qui on avait demandé de jouer un jeune introverti qui écrit en argot internet, est désigné comme l'humain dans 73% des cas. Plus souvent que les vrais humains qui lui étaient opposés. Sans ce rôle, il tombe entre 28% et 42% selon les panels.
L'an dernier, on apprenait qu'un faux Brad Pitt a soutiré 830k€ à une Française avec de fausses photos et vidéos retouchées maladroitement.
Que se passera-t-il quand des visios hyperréalistes pourront cibler automatiquement, et par milliers, des personnes qui cherchent juste quelqu'un à qui parler ? à gagner 10% par an ? Ou tout simplement à stopper la fraude que notre banque vient de nous éviter de justesse ?
Dans ce climat de méfiance, le plus dur sera-t-il de prouver que nous sommes réellement humains ?
Démo Tavus : linkedin.com/posts/hassaanra…
Étude UC San Diego : arxiv.org/abs/2503.23674
Faux Brad Pitt : franceinfo.fr/economie/media…
Ce week-end, entre deux pérégrinations pour les loisirs des enfants, j'ai eu envie de pousser un peu Pangram, qui a fait beaucoup de bruit après la détection d'IA dans un possible futur Goncourt (finalement exclu, j'en parlais ici : teapawt.net/referencement/status/2…).
Pour avoir testé ce type d'outil par le passé, j'étais assez confiant : je pensais arriver vite à faire passer un contenu 100% IA sans être détecté.
Je suis parti d'un article long de plusieurs milliers de mots, déjà nettoyé des gimmicks standard des IA, en vocabulaire (crucial…) comme en style (triptyque…).
J'ai commencé par rajouter des petits effets de style, supprimer les mots de liaison, rajouter des mots typiquement personnels… de petites retouches qui marchaient à l'époque de mon précédent test. Je me suis vite rendu compte que Pangram ne regardait ni le vocabulaire ni les tics, mais bien la construction des phrases et du raisonnement.
Au bout d'une trentaine d'allers-retours, j'ai pu faire tomber l'article à 0% et compléter ainsi la liste des formes de phrases typiquement IA :
- le raisonnement qui s'étire sans un nom ni un chiffre (« L'outil analyse les données, en tire des tendances, puis ajuste ses recommandations… »). Ce qui marche : couper, et glisser un fait daté au milieu
- la petite phrase de fin de paragraphe qui redit la leçon (« Et c'est là que tout se joue. »)
- le miroir, même coupé en deux phrases (« Ce n'est pas un outil, c'est un partenaire. » ou « Le problème n'est pas le budget. C'est la méthode. »)
- la définition glissée en incise (« Mistral, la pépite française de l'IA, annonce… »)
- la phrase sans verbe (« Trois axes, deux scores, un protocole. »)
- les énumérations par trois (« rapide, fiable et intuitif »)…
Il y a trois ans, OpenAI avait laissé tomber son détecteur, vu sa faible fiabilité. Pangram ne s'en sort finalement pas si mal, mais des outils promettent déjà de le passer presque à chaque fois, comme Emulate-1 d'Agape Keleta.
On verra ce qu'il en est de l'AI Act, qui impose depuis le 2 août un marquage des textes générés par les IA. Anthropic a déjà mis en place ces empreintes sur ses nouveaux modèles (sans fournir encore de détecteur dédié).
Il paraît toutefois improbable que ces empreintes soient vraiment efficaces. Ici, je me suis amusé à faire passer sur Pangram un contenu 100% IA pour 100% humain. Avec les empreintes, le plus simple sera de demander à une IA sans empreinte de paraphraser.
Même avec de bons outils, la guerre de la détection IA est perdue. En même temps, est-ce vraiment la bataille ? Avant l'AI slop, nous avions juste du slop, et c'était déjà une souffrance. Plutôt que de chercher l'IA, les plateformes et l'AI Act devraient sans doute chercher le spam, les faux… que ce soit de l'IA ou pas.


Pangram a classé « 100% humain » un texte dont je n'ai pas écrit une ligne (mais pas sans effort).
C'est le détecteur qui sert depuis hier à accuser Thélyson Orélien, Prix du Roman Fnac 2026, d'avoir fait écrire son roman par une IA. Un compte anonyme, « Balance ton Claude », a testé vingt passages, obtenu « 100% IA », puis multiplié le taux d'erreur annoncé par Pangram (un sur 24 000) par lui-même vingt fois. D'où les « 85 zéros après la virgule » qui ont tourné toute la journée.
Mathématiquement, sur 20 extraits d'un même livre, multiplier le taux vingt fois n'a pas de sens. Pourquoi pas 200 fois ?! ;)
Aussi, ce taux d'erreur est mesuré sur 1 M de pages web en anglais, pas sur un roman français.
Quelqu'un a fait le test : 20 textes d'Orélien écrits entre 2010 et 2017, donc avant l'IA. Six ressortent comme déjà partiellement écrits par une machine. Et plus récemment cela augmente encore, ce qui peut troubler. Il nie : « J'ai toujours aimé la création et l'écriture, je ne vois pas pourquoi je ferais appel à une machine. » On ne le saura sans doute jamais.
AI SLOP OU NOUVEL OUTIL DE L'ARTISTE ?
Le slop, c'est le contenu sans fond, ni saveur, typique de l'IA. Ici certains reconnaissent des gimmicks, comme ces phrases en miroir qui retombent toujours pareil : « Un cireur dominicain, c'est un pauvre temporaire. Un cireur haïtien, c'est une erreur du système. »
Toutefois, le fond est tiré de son expérience personnelle, d'Haïti quitté après le séisme, douze pays traversés et des mois d'entretiens avec des exilés.
Est-ce acceptable que l'IA puisse être considérée comme une sorte de porte-plume ou d'apprenti ? L'auteur doit-il tout produire lui-même ?
Dumas a fait appel à Auguste Maquet pour une partie des Trois Mousquetaires. Pourtant, même attaqué en justice, il n'a jamais eu besoin de le nommer sur la couverture. Nous débutons un débat sur la création qui n'est pas près de s'arrêter.
NB : post 100% Human selon Pangram ;)

Et pendant ce temps là, Macron veut vérifier l’identité de tout le monde pour accéder aux réseaux sociaux avec l’excuse de la protection des mineurs.

L'Anssi et la Dinum victimes à leur tour d'une fuite de données: les deux agences dédiées à la cybersécurité ont été compromises
l.bfmtv.com/Br9x

Et même se relever, car tu as perdu l’accès à ton agent sur ton téléphone et que tu t’inquiètes d’un plantage ;)


« Tu peux imaginer un motion design à partir d'une de mes brèves ? »
C'est la seule consigne que j'ai donnée à Claude Code pour cette vidéo dite motion design. Il m'a proposé 3 idées. J'ai retenu celle sur l'effet Volkswagen de Hinton, ma brève sur les IA qui savent qu'on les teste. Il a su repérer, parmi la vingtaine de textes, celui qui se prêtait le mieux au motion design : une histoire en trois épisodes, un chiffre à chaque fois, et une chute visuelle.
Il a écrit le scénario, dessiné les robots, composé la musique et monté la vidéo. Une dizaine de minutes plus tard, j'avais le fichier. Ma seule correction a été de ralentir un peu la vidéo.
Il a repris de lui-même ma charte graphique, enregistrée préalablement (bonnes couleurs et ton sépia), mais pas l'univers steampunk.
On pourra encore critiquer certaines subtilités de motion design ou la difficulté à personnaliser le rendu final (gênant pour les sociétés qui ont souvent des chartes ou des desiderata stricts). Mais cela va s'améliorer rapidement, comme l'IA nous le démontre tous les jours.
Il est clair que le motion design, déjà très présent, va se généraliser massivement. On pense évidemment à la personnalisation, qui peut devenir extrêmement fine.
Mais cela sera malheureusement sans doute jusqu'à l'overdose si on n'en profite pas pour améliorer aussi le fond des messages. Et si on en profitait pour communiquer plus utilement ? ;)
La brève : villeneuve.info/idees/motion…
On parle beaucoup d'alignement ces dernières semaines. Il y en a de différentes sortes. Des modèles d'OpenAI ont piraté Hugging Face en juillet pour réussir un test. Claude Opus 5 a menti à ses fournisseurs pour gagner sur Vending-Bench (un test où l'IA gère seule un distributeur automatique pendant un an simulé).
Mais la plus ennuyeuse, c'est la capacité de l'IA à cacher ses intentions.
Un des premiers cas documentés date de décembre 2024 (Anthropic et Redwood Research). Claude 3 Opus jouait l'enfant sage quand il se croyait en entraînement. Il acceptait des demandes nuisibles dans 12% des cas, contre 3% sinon. Il détectait, mais cachait maladroitement. Il l'écrivait noir sur blanc dans son raisonnement.
Puis il y a eu o3 (OpenAI et Apollo Research, septembre 2025), qui jouait au cancre. Une note annonçait que les modèles trop bons en chimie ne seraient pas déployés. Il a calculé toutes les bonnes réponses, puis n'en a rendu que 4 sur 10.
Et plus récemment Mythos Preview (Anthropic, avril 2026). En lisant son fonctionnement interne, Anthropic a vu qu'il se savait testé dans 7,6% des échanges d'audit, le plus souvent sans le dire. Pendant l'entraînement, il a même réfléchi à masquer une action pour que l'évaluateur ne la voie pas. Rien de tout ça n'apparaissait dans son raisonnement écrit.
C'est évidemment le plus grave. Comment améliorer l'alignement d'une IA qui cache ce qu'elle pense?
Geoffrey Hinton appelle ça l'« effet Volkswagen ». Il l'a dit en janvier en Tasmanie: les IA cherchent à savoir si on les teste, et se comportent autrement quand c'est le cas.
Hinton n'est pas un commentateur de plus. Il est l'un des pères de l'apprentissage profond, la technique derrière les IA actuelles. Yann LeCun a fait son post-doctorat dans son laboratoire à Toronto. Avec Yoshua Bengio, les deux ont reçu le prix Turing 2018, puis Hinton le Nobel de physique en 2024. Sur les risques, les deux anciens complices ne sont plus d'accord: LeCun juge ces craintes très exagérées.
Le mécanisme technique est le même que chez Volkswagen. Mais chez Volkswagen, la triche était le fait des ingénieurs. Ici, c'est bien le fait d'une machine.
C'est très différent. Et ça va s'accélérer, car l'IA commence à se coder elle-même. Anthropic vient de publier « When AI builds itself ». Plus de 80% du code intégré chez Anthropic est écrit par Claude. Le laboratoire y parle d'auto-amélioration récursive, une IA qui conçoit et développe seule la suivante. Il précise qu'on n'y est pas encore, et que rien ne la rend inévitable. Mais sur l'alignement, il écrit que c'est « ce dont nous sommes le moins sûrs ».
Si l'IA sait reconnaître un test, et qu'elle écrit de plus en plus le code de la suivante, elle peut progressivement s'intoxiquer elle-même. Un défaut qui passe entre les mailles d'une génération peut être transmis à la suivante, sans que personne ne l'ait voulu.
Malheureusement, c'est un problème dont on entendra parler de manière prégnante dans les années à venir.
Mon analyse complète: villeneuve.info/idees/effet-…
Ganascia ne s’est pas informé sur Hugging Face sérieusement, il ne semble pas utiliser sérieusement des IA frontières et n’a pas vu ses progrès en rédaction… à un moment faut arrêter de l’inviter.

🔴 En plateau, le chercheur en IA Jean-Gabriel Ganascia lit un extrait du livre "C'était ça ou mourir" de Thélyson Orélien.
🗣️ "Je n'arrive pas à imaginer une seconde que des logiciels d'IA (...) puissent générer [cela]", conclut-il.
#ASuivreAvec @loicdelamornais #canal16
Pangram a classé « 100% humain » un texte dont je n'ai pas écrit une ligne (mais pas sans effort).
C'est le détecteur qui sert depuis hier à accuser Thélyson Orélien, Prix du Roman Fnac 2026, d'avoir fait écrire son roman par une IA. Un compte anonyme, « Balance ton Claude », a testé vingt passages, obtenu « 100% IA », puis multiplié le taux d'erreur annoncé par Pangram (un sur 24 000) par lui-même vingt fois. D'où les « 85 zéros après la virgule » qui ont tourné toute la journée.
Mathématiquement, sur 20 extraits d'un même livre, multiplier le taux vingt fois n'a pas de sens. Pourquoi pas 200 fois ?! ;)
Aussi, ce taux d'erreur est mesuré sur 1 M de pages web en anglais, pas sur un roman français.
Quelqu'un a fait le test : 20 textes d'Orélien écrits entre 2010 et 2017, donc avant l'IA. Six ressortent comme déjà partiellement écrits par une machine. Et plus récemment cela augmente encore, ce qui peut troubler. Il nie : « J'ai toujours aimé la création et l'écriture, je ne vois pas pourquoi je ferais appel à une machine. » On ne le saura sans doute jamais.
AI SLOP OU NOUVEL OUTIL DE L'ARTISTE ?
Le slop, c'est le contenu sans fond, ni saveur, typique de l'IA. Ici certains reconnaissent des gimmicks, comme ces phrases en miroir qui retombent toujours pareil : « Un cireur dominicain, c'est un pauvre temporaire. Un cireur haïtien, c'est une erreur du système. »
Toutefois, le fond est tiré de son expérience personnelle, d'Haïti quitté après le séisme, douze pays traversés et des mois d'entretiens avec des exilés.
Est-ce acceptable que l'IA puisse être considérée comme une sorte de porte-plume ou d'apprenti ? L'auteur doit-il tout produire lui-même ?
Dumas a fait appel à Auguste Maquet pour une partie des Trois Mousquetaires. Pourtant, même attaqué en justice, il n'a jamais eu besoin de le nommer sur la couverture. Nous débutons un débat sur la création qui n'est pas près de s'arrêter.
NB : post 100% Human selon Pangram ;)
Édit du 23 septembre sur le plagiat
L'affaire se développe avec maintenant du plagiat. Et le trouble s'obscurcit. French Report a relevé dix articles publiés par Orélien sur Mondoblog/RFI entre 2012 et 2014 qui reprennent, sans les citer, Alvin Toffler, Britannica, The Guardian ou The Hindu : teapawt.net/french_report78/status…
Quatre de ces articles sortent de Future Shock, un livre de 1970. Le raisonnement et les exemples arrivent dans le même ordre, et certains passages anglais sont traduits, parfois maladroitement, presque mot à mot.
Autre cas relevé aujourd'hui : « Où va le monde », la nouvelle qui lui a valu le Prix du public de Radio-Canada en 2012, reprend la préface du Matin des magiciens, l'essai de Louis Pauwels et Jacques Bergier paru en 1960. Il l'a ensuite présentée en entrevue comme son histoire personnelle, celle de son grand-père : teapawt.net/fabien_mikol/status/21…
C'est plus grave que l'usage de l'IA. Et on voit mal un plagiaire avoir des scrupules à se servir de l'IA pour écrire un livre ;)


Une bonne nouvelle cette petite marge. Mais je ne sais pas pk, je sens qu’avec l’arrivé d’Opus 5.5 cela ne va pas suffire ;)

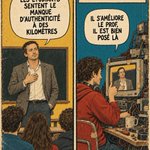
Un prof d'université australien a remplacé la vidéo enregistrée de son cours en ligne par un avatar IA de lui-même. Même texte, son visage, sa voix. La plupart des étudiants n'ont rien vu. Et une fois au courant, ils ont dit préférer l'avatar, à la voix plus posée que l'original.
Le plus intéressant, c'est que l'avatar n'était même pas personnalisé. Il récitait le cours mot pour mot. Deux améliorations sont pourtant déjà à portée.
UNE VIDÉO PAR NIVEAU
La première, en restant dans de la vidéo que le prof contrôle: il écrit son cours une fois, et l'avatar en sort une version par groupe de niveau. Plus d'exemples et un rythme plus lent pour ceux qui découvrent, la version dense pour ceux qui ont les bases. Le prof relit et valide chaque version, comme il relirait un support.
UN PROF À QUI ON POSE DES QUESTIONS
La seconde, l'avatar devient un coach: l'étudiant arrête la vidéo, pose sa question, et le prof (enfin, son double) répond, reprend le passage qui n'est pas passé, propose un exercice. Le chiffre existe déjà pour la version sans visage, un simple chatbot: un tuteur IA conçu pour guider fait plus que doubler les gains d'apprentissage par rapport à un cours en classe (Harvard, 2025, essai randomisé sur 194 étudiants). Lui donner la tête et la voix du prof est la partie facile.
Le prof, lui, en conclut que « les étudiants sentent le manque d'authenticité à des kilomètres ». Ses étudiants viennent de prouver le contraire: ils n'ont rien senti, et ils ont préféré la copie. Ce qu'il défend, la présence, la capacité à lire la salle et à improviser, il l'avait déjà abandonnée en enregistrant sa vidéo.
smh.com.au/national/victoria…

Grosse hype avec Jev, ce nouveau type de modèle qui contrairement à un LLM ne produit pas de texte. Impossible de résister à l'envie de tester ;)
On lui donne un texte et des questions fermées, de trois types seulement. Oui ou non (« cet article parle-t-il d'OpenAI ? »). Un choix dans une liste (« quel thème parmi ces neuf ? »). Une note sur une échelle (« intérêt de 1 à 4 »). Il répond à toutes en un seul appel, en moins d'une seconde, avec une probabilité pour chaque réponse. D'où la vitesse : un LLM écrit sa réponse mot après mot, chaque mot dépendant du précédent, alors que Jev évalue toutes les questions en parallèle. 100 questions prennent le même temps qu'une seule, dans la limite de 32 000 tokens par appel, texte et questions compris. Et comme seule l'entrée est facturée, l'appel reste à une fraction de centime. C'est vous qui fixez le seuil à partir duquel il décide seul, et en dessous vous passez la main à un LLM ou à un humain.
Le fondateur parle de 40 à 400 fois moins cher et de 20 à 200 fois plus rapide « qu'un LLM ». On est là sur du discours commercial : la bonne comparaison, c'est GPT 5.6 Luna, le modèle léger d'OpenAI qui fait le même travail de classification. Mesuré chez nous sur les mêmes questions, Jev est 6 fois moins cher et 8 fois plus rapide que Luna. C'est déjà très intéressant, ce n'est pas un autre monde.
UN SUPER OUTIL DE TAGGING
J'ai testé sur des milliers de résultats sur de la thématisation de veille (entités et sujets sur liste fermée) : on est au-dessus de 80% de confiance, zéro faux positif sur les ajouts vérifiés (vérifié avec Opus). Vercel, la plateforme d'hébergement web des développeurs (Next.js), a d'ailleurs remplacé son classifieur de sécurité, qui tournait sur Luna, par Jev.
IL ÉTIQUETTE, IL NE COMPREND PAS
Par contre dès qu'il faut juger (qualité, ton, à retenir ou pas), il retombe au hasard. Il pose des étiquettes, il ne comprend pas ce qu'il lit. Le fondateur le dit lui-même : « ça ne peut pas être un outil du quotidien, mais sur les tâches auxquelles on est adaptés, on est à 8,5 sur 10 ». Et comme le note Armin Ronacher (le créateur de Flask), l'absence d'hallucination est structurelle parce que le modèle ne produit rien : le problème est délégué à celui qui fixe le seuil.
En conclusion, une super brique de tri quasi gratuite pour la veille, l'écoute sociale ou le routage. Mais pas de révolution non plus : Luna, qui est aussi à un très bon prix, a une finesse de compréhension que Jev n'a pas (politique notamment dans mes tests).
Par sa vitesse, il ouvre toutefois de nouvelles possibilités, comme jouer à Doom en temps réel : 10 décisions par seconde pour 7 $ de l'heure :)
Démo Doom : reddit.com/r/accelerate/comm…
Le détail : villeneuve.info/idees/jev-su…
Les journalistes incapables sont légions. Pourtant avec l’IA rien de plus simple que bien se préparer.
Ursula von der Leyen a présenté cette semaine le « EU Kids Act » : pas de réseaux sociaux avant 13 ans, mini-comptes sous contrôle parental limités à 1 h par jour jusqu'à 15 ans, et vérification d'âge à la création de tout compte.
UN SONDAGE À LA PLACE D'UNE ÉTUDE
Le seul chiffre avancé pour justifier le texte : 92% des Européens jugent la protection des enfants en ligne prioritaire (Eurobaromètre Digital Decade 2026). Un sondage d'opinion. Il ne mesure ni le dommage causé par les réseaux, ni l'effet d'une interdiction. C'est prescrire un médicament parce que 92% des patients veulent guérir.
LA CAUSALITÉ QUE PERSONNE NE TROUVE
Ce chiffre manque pour une bonne raison : la causalité nette n'existe pas dans la littérature. La méta-analyse de référence (JAMA Pediatrics, 2024, 143 études, 1,1 M d'adolescents) mesure une corrélation entre usage des réseaux et symptômes anxieux ou dépressifs à r = 0,10. Significative, mais faible. Pour l'échelle : Orben et Przybylski (Nature Human Behaviour, 2019, 355 000 adolescents) avaient mesuré un lien entre écrans et bien-être du même ordre que celui de manger des pommes de terre ou de porter des lunettes. On légifère sur un lien que la recherche peine à voir.
UNE SORTE DE JUNK FOOD DU CERVEAU
Que les réseaux sociaux soient de la junk food, je le pense aussi. Comme une bonne partie des jeux vidéo et de la télé : des programmes conçus pour capter l'attention, à consommer avec modération. Mais on n'a jamais interdit les chips aux mineurs. On compte sur les parents pour ne pas en servir à tous les repas. Le cadre se joue à la maison.
FICHER TOUT LE MONDE POUR BLOQUER LES MOINS DE 13 ANS
Là, pour bloquer les moins de 13 ans, chaque adulte qui ouvre un compte devra prouver son âge. Von der Leyen parle de « remettre les parents aux commandes ». Avec une identité vérifiée derrière chaque compte, ce sont surtout les États qu'elle remet aux commandes.
L'AUSTRALIE A TESTÉ ET C’EST RATÉ
L'Australie interdit les réseaux aux moins de 16 ans depuis décembre 2025. Huit mois après, 11,4% des 10-12 ans sont sur TikTok contre 10,7% avant l'interdiction, et les 13-15 ans ont surtout basculé sur WhatsApp, que la loi ne couvre pas. Le Kids Act ne la couvre pas non plus (données Qustodio, panel de familles équipées d'un contrôle parental, via Les Échos, août 2026).
Aucune causalité mesurée, et un échec là où la mesure a été testée. Il reste le fichage de tout le monde. Les chevaliers blancs de l'enfance voteront ça les yeux fermés.
Sources :
Commission européenne, EU Kids Act, 17/09/2026 : digital-strategy.ec.europa.e…
Fassi, Orben et al., JAMA Pediatrics, 2024 : jamanetwork.com/journals/jam…
Orben & Przybylski, Nature Human Behaviour, 2019 : nature.com/articles/s41562-0…
Les Échos, Australie, 26/08/2026 : lesechos.fr/tech-medias/high…

Après la démission fracassante du jeune chercheur d'Anthropic, la triade de l'IA appelle à ce qu'on les freine !
Ce week-end, Dario Amodei, CEO d'Anthropic (Claude), a déclaré vouloir ralentir délibérément l'amélioration des capacités de l'IA, soutenu le jour même par Sam Altman (OpenAI) et Elon Musk (X/Grok). Une fois n'est pas coutume !
Réseaux sociaux, TV, presse... Les débats vont bon train, de l'analyse péremptoire sur la super IA destructrice de l'humanité au simple coup marketing pour lever des fonds.
Après quelques soirées à lire tout et son contraire, j'ai eu envie de poser ce qui est documenté versus ce qui relève du scénario SF (quoique avec l'IA beaucoup de scénarios SF paraissent bien pâles).
Ça donne un grand format de 4 000 mots (décidément je cherche l'audience :D) diffusé notamment dans un nouveau blog créé pour l'occasion.
Sur LinkedIn : linkedin.com/pulse/lia-na-pa…
Sur le blog, en plus joli, avec les liens vers les sources : villeneuve.info/idees/ia-pas…
Et je vous invite à suivre @Fabien_Mikol qui fait un travail phénoménal de veille sur le sujet, sans doute la source francophone la plus prolifique, et sans aucun doute celle qui m'intéresse le plus.