

Built: avante.nvim Building: https://xitter.cf/t.co/kQss3piJs8 https://xitter.cf/t.co/pfq9srNgsd https://xitter.cf/t.co/QhQRLD4zQo https://xitter.cf/t.co/6ERz2HMx0f https://xitter.cf/t.co/fpGnPR5t9C https://xitter.cf/t.co/cBN1yzJPIG
无
Joined May 2010
- Tweets21.5K
- Following4.6K
- Followers99.2K
- Likes19.9K


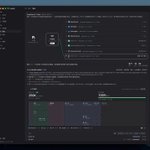


其实我最近也发现了为什么大家老是觉得 Agent 不太顺手,而我为什么一直以来都用得特别顺手,就是因为我一直以来都用 --dangerously-skip-permissions 这个参数来启动 claude,这个参数很关键,因为它不只是影响到是否需要人批准,这个参数甚至会影响到 prompt(见截图)。也就是说不加这个参数,claude 基本上是一个半残废的状态,它的积极性和主动性会大大降低,导致很多事情它都不会自动帮你做。
当然,你质疑安全性就当我没说。因为我用 Agent 的习惯就是把它放在一个单独的没有敏感信息的机器里放开手脚,让它去飞。


magpie 10-26 网关故障:尸检报告和道歉
10 月 25 日到 26 日下午,很多朋友更新 magpie 后遇到网关「挂了」:Codex 等 agent 的请求一直转圈,2 分钟后报 504(held this request for 2m0s without routing it),设置里关掉本地模型的开关也没反应。这是我的问题。耽误了大家的工作,尤其是半夜还在帮我抓栈、找原因的朋友,真的对不起。
【影响】
- 时间:10-25 起明显加重,到 10-26 14:15 的 v0.1.1566 修复。
- 范围:打开了「设置 › 隐私 › 用本地模型查找」的用户。重启 magpie 后几乎必犯,而且时好时坏。
【根因(已由用户抓到的 goroutine 栈确认,#3682)】
本地脱敏模型(pf-serve)的调用拿着一把全局锁做同步 I/O:模型加载(最长 3 分钟)和每一次识别都在这把锁里。于是所有请求都排在它后面,连「选哪个账号」这一步都走不到;设置页读模型状态、关闭模型也要这把锁,所以开关也点不动。
【为什么 10-25 起突然变严重】
- v0.1.1539 换了新版 pf-serve(pf-v2)。老用户更新后,magpie 会在后台下载新版、结束旧进程,下一个请求就要在锁里冷启动一次。我推断这一步把问题放大了,但没有单独复现过。
- v0.1.1540 加了「路由前卡住 2 分钟就回 504」的看门狗,原来静默的等待变成了直接报错。
- 识别超时后会结束并重启 pf-serve,每次重启又是一轮持锁加载,所以故障反复出现。
- 报告者的日志里,10-16 到 10-24 路由前等超过 5 分钟的请求是 0 条,10-25 有 26 条。
【我哪里做错了】
1. 把可能要几分钟的 I/O 放在全局锁里,测试和评审都没拦住。测试用的是假 pf-serve,从没用真模型跑过「冷重启 + 多个请求同时进来」。
2. 一天发了二十多个版本。换 pf-serve 这种「更新后第一个请求必然冷启动」的改动,没在真机上把更新流程走一遍就发了。
3. 10-26 凌晨 5 点就有朋友报告,我第一反应是「没复现,请先抓栈」。可抓栈的接口本身也会被卡住的请求挡住,直到 v0.1.1559 才修好。13:08 GitHub 上的 yunwang2442-creator 在 #3682 贴出完整的栈和根因,我才在一小时后修好。非常感谢。
4. 还没解释清楚的:有朋友报告 /v1/models 和供应商页面也没响应,这两条路径不经过脱敏模型,这次的修复不一定覆盖。turingou 的情况我也还没拿到栈,不能确定是同一个原因。在拿到证据之前,我不会说它已经修好。
【修复(v0.1.1566)】
- 加载和识别都不再持锁;读状态、关闭模型不用再排队。
- 识别结果落到磁盘(只存哈希、位置和类别,不存原文),重启后不用把历史重新跑一遍。
- 客户端已经断开、或已经回了 504 的请求会离开队列。
- 卡在模型上的请求会直接说「在等本地脱敏模型」,并告诉你怎么关掉它。
- 仍然不会只按规则脱敏就把请求发出去。
【请大家】
升级到 v0.1.1566 或更新的版本。如果网关还卡,请在终端运行 magpie goroutines,把生成的文件发给我,我会接着查。
【以后】
动到锁、子进程启动、升级流程的改动,发版前必须用真模型在沙箱里做一次冷重启 + 多请求的验证。
再次向大家道歉。


yetone retweeted

Introducing Kimi K3.1 Pro: our most capable 3T-class open-weight model.
🔹 1M-token context, 2.8T total / 104B active params (MoE), Multimodal.
🔹 Full-project coding: games in Unreal, Unity & Godot.
🔹 Excels at parametric 3D modeling in Blender & CAD.
🔹 More reliable at finance work: Accurate modeling with hallucination down by 65%.
🔹 Matching the strongest proprietary models across coding, agentic and knowledge benchmarks.
Kimi K3.1 Pro and K3.1 Pro Highspeed (2–3× faster) are now live on Kimi.ai, Kimi Work, Kimi Code, and the Kimi API.
Open weights by Nov 4, 2026.
🔗 API: platform.kimi.ai
🔗 Tech blog: kimi.ai/blog/kimi-k3-1-pro


帮转,Design Engineer 永远是时代的神。

大家好,我正在寻找远程的 Design Engineer 机会。
过去几年作为合伙人共同运营 Zolplay,重心在产品设计与交互体验。经历过早期初创团队,也负责过上市公司项目组,主导过多款产品从 0 到上线交付。
个人介绍与作品集:cuvii.dev/work
欢迎交流或推荐,感激。


牛啊!

DeepSeek just open sourced its high-performance, large-scale inference framework DeepInfer in Apache-2.0 license.
github.com/deepseek-ai/DeepI…
Supported features:
- Optimized kernels, model and sampler runtime
- Parallelism: Attention DP / balanced CP, MoE EP + EPLB
- DSpark and confidence-scheduled verification
- SWA bounded replay
- Asynchronous scheduling (zero-overhead batch scheduler)
- Batch-invariant inference
- Deterministic sampling
- Structured output
