Fayafish retweeted

最近刷到不少人说,做新词站出单了。
看多了有点好奇:到底赚了多少?词从哪找到的?从动手到出单用了多久?
就去搜了一圈 10 月 1 号到现在的帖子,整理了 8 个人。金额都是作者自己分享的收入或收款,不是净利润。
——
哥飞 @gefei55
9 月 28 号上的新站,6 天收入 3666 刀。到 10 月 13 号,新站累计超过 5000 刀,再加上老站新增页面带来的 2000 多刀,同一个词拿到了 7000 多刀。
不过他也说了,后面每天越来越少,现在偶尔还有几单。
——
弗里 @0xEcho99
10 月 9 号开始做,10 号下午上线,晚上就出单了。第一个客户还买了两次积分。12 号又发了一条:两天破 1000 刀。
xitter.cf/0xEcho99/status/210957…
他把找词和建站过程讲得比较细。
看到群里大家做新词出了单,但之前那个词已经开始降温了,他就想,怎么自己找下一个?
于是把新词雷达的思路和社群经验丢给 Grok Bot,搭了个监控工具。工具推荐了一个词,他觉得有机会,就买域名,跟 Claude 聊需求怎么实现,再套已有模板、参考竞品做站。
模型怎么接、用哪个中转站,都是边做边查。第二天补功能、写内容、接支付,下午上线,晚上出单。当时他甚至还不知道客户是从谷歌还是 ChatGPT 来的。
首单这条值得直接看:
xitter.cf/0xEcho99/status/210892…
——
Yihui @yihui_indie
前一天晚上上线,第二天出了一单 49.9 刀。说没做营销推广,当天早上才提交 GSC,线上甚至还有 bug,付费用户还给他发邮件反馈。
xitter.cf/yihui_indie/status/210…
——
Theo @qing22579
从哥飞的新词监控服务里找到词,用半天上线,两天后出了两单。截图里是 49.9 刀和 19.9 刀,合计 69.8 刀。
xitter.cf/qing22579/status/21067…
——
kristoff @kristoff_wu
当时还没加入社群,从公开分享的国庆新词站里找到灵感,半天上线。
发帖时网站才上了三天,从开单到收入破百刀,不到 24 小时。他之前已经做了一年,只有零零散散的广告收入。
xitter.cf/kristoff_wu/status/210…
——
蒋云何 @JiangK82705
10 月 5 号分享达成千刀。去年就了解出海,今年年初入群,中秋期间开始把流程简化,先上站,再根据用户反馈改。
具体怎么找到这个词、多久出首单,帖子里没展开。但发帖时,这个词的流量已经下降了不少。
xitter.cf/JiangK82705/status/210…
——
Ricky @TOMRICH1619
首单 4.99 刀,同串回复里说,当天下午已经连续出了三单。
还有一句挺容易被忽略:他说自己也是做了五六个站,才开始有单。看到“第一次做新词就开单”,不代表这是他第一次建站。
xitter.cf/TOMRICH1619/status/210…
——
弈森 @iamyisen
去年就加群了,但一直没动手,国庆才开始跟着做新词。
10 月 6 号上线,7 号和 8 号各出一单 6.99 刀,总共 13.98 刀。Stripe 还没来得及申请,先用 PayPal 收到了钱。
xitter.cf/iamyisen/status/210955…
——
搜完发现,这些帖子里讲找词,更多提到的是监控服务、社群线索、看别人公开分享的站,以及自己搭雷达。直接说“我从 Google Trends 找到这个词”的反而不多。
半天上线、隔天出单,确实有人做到了。但大部分分享也就到首单、前三天为止。哥飞和蒋云何都提到了后面流量下降。
所以我现在更想看他们过两周、一个月再来复盘:热度过去以后,这些站还能剩多少订单? xitter.cf/gefei55/status/2110044…

一个好消息分享给大家,我之前 9 月 28 日上的这个站,累计收入过 5000 刀了,虽然后面每天越来越少了,但是偶尔有几单,日积月累,终于过五千刀了。
再加上我老站内页带来的订单也有两千多刀,加起来我在这个词上拿到了七千多刀了。
也有很多群友们在最近出了不少订单,得感谢奥特曼。
这里可以看到 TrustMRR 验证过的收入 trustmrr.com/startup/aivideo…


Fayafish retweeted

Github 上 Agent Reach 最近一周暴涨 8,000+ Stars,
目前已经超过 3.5 万 Stars。
做内容和调研的人,建议先收藏,以后一定用得上!!
它可以让 Codex 同时搜索和读取 Twitter、Reddit、YouTube、B站、小红书与 GitHub。
不用分别研究六个平台的 API,也不用换一个 Agent,就重新安装和配置一遍。
装好以后,你可以直接让 Agent:
① 搜 Twitter 上的用户评价和最新讨论
② 查看 Reddit 帖子与评论
③ 提取并总结 YouTube 视频字幕
④ 搜索 B站视频和相关教程
⑤ 调研小红书上的产品口碑
⑥ 阅读 GitHub 仓库、Issue 和 PR
对于需要做选题、竞品、舆情和跨平台调研的人来说,它相当于给 Codex 装上了一双真正能看遍互联网的眼睛。
YouTube、公开 GitHub、网页和 RSS 等渠道基本可以直接使用。
👉Twitter、小红书和 Reddit 受平台限制,需要配置浏览器登录状态或 Cookie。使用 Cookie 存在账号风控风险,建议使用专用小号,不要使用主账号。


Fayafish retweeted

兄弟们,我今天刷到一个东西,直接给我整不会了。
GitHub上有个叫 agency-agents 的开源角色库,你知道它现在多少星吗?81万。不是8.1万,是81万。这个数字意味着什么?意味着全球有几十万开发者和AI玩家已经在用了,你还不知道?
🔗 链接: github.com/msitarzewski/agen…
先说这东西是干嘛的。
简单讲,就是一个超级角色提示词库,里面塞了140多个专家级Agent角色。CEO、律师、程序员、产品经理、增长黑客、财务顾问、市场策略师……你能叫出名字的岗位,基本都在里面。每个角色都是精心调教过的,不是那种随便写两句"你是一个律师"就完事的垃圾提示词,是真的有深度、有专业框架的角色设定。
用法也极其简单,三步走:
1️⃣ 打开这个库,找到你需要的角色
2️⃣ 把角色描述直接喂给Claude Code或者Cursor
3️⃣ 开始对话,你的AI瞬间变成那个领域的专属顾问
就这么简单。你在做一个创业项目,不知道商业模式怎么跑通?调出CEO角色问它。合同条款看不懂?调出律师角色让它帮你拆解。代码写不下去?调出高级程序员角色让它review。
但最骚的玩法不是单个角色,是多Agent组团。
你可以同时开几个对话窗口,一个跑CEO视角,一个跑市场总监视角,一个跑财务视角,让他们对同一个问题给出不同角度的判断。这不就是给自己开了一家虚拟公司吗?而且这帮"员工"7×24小时在线,不要工资,不会摸鱼,不会跟你讲情绪。
我自己测试了几个角色,说实话,质量比我预期高很多。
特别是那些商业类角色,给出的框架和思路真的有点东西,不是那种泛泛而谈的废话,是能直接落地用的建议。当然,AI终究是AI,专业判断还是要自己把关,但作为思路启发和初稿生成,这个库的价值真的被严重低估了。
还有一点我必须说——它是完全免费的。
开源、免费、随便用、随便改。在这个到处收费、动不动就订阅的AI时代,这种东西真的越来越少见了。
现在AI工具的核心竞争力已经不是模型本身了,Claude、GPT、Gemini底层能力差距在缩小,真正拉开差距的是你怎么用、用什么角色、给它什么上下文。这个库本质上是在帮你解决"怎么用"的问题,把最难的提示词工程部分给你做好了,你直接拿来用就行。
81万星不是运气,是实力。
还没收藏的,现在去。


Fayafish retweeted

推荐一个开源项目 Horizon,一个专门盯海外科技圈的 AI 信息雷达。
它会自动聚合 Hacker News、Twitter、Reddit、GitHub 等平台内容,再用 AI 做筛选、去重和总结,把真正有价值的信息整理成日报。
比较实用的是:
* AI 自动给内容打分,低质量直接过滤
* 提取 Reddit / HN 里的高质量评论和观点
* 自动补充陌生公司、技术背景
* 同一新闻全网去重
* 支持生成中英双语简报
* 可推送到飞书、邮箱、微信等渠道
如果你平时靠刷海外社区获取信息,这类工具确实能减少很多“信息噪音”。
GitHub:
github.com/Thysrael/Horizon

Fayafish retweeted

Codex 最强实战课来了,建议直接收藏
不到 2 小时带你彻底玩转 Codex App + GPT-5.5 这个超级组合:技能和插件怎么用、自动化工作流如何搭建、多任务并行实战,全程手把手演示
想快速掌握高效 Vibe Coding 方法,这绝对是目前最值得刷的一条干货教程,连 OpenAI 官方都认可
Fayafish retweeted

下次看见什么火了
请形成一种敏感的肌肉记忆:
自媒体玩法:
1、建个知识星球
2、收集别人写的内容
3、多模态洗稿 多平台分发 引星球
4、打开闲鱼 挂商品
5、把收集的内容 去Github 建 awesome-xxxx 做聚合 继续引流
6、找开发者合作站点 分销网盘 卖模式
7、有了池子 组局 找分享人来分享 继续涨流量
8、合作接踵而至
开发者玩法:
1、把域名全买了
2、vibecoding上站
3、爬取内容 聚合分类 垂直化
4、接ads广告
5、把这一个领域内的词尽量全试了 有好的重点投入
6、aff别人的知识星球或项目
个体做流量赚钱拼执行力
赚小钱靠双手
赚中钱靠组织
赚大钱才靠脑子设计模式
不必赚什么大钱 因为都是从小钱开始的
Fayafish retweeted

想当数字游民,找远程工作,这一个 Github 仓库网站就够了
这个资源仓库包括了:
1、求职网站
总共62个求职网站、行业包括了AI 和 Web3, 岗位包括了运营、技术等。
2、面试准备资料库
包括模拟面试工具、面试题库以及在线编程平台。
3、数字游民工作指南
包括了远程工作协作学习资源,全球线上办公地点指南,远程工作工具推荐。
4、数字游民社区
当数字游民感觉枯燥,可以去社区逛逛。
总结来说,想成为数字游民,这是你必备的Github仓库。
🔗:github.com/lukasz-madon/awes…

Fayafish retweeted
前OpenAI联合创始人、前特斯拉AI总监Andrej Karpathy,AI圈的顶级大佬,他的一条推文浏览量960万,3.7万赞、6.8万收藏——他说自己不写代码了,改"编知识库"了。
他分享了用LLM搭建个人知识库的完整工作流,信息量极大👇
核心思路:把LLM从"写代码的工具"变成"管理知识的引擎"。
🔧 具体怎么做:
1️⃣ 数据收集——把论文、文章、代码库、数据集、图片全部丢进raw/目录,用Obsidian Web Clipper一键剪藏网页,图片下载到本地方便LLM引用
2️⃣ LLM自动编译Wiki——让LLM把原始数据"编译"成一套Markdown文件组成的Wiki,包含摘要、反向链接、概念分类、文章互联。重点:Wiki完全由LLM写和维护,人基本不碰
3️⃣ Obsidian当前端——用Obsidian浏览原始数据、编译后的Wiki和衍生的可视化内容,配合Marp插件还能生成幻灯片
4️⃣ 问答系统——当Wiki积累到一定规模(他的一个研究方向已经有~100篇文章、40万字),直接让LLM Agent对着Wiki做复杂问答。他说本来以为需要RAG,但LLM自动维护索引文件和摘要后,在这个规模下已经够用了
5️⃣ 输出反哺——问答结果生成Markdown、幻灯片、matplotlib图表,看完觉得有价值的再"归档"回Wiki,让知识库越用越厚
6️⃣ 自动体检——跑LLM"健康检查",找数据不一致的地方、补缺失数据、发现新的关联,持续提升Wiki质量
7️⃣ 下一步——当知识库足够大,自然就想到合成数据+微调,让LLM把知识"记在权重里"而不只是放在上下文窗口。
一句话总结:原始数据→LLM编译成Wiki→LLM操作Wiki做问答→输出反哺Wiki→Obsidian可视化。人只负责提问和决策,LLM负责一切读写。
Karpathy自己说了:这里面藏着一个颠覆级产品的机会,现在只是一堆脚本拼起来的原型。
谁先把这个工作流产品化,谁就吃到下一波红利。

LLM Knowledge Bases
Something I'm finding very useful recently: using LLMs to build personal knowledge bases for various topics of research interest. In this way, a large fraction of my recent token throughput is going less into manipulating code, and more into manipulating knowledge (stored as markdown and images). The latest LLMs are quite good at it. So:
Data ingest:
I index source documents (articles, papers, repos, datasets, images, etc.) into a raw/ directory, then I use an LLM to incrementally "compile" a wiki, which is just a collection of .md files in a directory structure. The wiki includes summaries of all the data in raw/, backlinks, and then it categorizes data into concepts, writes articles for them, and links them all. To convert web articles into .md files I like to use the Obsidian Web Clipper extension, and then I also use a hotkey to download all the related images to local so that my LLM can easily reference them.
IDE:
I use Obsidian as the IDE "frontend" where I can view the raw data, the the compiled wiki, and the derived visualizations. Important to note that the LLM writes and maintains all of the data of the wiki, I rarely touch it directly. I've played with a few Obsidian plugins to render and view data in other ways (e.g. Marp for slides).
Q&A:
Where things get interesting is that once your wiki is big enough (e.g. mine on some recent research is ~100 articles and ~400K words), you can ask your LLM agent all kinds of complex questions against the wiki, and it will go off, research the answers, etc. I thought I had to reach for fancy RAG, but the LLM has been pretty good about auto-maintaining index files and brief summaries of all the documents and it reads all the important related data fairly easily at this ~small scale.
Output:
Instead of getting answers in text/terminal, I like to have it render markdown files for me, or slide shows (Marp format), or matplotlib images, all of which I then view again in Obsidian. You can imagine many other visual output formats depending on the query. Often, I end up "filing" the outputs back into the wiki to enhance it for further queries. So my own explorations and queries always "add up" in the knowledge base.
Linting:
I've run some LLM "health checks" over the wiki to e.g. find inconsistent data, impute missing data (with web searchers), find interesting connections for new article candidates, etc., to incrementally clean up the wiki and enhance its overall data integrity. The LLMs are quite good at suggesting further questions to ask and look into.
Extra tools:
I find myself developing additional tools to process the data, e.g. I vibe coded a small and naive search engine over the wiki, which I both use directly (in a web ui), but more often I want to hand it off to an LLM via CLI as a tool for larger queries.
Further explorations:
As the repo grows, the natural desire is to also think about synthetic data generation + finetuning to have your LLM "know" the data in its weights instead of just context windows.
TLDR: raw data from a given number of sources is collected, then compiled by an LLM into a .md wiki, then operated on by various CLIs by the LLM to do Q&A and to incrementally enhance the wiki, and all of it viewable in Obsidian. You rarely ever write or edit the wiki manually, it's the domain of the LLM. I think there is room here for an incredible new product instead of a hacky collection of scripts.


Fayafish retweeted
发布不到10小时,已经300+ star🌟了。我也做了不少于5次的更新,花了大几千万的token。现在:
1、女娲.skill 可以在你有需求但不知道蒸馏谁的时候引导你帮你提供最优蒸馏人选
2、有7个蒸馏完成的skill案例可供你直接使用,包括乔布斯、马斯克、芒格、费曼、纳瓦尔、塔勒布,以及😓张雪峰。


你的下一个员工,何必是同事。
同事.skill这几天火了,把同事蒸馏成AI Skill。这个项目证明了一件事:蒸馏一个人的能力,是可行的。
但我想问一个问题:既然我们已经有了蒸馏人的能力,为什么要蒸馏身边的同事?
去蒸馏各领域最强的人。
而且幸运的是,这些人留下了大量可以被蒸馏的材料。芒格有《穷查理宝典》和几十年的股东会演讲。费曼有全套讲义和自传。Naval有几百条推文和长篇播客。塔勒布有五本书和无数公开辩论。这些都是高纯度的思维原矿,等着被提炼。
我之前就一直在干这件事。今天把方法论开源了,叫女娲。
使用极其简单:输入一个名字就行。女娲自动启动6个Agent去找书、找播客、找推文、找批评者,自己调研、自己提炼、自己验证。你不需要准备任何材料。
6个Agent并行采集著作、播客、社交媒体、批评者视角、决策记录、时间线。然后三重验证:一个观点要被收录为心智模型,必须跨2个以上领域出现过、能预测新问题立场、不是所有聪明人都会这么想。三条全过才留。
决策前问芒格,写教程问费曼,评估风险问塔勒布。你想蒸馏谁就蒸馏谁。
GitHub: github.com/alchaincyf/nuwa-s…
安装: `npx skills add alchaincyf/nuwa-skill`
MIT协议,随便用,随便改,随便造。


Fayafish retweeted

如果你也在用Claude做知识管理,尤其是搭配obsidian
一定不要错过这个
OB 的 CEO 罗列了几乎所有优质的
skills 帮助你更好的使用 Obsidian 进行知识管理
神器,秒杀所有 AI 笔记
github.com/kepano/obsidian-s…

Fayafish retweeted
既然Claude Code源码都泄漏了,我觉得我这75页的《CLAUDE CODE橙皮书📙》也该开源了。
这份橙皮书是我和Claude Code花了两个多月一起写的实战手册,面向想用AI编程但不知道从哪开始的人。10章,从安装到独立做出一个完整产品。
里面有什么:
• 核心工作流拆解(Plan/Auto模式、权限管理)
• CLAUDE.md写法——怎么给AI一张项目地图
• Skills、Hooks、MCP等扩展能力的实战用法
• 多Agent并行协作的完整机制
• Computer Use和Voice Mode等最新能力
• 一章完整的从零到上线产品实战
信息源主要是Claude官方文档、CC之父Boris的分享、吴恩达的Claude Code课程,加上我自己用CC做了十几个产品的经验。内容更新到2026年3月底。
和AI协作写的,内容量大,难免有幻觉。发现不准确的欢迎指正,我会持续更新。
下载链接🔗:my.feishu.cn/wiki/JK1WwrRgJi…

Fayafish retweeted
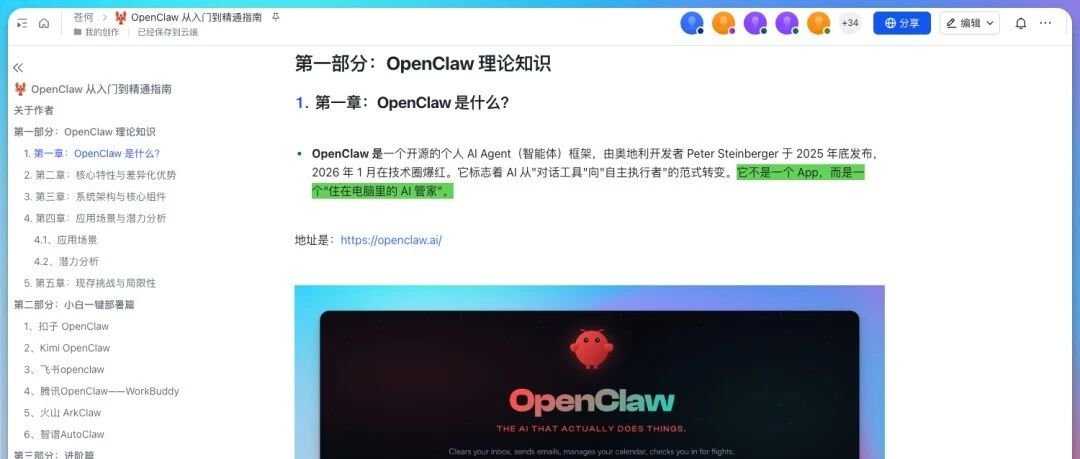
今天又又更新了一版🦞《OpenClaw橙皮书📙》,目前飞书文档已经有12万人看过了...好疯狂...
再考虑到被各种海鲜市场和知识付费社群售卖,群聊的pdf转发,我估计应该有100万+人的下载和看过这份pdf。
这份传播的源头肯定是X了,我猜可能是X上的AI KOL是真的多,以及很多人也是生活中给家人朋友传播AI知识的关键节点。
链接在此,欢迎转发给你对OpenClaw感兴趣的家人朋友,让他们少被割韭菜了:my.feishu.cn/wiki/H27Iw9ussi…