

全网原创 AI 硬核实测与深析 前沿模型评测 | API 配额与风控拆解 YT & B站: DP_IT | 📩 [email protected]
Joined June 2013
- Tweets215
- Following9
- Followers167
- Likes135






Pinned Tweet
Just got 6 months of free Google AI Ultra! Huge thanks to @OfficialLoganK 🫡
More Gemini 4 Argon tests and videos coming soon. Stay tuned!
喜提官方投喂的 6 个月 Google AI Ultra 试用,已激活!感谢 Logan。接下来会继续做 Gemini 4 Argon 的相关实测和视频,敬请关注!


最近 48 小时 Gemini 4 Argon 抓包实测数据与异常机制拆解(建议 Bookmark 备用):
📌 1. 订阅配额基准:与一周前(2026 年 10 月 21 日)我们的测试结果保持一致
• Google One Pro($20 订阅):实测可用额度维持 $15/周。
• Google One Ultra($100 订阅):实测可用额度维持 $50/5h、$200/周。
• 推算逻辑:通过对比测试前后的开始剩余额度、结束剩余额度及抓包总消耗金额反推得出,确认官方本周未上调账面总额度(网络传闻额度提升超过 50%,和本次测试结果不同)。
📊 2. 隐形费用刺客:连续对话中的“Cache 0% 归零”Bug
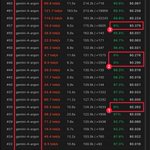
• 正常缓存表现:单轮连续对话中,Cache 会从 0% 爬升至 97-98% 并维持,正常增长期间单次请求仅 $0.03~0.05(典型测试中 21 笔非 0% 缓存请求单价在 $0.022~0.067 之间,总计 $1.211)。
• 异常归零暴击:对话中途会突然出现 Cache 掉回 0% 的情况,单次请求价格直接飙升至 $0.2~0.3。
• 典型抓包对账:在一次典型测试中,5 笔 0% 缓存请求总消费高达 1.238 美元(含首笔正常冷启动 0.031 美元,以及中途异常归零的 0.379、0.276、0.290、0.262 美元)。仅中途 4 次缓存丢失的账面消耗($1.207),就几乎追平了其余 21 笔正常请求的总和($1.211)。
• 计费边界说明:由于官方未提供按金额查询接口,上述数据均通过抓包分析得出,暂不确定该 0% Cache 异常产生的费用最终是否被计入实际配额扣减。如果产生实际扣费,那么对可用额度的影响较大。
⚠️ 3. 思考超 300 秒与“缓存击穿”的底层关联
• 48 小时多次复现:在最近 48 小时的 3 次测试中,均出现单次请求超过 300 秒才完成的情况。
• 午夜算力挤兑:昨晚 12 点测试时,出现连续 6 次耗时超 300 秒且全部请求失败、直到最后一次才成功的极端情况。
• 连锁反应推演:夜间算力紧张导致的挤兑与超 300 秒(5 分钟)长耗时等待,极易触发后端缓存过期(TTL 超时)或负载节点切换,这很可能就是导致连续对话中 Cache 突然掉回 0% 的直接原因。
建议先 Bookmark 收藏,遇到配额消耗异常或晚间卡顿时可直接对照排查。

最近 Gemini 4 Argon 出现明显“降智”,我们做了一轮底层测试,发现重灾区主要集中在 Antigravity 以及 Gemini Web/App。
根据我们的实测结果,你需要知道:
→ 新出现的 gemini-4-argon-trail 模型是导致本轮降智的核心嫌疑
→ 免费的 Pro 订阅账号,目前会被系统暗中分配到这个 -trail 模型
→ 只有 Ultra 订阅用户,才会被稳定分配到原版 gemini-4-argon
→ Antigravity 通道本身就自带智力折损,免费 Pro 更是“折上折”
→ 向海量免费 Pro 开放 Antigravity 高额度权限,正引发严重的算力挤兑
很多人觉得模型突然变笨是玄学,但底层的模型路由与算力分配其实已经发生了暗中洗牌。
为什么后缀带“-trail”的模型体验断崖式下跌?
为什么提前清退了一波 Pixel 订阅后,Google 依然面临严重的算力危机?
为什么在 Antigravity 里哪怕氪了 Ultra 拿到原版模型,依然发挥不出全部实力?
目前到底哪个入口还能用到 100% 满血的 Gemini 4 Argon?
我们将这轮实测摸清的模型分配规律、通道折损逻辑以及背后的算力挤兑趋势做了完整梳理,全部整理在下方首条长回复中 👇

为了搞清楚这波 Gemini 4 Argon 降智的真实原因,我们对比了不同订阅档位与调用入口的底层模型表现,建议 Bookmark 收藏备用:
📌 1. 幕后元凶:新模型代码与账号分级路由
这波体感下降并非错觉,Google 在后台对不同权重的订阅账号进行了精准的算力分流:
• gemini-4-argon-trail:近期刚刚上线的新模型分支,也是引发大面积降智的直接原因。测试发现,“免费的 Pro 订阅”账号会被优先分配到这个模型。
• gemini-4-argon:发布之初的原版模型 Code。目前已知需要是 Ultra 订阅用户,才会被系统分配到该原版模型。
• “-trail”后缀意味着什么:从实际表现来看,带有 -trail 后缀的分支代表着更低的智力上限与更低的单次运算成本,本质上是官方用来承接低付费权重流量的“算力缩水版”。
📉 2. 残酷的“折上折”:80% 基准线下的二次阉割
更值得注意的一个实测现象是“通道级折损 + 模型级降级”的双重叠加:
• 80% 的通道上限:在 Antigravity(以及 Gemini Web)中,哪怕你使用 Ultra 订阅拿到了原版 gemini-4-argon,其实际发挥出来的智力水平本来也就只有 AI Studio 和 Vertex AI 的 80% 左右。
• 免费 Pro 的二次打折:现在如果是免费的 Pro 订阅,在被分配到 -trail 缩水模型后,相当于要在原本 80% 的基础上继续打折,这也是为什么大家近期体感“断崖式变笨”的根本原因。
(注:这里描述的 80% 不代表真实的模型能力,只是为了方便大家理解,用来表述该入口本身是一个带降智属性的通道。)
🔥 3. 深层诱因:免费 Pro 放行引爆“算力挤兑”
Google 目前大概率正面临严峻的算力紧张局面,核心导火索在于近期的权限放开:
• 高额度 × 巨量白嫖基数:Google 最近对“免费的 Pro 用户”开放了 Antigravity 中 Gemini 4 Argon 模型的可用权限。由于 Antigravity 给出的额度相对较高,意味着单用户算力消耗极大;而免费 Pro 用户的存量基数又极其庞大,直接拉爆了算力负载。
• 清退难解根本问题:虽然在此之前,Google 已经提前对 Pixel 等渠道的免费订阅进行了筛查并取消了一部分资格,但免费用户盘子过大的根本问题并没有得到解决。预计短期内会出现明显的“算力挤兑”和更严峻的降智趋势。
🛡️ 4. 破局方案:哪里还有真正的“100% 满血版”?
如果你在日常开发与高强度任务中无法忍受客户端的降智表现,目前唯一的解法是切换调用入口:
• 实测表明,只有通过 Vertex AI 和 Google AI Studio 调用的 Gemini 4 Argon,才提供真正未阉割的“100% 满血智力”。
💬 聊聊看:最近你在用 Antigravity 或 Gemini Web 时,体感降智严重吗?你的账号目前被分到了哪个模型?欢迎在评论区交流对比!
Google 最新旗舰 Gemini 4 Argon 分“残血版”和“满血版”,你知道吗?
你需要知道:
→ 100% 满血版渠道:Vertex API 与 Google AI Studio(Playground / Build / API)
→ 80% 智力渠道:Antigravity (Pixel 与学生 Pro 已可用)
→ 70% 残血版渠道:Gemini App 与 Web 端
→ 在日常文本和分析工作中,满血版带来的体验会好很多
→ 最佳跨端工作流
很多开发者吐槽新模型写代码不够强,其实是因为一直在使用只有 70% 智力的 Gemini Web 或 App 端。在复杂的生产环境排错中,被阉割掉的 30% 推理深度,往往就是卡死你几个小时的致命盲区。
如何快速鉴别手里的 Gemini 4 Argon 是满血还是残血?
为什么说 Google AI Studio 是目前开发者最香的 100% 满血阵地?
怎么用“残血前端 + 满血后端”打出一套高效率的跨端排错组合拳?
我们用 Keynote 把 Gemini 4 Argon 四大渠道的智力评测、实战排错对比以及跨端协作 SOP 系统梳理了一遍,全部整理在下方首条长回复中 👇

同样是调用 Gemini 4 Argon,选对渠道直接决定你的工作是“秒级破局”还是“原地打转”。结合本期视频的核心实测数据,为大家做个干货拆解,建议 Bookmark 收藏备用:
1. 四大渠道智力评测:谁才是真正的 100% 满血版?
根据深度编码测试与实战表现,四大主流接入渠道的模型智力表现如下:
• Vertex API(100% 满血版):企业级付费 API 渠道,解锁最完整的模型能力,生产环境表现最稳定。
• Google AI Studio(100% 满血版):无论是 Playground 聊天调试、Build 构建还是 API 接入,均为 100% 满血状态,是开发者和硬核用户的首选阵地。
• Antigravity 平台(约 80% 智力):接入 Ultra 或 Pro 订阅时表现约 80% 功力。最新实测指出,Pixel 赠送订阅和学生专属订阅(Student Pro)现已被识别为有效付费订阅,不仅能无缝接入,还能直接调用 Claude 5.5 协同工作。
• Gemini App 与 Web 端(约 70% 智力):大众最易接触的入口,但任务处理深度有限,更适合简单的日常问答与轻量级网页探索。
2. 为什么工作中必须用满血版?(PHP Docker 漏洞修复实战)
在简单对话中残血与满血差异不大,但在硬核 Coding 场景下,细节捕捉能力高下立判:
• 实战排错背景:修复个人项目中 PHP 7.4 Docker 容器的安全与运行漏洞。
• AI Studio 满血洞察:投喂运行日志后,100% 满血的 Argon 敏锐察觉到极易被忽略的时间异常——原本应运行 8 分钟的 Docker 容器,实际仅存活了 27 秒就发生异常重启。
• 实战核心价值:精准揪出隐藏的容器内部报错死循环,大幅降低了开发者盲目排错的时间成本。
3. 终极效率解法:“跨端协作整合法” SOP
复杂 Coding 首选 AI Studio,日常工作中更推荐将不同渠道组合使用:
• Gemini Web 端(第一阶段采集):利用 Chrome 浏览器内嵌的 Gemini Web(70% 残血渠道),快速抓取网页报错内容与环境信息,生成初步报告并导出为 Markdown 格式。
• Google AI Studio(第二阶段接管):将 Markdown 文本无缝投喂给 AI Studio(100% 满血渠道),接管后半程的深度代码分析与漏洞修复。
💬 聊聊看:你在日常工作和写代码时,用的是 Gemini App/Web 还是 AI Studio?有没有遇到过非得靠 100% 满血版才能攻克的痛点问题?欢迎在评论区交流讨论!
完整 Keynote 渠道评测梯度表与实战排错流程见下方配图 ⬇️
本期详尽宣讲的视频观看入口,我附在下方 👇


📺 本期完整视频《深入解析 Google Gemini 4 Argon:满血版与残血版渠道全面对比》(含 Keynote 全流程动态演示):
YouTube:youtube.com/watch?v=iWXO647W…
哔哩哔哩:bilibili.com/video/BV1Wxnb66…
Google 悄然重置并大幅提升了 Antigravity IDE 中 Gemini 4 Argon 的可用配额,主力档位额度近乎翻倍。
根据已有的信息, 你需要知道:
→ 新配额变化:Pro 升至 $15/周,Ultra ($100) 跃升至 $200/周
→ Token 折算标准:$1 约合 1.6M 至 2.0M Tokens
→ 渠道权限微调:AI Studio 正式向非付费 Pro 用户开放该模型
→ 订阅防坑预警:为何当下切忌盲目锁定长期订阅?
在首批用户密集吐槽 Gemini 4 Argon 额度“不够塞牙缝”后,Google 终于主动扩充配额池并做了一次周额度重置。但即便额度翻倍,不同订阅档位之间的真实 Token 承载力依然差距悬殊。
折算成百万级 Token 后,Pro 与 Ultra 各档位到底够干什么用?
非付费 Pro 用户在全平台与 Antigravity 里还有多少可用空间?
为什么说目前 Ultra $100 档性价比最高,却依然强烈建议只按月付费?
我们用 Keynote 把新旧配额实测对比、Token 换算模型以及全平台调用权限矩阵系统梳理了一遍,全部整理在下方首条长回复中 👇

结合本期视频的核心实测与调研数据,帮大家快速提炼 Gemini 4 Argon 最新额度机制与平台矩阵,建议 Bookmark 收藏备用:
📊 1. 新旧配额实测对比(主力档位近乎翻倍)
面对社区对初始配额过低的反馈,Google 近期完成了额度扩充与周配额重置:
• Pro 订阅($20 档):由旧版 $10/周 提升至 $15/周(经社群实测确认,深度撰写一篇长论文仍略显局促)。
• Ultra 订阅($100 档):由旧版 $25/5小时、$100/周,大幅跃升至 $50/5小时、$200/周(实测消耗 6% 的 5 小时额度约合 $3,属于当前【性价比最高】的甜点档位)。
• Ultra 订阅($200 档):由旧版 $70/5小时、$200/周,提升至 $200/5小时、$800/周(网传测算数据)。
💰 2. 美金额度与 Token 数量直观换算
抛开单纯的账面金额,按【$1 ≈ 1.6M - 2.0M Tokens】的基础比率折算实际生产力:
• Pro($20 档):每周约可调用 24M - 30M Tokens。
• Ultra($100 档):每 5 小时高达 80M - 100M Tokens,每周合计 320M - 400M Tokens。
• Ultra($200 档):每 5 小时可达 320M - 400M Tokens,每周合计 1,280M - 1,600M Tokens。
🌐 3. 四大渠道权限矩阵与非付费用户前瞻
• Antigravity IDE:维持严格付费墙,仅限真实付费的 Pro 与 Ultra 用户调用;即便未来向非付费用户开放,免费配额也将面临极严苛的瓶颈。
• AI Studio:权限正式拓宽,现已支持非付费 Pro、付费 Pro 及 Ultra 用户体验 Gemini 4 Argon。
• Gemini App & Web:维持不变,所有 Pro 与 Ultra 用户均可使用。
• Vertex AI:维持不变,仅限付费 API 用户调用。
🛡️ 4. 订阅决策与“防坑”建议
官方及时响应社区呼声扩充配额值得肯定,但熟悉 Google 在 Antigravity 生态历史操作的老玩家都清楚其策略调整的频繁程度。如确有高强度生产力需求,当前首选 Ultra $100 档位,且务必坚持“按月付费”,切勿盲目锁死长期订阅。
💬 聊聊看:在这次配额翻倍调整后,你觉得现在的额度够日常开发用了吗?你会为了 Gemini 4 Argon 付费升级订阅吗?欢迎在评论区交流讨论!
完整 Keynote 测算表格见下方配图 ⬇️
本期详尽宣讲的视频观看入口,我附在下方 👇


📺 本期完整视频《Google官方大幅提升Gemini 4 Argon可用额度!Antigravity IDE最新配额与实测对比全面解析》(含 Keynote 全流程动态演示):
YouTube:youtube.com/watch?v=gko_wVf6…
哔哩哔哩:bilibili.com/video/BV18anz6j…
Gemini 4 Argon 全渠道可用能力与智力排行榜:从 70% 到 100% 满血,只有选对入口才能避开严重降智。
根据已有的信息, 你需要知道:
→ 渠道智力金字塔: 70% 到 100% 的断崖差距
→ 100% 满血标的: 为什么只有 Vertex AI 和 AI Studio 是满血?
→ 70% 垫底警告: 为什么Gemini Web 与 App 端沦为“降智重灾区”?
→ 80% 的 Antigravity: 订阅制程序员的主力口粮与真实瓶颈
很多人以为只要充了 Google 会员,在哪用体验都一样。但实测表明,Google 内部有着极其森严的算力分级配给机制。同样的复杂任务,不同渠道给出的智力天花板完全不同。
为什么最方便的 Web 网页端在实测中表现最弱?
哪个渠道才是用上 1M 完整上下文满血 Argon 的唯一解?
完整排行榜评分细节与 Google 底层算力调度逻辑,全部整理在下方首条长回复中 👇

结合渠道实测与底层算力机制,为大家做个干货拆解,以下为个人经验分享,建议 Bookmark 收藏备用:
1. Gemini 4 Argon 可用渠道能力排行榜
特别说明:榜单中的百分比为我们多轮实测后的主观评估标尺(官方从未公布具体智力数值),不代表绝对性能度量。100% 代表接近满血的基准表现,非 100% 代表存在不同程度的剪枝或能力降级:
• 梯队 1(100% 智力):Vertex AI。企业级标准付费 API,本次实测的 100% 满血标的参照物,物理算力最足,支持 GCP 300 赠金抵扣。
• 梯队 1(100% 智力):Google AI Studio(API / Playground / Build)。标志是享有 1M 完整上下文,也是普通人接触满血 Argon 的性价比最高途径。
• 梯队 2(80% 智力):Antigravity。订阅制属性明显,额度与调用量最充裕,但因走 IDE 共享算力调度,存在动态限流与轻度推理降级。
• 梯队 3(70% 智力):Gemini Web & 移动端 App。Google 生态最底层的通道,上下文窗口窄,逻辑推理被大幅剪枝,降智体感最明显。
• 其他渠道暂未列入统计,欢迎大家在评论区实测补充!
2. 为什么同一个模型会有断崖式差距?
核心在于 Google 底层的“算力池物理隔离与成本控制”:
• 独立物理资源 vs 共享流量池:付费 API 按 Token 计费,官方能覆盖高昂算力成本,因此开放完整物理显存与原生思维链;而 Web/App 承载海量免费/低门槛流量,首要任务是压缩推算成本。
• 上下文与隐藏思维链(CoT)裁剪:Web 端之所以显得“变笨”,本质上并不是核心模型换了,而是系统 Prompt 进行了限制、上下文过早截断、甚至被压缩了推理步数。
3. 极客与开发者选型建议
• 追求极致智力与复杂逻辑:首选 AI Studio 或 Vertex AI,确保拥有不缩水的 1M 满血上下文。
• 追求日常高频工程写代码:Antigravity 是综合体验与可用量最平衡的选择。
• 日常轻量问答与检索:使用 Web/App 即可,但切记不要拿它来评估 Argon 的真实智商上限。
💬 聊聊看:大家目前主力使用的是哪个渠道?有没有在 Web 端感受到明显的“降智”?欢迎在评论区交流讨论!
Antigravity 也开始重置额度了,我们的测试 Ultra 账号额度从 0% 恢复到了 100%,还没到周额度的刷新时间,所以 Antigravity 针对 Gemini 额度进行了提前重置。Claude 是否刷新还不确定。
对于 Gemini 4 Argon 用户来说是个好消息。大家可以动起来了,加油!
本次重置只针对 Antigravity 内 Gemini 额度,对于 Gemini Web 和 APP 的额度并没有重置。目前来看,官方会主动重置额度,是一个好消息。

Google 新旗舰 Gemini 4 Argon 正式登场,但首发体验却呈现出冰火两重天的极端评价。
但天下真没有免费的午餐,你需要知道:
→ 额度少:Pro($10/w), Ultra($25/5h, $100/w)
→ 渠道:Antigravity(Ultra+Pro), Gemini App/Web(Ultra+Pro), AI Studio (Ultra+API)
→ 文本创作与前端 UI 堪称无敌,但后端工程严谨性依然欠缺
→ 综合性能稳居“世界第三”,紧追 Opus 5.5 与 GPT-6 Astra
面对水涨船高的 AI 订阅价格,Google 究竟是在为算力困境买单,还是在逼大家为全家桶充值?
首字响应慢、缺乏自主校验意识的 Argon,真的撑得起高昂的 Ultra 订阅吗?
在 Opus 5.5 和 GPT-6 系列的双重夹击下,Argon 的真实生产力天花板究竟在哪里?
我们用 Keynote 把各渠道准入规则、真实额度测算表格与实测天梯榜做了一次彻底复盘,全部整理在下方首条长回复中 👇

帮大家快速提炼核心机制与数据全景,建议 Bookmark 收藏备用:
1. 渠道准入与“抠门”的额度测算
Google 这次把额度卡得极其严格,各端额度独立核算,且当前额度还是打 5 折促销后的状态:
• 核心接入渠道:Antigravity 支持付费 Pro/Ultra;AI Studio 仅限 Ultra 订阅;Vertex API 支持付费调用(需 Global 区域);Gemini Web/APP 额度比 IDE 端更少。
• Antigravity 额度测算:$20 档 Pro 周额度仅 $10;$100 档 Ultra 每 5 小时限 $25、周限 $100;$200 档 Ultra 每 5 小时限 $70、周限 $200。
• 严苛现实:对于高强度 Coding 开发者而言,当前的配额池在极短时间内就会告罄。
2. 模型性能红黑榜:实测两极分化
社区第一批实测反馈呈现出非常鲜明的“偏科”特征:
• 🌟 核心优势:干活主动性极强,极少过度防御式拒答;长任务与超长上下文表现稳健;文本写作、逻辑做题与前端 UI 设计无可挑剔;账号生态安全不封号。
• ⚠️ 痛点不足:首字响应时间(TTFT)偏长,体感迟钝;后端代码工程严谨性较弱,极度依赖前置 Prompt 约束与工作流引导;Antigravity 平台体验拖后腿。
• 第一梯队实测排位:Opus 5.5 > GPT-6 Astra > Gemini 4 Argon > GPT-6.1 Sol,稳居“世界第三”。
3. 商业视角:高昂订阅费究竟值不值?
单纯为了日常 Coding 去冲 $100 或 $200 的 Ultra 档极其不划算,性价比被严重稀释:
• 如果将 Google 全家桶的生态价值计算在内(2TB+ 云盘、GCP 算力赠金、YouTube Premium 会员),这笔支出算得上超值。
• 市场与开发者眼下更急需的,是官方尽快解决额度短板,以及推出响应更快、成本更低的 Gemini 4 Flash 或纯粹的 Pro 版本。
💬 聊聊看:在目前的额度限制和定价下,你会考虑为了 Gemini 4 Argon 给 Google 买单吗?欢迎在评论区交流讨论!
完整 Keynote 测算表格见下方配图 ⬇️
本期详尽宣讲的视频观看入口,我附在下方 👇


📺 本期完整视频《Google Gemini 4 Argon 全面评测:可用渠道、额度解析与性能体验排名》(含 Keynote 全流程动态演示):
YouTube:youtube.com/watch?v=a2rdMXsr…
哔哩哔哩:bilibili.com/video/BV15qJX64…

用 AI 写代码提速了 10 倍,最后却把项目活活堆成了没人敢碰的“屎山”。
你需要知道:
→ 能跑通 ≠ 能交付
→ 核心破局点: 遵循方法论
→ 80/20 法则: AI 减负80%,核心节点 100% 人工覆盖
→ 前置约束机制: 限制AI乱跑
→ 文本与代码通用举例
很多人以为 AI 编程是“一键梭哈”,几秒钟跑出一个 Demo 页面就欢呼生产力跃迁。但真正进入深度 Debug 和长周期维护,才发现调试的时间成本远超前期快速生成的收益。
为什么再顶级的 AI 也救不了劣质的上下文?
在 10x 的生成速度下,我们该如何守住代码交付的生命线?
我们用 Keynote 把日常 Coding 中行之有效的“五阶段开发模型”、“双防线审查机制”与人类的核心护城河做了系统梳理,全部整理在下方首条长回复中 👇

I 时代,人真正的护城河不是“写代码有多快”,而是“制定前置规则”与“守住最终审核”。结合本期视频的核心体系,为大家做个干货拆解,建议 Bookmark 收藏备用:
1. 为什么“一键生成”是商业级项目的噩梦?
能跑通 Demo 不等于能商业交付。缺乏前置约束的 AI 代码严格遵循朴素的 Garbage In, Garbage Out 定律。前期省下的 10 分钟,后期往往需要用数天时间在屎山中痛苦 Debug。对于长期运营的项目,绝不能“一键梭哈”。
2. 研发实战:“五阶段 + 双防线”交付模型
告别乱写,按结构渐进式演进:
• P0 准备阶段:确立规则文件、禁止事项与工作流约束(一次配置,多项目复用高 ROI)。
• P1 需求阶段:由 AI 深度辅助产出并闭环完整 PRD 文档。
• P2 数据层设定:优先构建底层数据架构,而非直接上手写业务代码。
• P3 原型设计:线框图排版 + HTML 重构,做到 1:1 仿真交付标准。
• P4 渐进编码:分端推进,先写抽象骨架,再逐步添加业务血肉。
• 🛡️ 审核双防线:日常 70% 依赖 AI 自动审查减负,但 P0 配置与核心业务节点必须保持 100% 人工终审。
3. 文本工作三板斧:告别“假大空”
• 前置定义:锁死受众、字数要求、排版规范与负向禁令(Negative Prompt)。
• 大纲先行:分层级、按章节分块生成,坚决杜绝“一键出全文”。
• 分层 Review:AI 承担语法速扫与基础排错,人类做通读并执行最终决策润色。
4. 终局思考:未来的工作流配比
健康状态正从“80% AI + 20% 人工”走向“95% AI + 5% 人工”,但人类决不能完全离场。能够制定规则并做最终决策的“设局者”,才能在浪潮中立足。
💬 聊聊看:你在日常用 AI 写代码时,被“屎山”坑得最惨的一次是什么经历?欢迎在评论区交流讨论!
完整 Keynote 测算与流程架构图见下方配图 ⬇️
本期详尽宣讲的视频观看入口,我附在下方 👇


📺 本期完整视频《AI时代如何平衡生成速度与代码质量?告别“屎山代码”的实用方法论》(含 Keynote 全流程动态演示):
YouTube:youtube.com/watch?v=_820BJUk…
哔哩哔哩:bilibili.com/video/BV1W5p26f…
