

📚 Crypto/Stock Researcher & Investor 📖 Trading & DeFi 👨🎓 prev engineer Silicon Valley
New York, NY
Joined March 2019
- Tweets2.9K
- Following725
- Followers1.9K
- Likes12.3K




Eason 伊森 retweeted

Bitcoin fell 19% into the biggest IPO ever. Now it's down 18% heading into the second biggest.
SpaceX raised $75B when it went public on June 12. In the 50 days before it listed, Bitcoin dropped 19%. Anthropic plans to raise up to $64B when it lists next week, and Bitcoin is down 18% over the same stretch. Overlay the two and they look almost the same.
What happened after the SpaceX IPO is the notable part. Bitcoin bottomed 18 days after the listing, then recovered all the way. By Day 100, it was above where it started.
Bitcoin around the SpaceX IPO:
Day -50 to IPO day: -19%
Low (Day +18): -25%
Day +50: still -20%
Around Day +70: a sharp rally
Day +100: +3.7%
From the IPO-day close to Day +100, Bitcoin gained 28%. From the low, it gained 39%.
The takeaway is that the selling came in the run-up to the listing. The bottom had effectively happened by the IPO, and the recovery came relatively shortly after, and it came all at once.
If Anthropic follows the same pattern, most of the drawdown is behind us, and it could reverse quickly over the next couple of months. And Bitcoin is sitting right at its 200-week moving average.
Map the SpaceX path onto today's price and you get roughly $90k by late February. Markets rarely follow a comparison like this exactly. But we remain very constructive on both the technicals and the fundamentals heading into 2027, and it's not hard to imagine what the narrative would be if anything close to this plays out.

Eason 伊森 retweeted

从 Martin Luk 这种交易新秀,到 Mark Minervini,Larry Williams 这种顶级老交易员。
他们的看家方法,TradingView 上都有人做成了免费指标。
下面这 8 个,每个都附上了搜索名,搜到直接添加就可以使用。
以 969.8% 的年收益拿下 2025 年美国投资锦标赛冠军的 Martin Luk,常用一条平均成本线,算的是从波段高点开始买进的人平均花了多少钱。
搜索 Auto Anchored Swing VWAP,这条线会自动画好,出了新的高点还会自动重画。
2020 年以 941.1% 的年收益夺冠的 Oliver Kell,最经典的形态叫 Wedge Pop,就是股价急跌之后,第一次重新站回均线。
搜索 Wedge Pop,图上会自动标出 WP。涨得太猛之后第一次跌回均线,也会标出 WD。
两次拿下美国投资锦标赛冠军的 Mark Minervini,选股第一步是用他的趋势模板,把不在上升趋势里的股票先筛掉。
搜索 Mark Minervini,符合模板的股票会自动标出绿色。
一年把 1 万美元做到 110 万美元以上的 Larry Williams,发明过一个公式,能给任何品种算出它自己的恐慌指数。
搜索 CM_Williams_Vix_Fix,选作者 ChrisMoody 的那个。柱子变绿,说明这次的恐慌已经明显超过平时。
一年赚了 1400 多万美元的 Dan Zanger,最喜欢找放量突破的股票。
搜索 Zanger Volume Ratio,它会在盘中告诉你,今天到现在的成交量是平常同一时间的几倍,超过 2 倍柱子就变红。
《笑傲股市》的作者威廉·欧奈尔,给所有股票按过去一年的涨幅打 1 到 99 分,叫 RS 评分。
搜索 RS Rating,任何一只股票都能算出这个分数,常见的参考是 80 分以上。
箱体理论的创始人达瓦斯,原本是个职业舞蹈演员,趁巡演空档炒美股赚了 200 万美元。
搜索 Darvas box,强势股横盘的那一段会被自动画成箱子,向上突破箱顶,就是他买进的位置。
赚了 3000 多万的美国交易员 JadeCap,每天开盘前要先标出前一天和亚盘时段的高点低点。
搜索 ICT Killzones,这几条线会自动画好,哪条已经被价格碰过,一眼就能看出来。它更适合纳指期货和比特币这类夜里也在交易的品种。
不知道从哪个开始,可以先挑一个和自己的交易习惯最像的,加到手里的股票上,看看它过去标出来的位置准不准。


Eason 伊森 retweeted

投资见人品,财富见格局。
一个人顺境时,能看出他的人品;一个人逆境时,才能看出身边人的人品。
顺境看一个人如何对待别人,逆境看别人如何对待你。
一个人真正的修养,不是得势时有多风光,而是在获得利益之后,是否依然懂得饮水思源;也不是失势时有多狼狈,而是在利益消失之后,是否还能守住情分。
有些人确实德不配位。得势时趋之若鹜,失势时避之不及;有利可图时称兄道弟,无利可图时翻脸不认人。
所以我一直认为,做好人本质上就是在建立正反馈。
最好的交易策略,就是做好人。做不好人的人,往往也做不好交易。
一个对资产追涨杀跌的人,往往也会对人追涨杀跌。资产上涨时趋之若鹜,资产下跌时弃之如敝履;别人有价值时百般讨好,别人落难时唯恐避之不及。
这种人即使一时赚到了钱,也未必守得住财富。
交易赚的是认知的钱,守住财富靠的是纪律,而想要在人生这场长期博弈里走得更远,靠的是格局、品性和长期积累的信任。
钱可以靠能力赚来,但能不能留住,最终还是看一个人的底色。
饮水思源,知恩图报,善待值得善待的人。
厚德才能载物。


Eason 伊森 retweeted

I am excited to be an investor in trade(xyz) as they partner with ICE to bring 24/7 perpetual futures on Hyperliquid to the United States. As a market participant, I am looking forward to to using their innovative product to enhance my investment process.
Eason 伊森 retweeted

旗帜鲜明看空semi,有一些基本面因素可能会导致下跌,技术面也有很多因素,以下是我的一些观察:
基本面:
1.10月份oai arr 出现了下滑,opus 5.5 模型能力很强,tokens 使用量出现了增长,但是arr 也仍然严重不及预期,本以为只是anthropic 的问题,现在发现不是,两家最头部模型都遇到了增长放缓问题。
2.越来越多的大厂正在收缩业务部门的AI使用,过去两年很粗放使用,但是今年下半年开始,大家都在看ROI,那些没有ROI的业务正在做收缩合并。不完全统计,大厂内部的AI使用,可能会占AI云收入的30%以上,在增长放缓的背景下,这部分支出即便出现1/3的收缩,对行业影响也会是巨大的。
技术面:
1.soxx周线正处于abc 下跌的c浪中间,月线是一根反包大阴线,这些都是大熊态势。同时年线看,仍然大幅偏离5年均线,历史回测数据来看,连续4年大幅上涨的背景下,这种回踩5年均线的概率非常高;
2.nvda 周线连续两次顶背离,月线顶背离,周线以上级别顶背离是趋势逆转的低信噪比先验指标;
3.外围,韩国指数,A股创业板,科创板,恒生科技指数已经全面走熊,这些都是这波Ai密切相关的指数,台湾指数也处于周线顶背离中;
4.纳斯达克指数也处于周线顶背离(不是特别严格),也许还有最后一波拉升,即便如此,拉升完以后也是形成周线级别顶背离。spy 目前结构相对较好,还未出现顶部信号;
以上种种,顶部信号越来越多,越来越明显,需要引起大家足够重视。
$SOXX $NVDA $QQQ
Eason 伊森 retweeted

Token价格暴跌 / 用量暴涨大势浩浩荡荡、势不可挡。按照这个big trend, 最近我就开始琢磨到底啥App / 公司能受益
目前看起来短期(1-3年)最直观的就是以Seedance + 红果为首的生态,以摧枯拉朽之势暴打整个娱乐产业。(生物/机器人/材料科学啥的我还在研究。。。)
算了笔账,我认为App + Model未来3-4年的ARR应该有机会能给字节带来40-50 Bn USD 的ARR收入,相当于目前字节整个盘子的25% (目测目前低于3%)。目前海外VC好像还没开始算这笔账, but seems very logical.
中国票房一年7-8Bn USD,红果的收入今年已经逼近中国电影票房。估计27年全面超越。字节闭环逻辑很通畅:
- SeedDance 模型产出,训练数据飞轮
- 番茄负责剧本, 多年网文累积确定爆款
- 抖音负责超低成本获客 + 筛选爆款
= 低剧本成本+低制作成本 + 低获客成本
当然这个4亿月活和牛逼飞轮的背后,在我看来其实还是中国本身匮乏的娱乐内容(电影工业本身垃圾 hh,最近芒果台的后会友期感觉还很不错lol),加上大家不仅压力大,普遍做题长大的教育背后、大多数人其实没有很多日常娱乐方式。红果这种刷刷乐在中国天然有优势,尤其是网络小说生态(本子好)前提下。话说我当年也是重度起点小说的网瘾少年 - 阳神 / 无限恐怖 / 龙蛇演义什么的提供了当时初中/高中很多的精神食粮。
再往后推演:
- 可见的视频模型只会越来越好,再过一年大概率已经与真人一般无二。目前的反感会逐渐消弭
- 字节依靠红果国内的统治,因而获得巨大创作者的内容作为持续训练 + CapCut,有概率持续保持领先
- 文本产出和创意会因AI boil the ocean,对比过去量大管饱越来越好
所以高质量AI内容基本大概率在未来2-3年打爆国外流媒体中低端内容, 而字节国内的打法,在国外同样好用。超低成本价格拉暴竞争对手
- 所以下一步就是去干暴Youtube / Netflix / Disney / Warners 的中低端shows / 普通内容, 尤其是非英语平台机会巨大 (欧亚非拉)
- 全球电影票房35Bn,上述流媒体平台除去Youtube 大概90-100 Bn收入。红果海外一旦复制国内成功,基本就是35-40 Bn的体量。
- 然后假设Seedance持续保持市占,short-films creator高度调用,大概10-15Bn ARR。创作者多平台deploy
- 字节一鱼两吃之下大概收入45-50 Bn USD,差不多就是在再造一个今天的Anthropic / OpenAI 收入体量 (当然这两家年底估计就是这个的4倍了lol)
在这个赛道除非Top Labs自己转向或者achieve AGI,否则我感觉只有Youtube有一战之力。不过看着Google如此拉垮多条战线全面傻逼,估计还是字节's game to lose. 全球奶头乐number 1当之无愧。
In actuality, 我感觉好莱坞和美国所有想搞的公司会被版权这个事情给拖死,想搞也改不了。所以最后还是中国的机会。全球演员和剧组的状态会很难想象是怎么样的,不过大概率是被完爆,失业率爆表。看看中国演员现在状态就知道了。
最后是啥结论我也不知道、不过就是今天跟朋友打牌的时候想出来的。。。如果有的话,那就是:
我想看无限恐怖/杀戮都市!!!什么时候有大神能够完全忽略版权上线这种内容啊啊啊

Eason 伊森 retweeted

本篇由 @BITstocks_CN 赞助播出,10/21 起,168X 每天抽出 1 位成功通过 168X 链接注册的用户,送出 $30!
Crypto 的交易赛道与美元支付成为主线;未来 12–18 个月,AI 财富效应决定 Crypto 流动性,Cheap Intelligence、China AI、Robotics 是下一阶段 Alpha

Eason 伊森 retweeted

AI半导体终局推演(IV)
开源模型的兴起对半导体有什么样的影响?会不会降低半导体的营收?
这可能是最近半年市场争辩非常激烈的问题
开源模型token占比可能已经超过两成而且在加速,价格只有闭源旗舰几分之一。每一轮新开源模型发布,市场都要重新算一遍:token越来越便宜,模型公司还赚得到钱吗?
模型公司不赚钱,谁来买那么多卡?
这个问题如果从静态角度看待,确实是矛盾的:
一方面,更便宜的模型会让更多人使用AI,所以需要更多算力
另一方面,开源会把OpenAI和Anthropic的价格打下来,模型公司赚不到钱,谁来为后面几年的巨额CapEx买单?
--------------------------
一、开源会伤害半导体吗?
把市场的担心拆开,其实是两种说法。
第一种:开源会把premium token的价格也拉下来。闭源两家(OpenAI和Anthropic)的ARR受损,靠融资、靠借钱“透支未来”去买算力的能力,也会跟着下降。
第二种:开源靠价格战抢市场,抢走太多份额,但自己的营收和毛利太低,整个模型层对半导体的支付能力被拉低,开源厂商自己的融资和发展速度也会受影响。
开源token也是token,消耗的同样是真实的算力,相似尺寸的模型,开源的算力消耗还要少一些,比如DeepSeek有sparse attention这类优化。但对半导体来说,真正重要的不是开源还是闭源,而是用卡的人赚不赚钱。毛利率是影响大家抢购芯片热情最重要的因素,几乎没有之一
毛利够高,抢到就是赚到,买得越多赚得越多
毛利超过70%,买的GPU一年回本,每一个GPU都是印钞机。毛利如果只有50%,也可以承担更多融资的风险,去贷款买得更多
所以问题就变成了:开源会不会把毛利率打下来?
如果只看静态的token价格,答案似乎是会:价格一直在跌。但我们不能以静态的眼光看问题,看token经济学,需要一个动态的framing
--------------------------
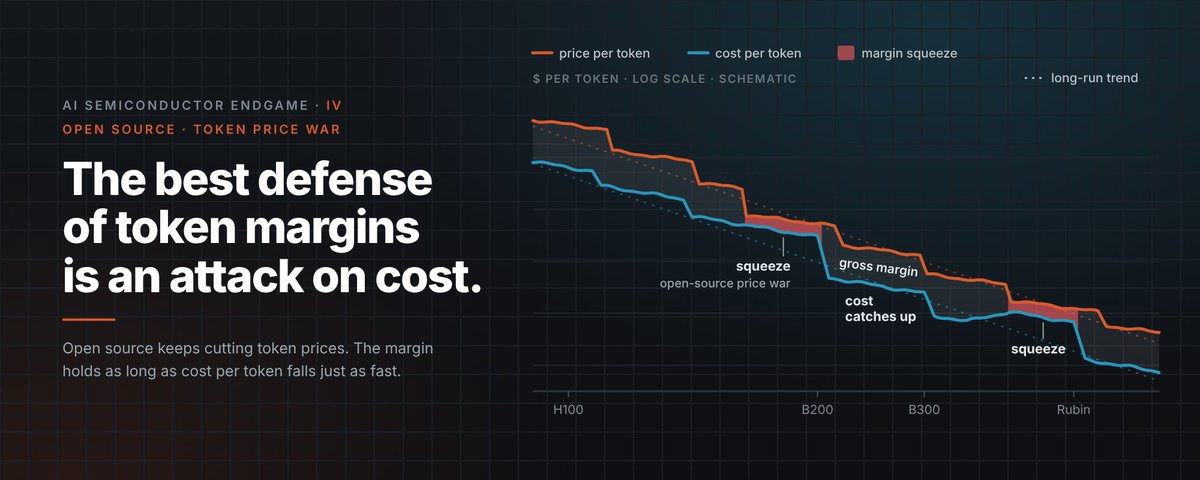
二、token经济学的动态平衡:成本降得和价格同样快
token一直在降价,这是事实。但成本降得同样快,这也是事实。
毛利在维持,成本在下降,售价在下降,用量在上升
这是全文最核心的判断:每一代模型、每一代硬件迭代之后,都会回到一个新的平衡。我们可以叫做token经济学的动态平衡。
我们不能以静态的眼光看问题,token的指数型通缩,是AI时代的动态背景板
还是那句话,AI时代的token优化进步十年加速六个数量级,软件/算法加速三个数量级,硬件加速三个数量级
老黄在2023年就讲过,硬件和软件,每十年加速一百万倍,靠的是互联、内存、封装、PCB、架构、制造的全方位进步,合起来一百万倍
相当于软件,硬件各自每十年加速1000倍
这条定律在过去十年得到了应验:硬件过去十年进步的1000倍,细细分解一下,半导体工艺大概有3倍提升,类似DP4/HMMA/IMMA这样的复杂指令加速了大概10倍,从数据精度类型方面的优化是8~16倍(FP32 -> BF4, MX4),以及sparsity方面的优化都有帮助
到现在看硬件提升速度仍然在维持:HBM的带宽和size升级换代在加速,Advanced Packaging各种3D架构花样翻新,光互联的带宽指数提升,延迟和功耗下降,功耗标准以及散热技术的快速提升,都在配合维持这个历史的背景板
落到具体:
1. 硬件每一代都让token throughput翻倍,Blackwell对H100甚至是4倍,也就是让token的单价降一半,Vera Rubin最近也开始了测试,从GTC到hotchip上的展示来看,token throughput基本上也是能翻倍的
2. 软件对同一代模型,每年甚至每半年,再让价格降一半甚至3/4,KV cache压缩、模型层的各种优化都在持续进步。
token本身也在变得更值钱,5.5这一代的token efficiency大幅提高,同样的任务消耗的token更少,而单个token的质量还在变好
只要有竞争,大家都会拼命在相同效果下降低成本,所以边际毛利主要靠软硬件的持续优化来维持
即便是开源模型,毛利也能保持在非常可观的程度
--------------------------
单GW unit economy的硬件账本
把这件事落到一个GW上算,会更直观。市场可能低估了目前token 的整体毛利。
最新B300跑前沿旗舰模型,推理效率非常高,1GW一年能卖出80B以上的token revenue。到了Vera Rubin,单位电力的token throughput至少还能再提升50%到100%,每GW能卖到120B甚至更高。每GW的毛利率还会继续上升。
当然,明年实际未必真卖到这么高,两家之间仍有竞争,旗舰token可能还是维持在80B一个GW左右。即便如此,旗舰token推理的毛利率维持在75%甚至80%以上。Anthropic今年推理收入预期可以达到50B/GW,明年甚至blended都可能提高到80B/GW。在这样的毛利下,抢算力是没有什么顾忌的
开源的token 毛利没有那么高,按官方售价来算。大概只有60%到70%,每GW的年化收入仍然能在50B以上
最近开源模型因为Sol 6.1以及 Opus 5.5的斩杀线太过于强势,降价很明显,有巨大的毛利压力。但我认为开源模型毛利承压的窘境是暂时的,比如DeepSeek最近优化了Flash 4.1之后,毛利重新站上了70%
再看成本端,现在的硬件成本摊到6年,每年才8B/GW左右。收入是硬件摊销的十倍,这就是为什么neocloud的短约最近能租到每年40~50B/GW的天价,因为token真的能卖到更高价格
硬件就算再提价,也不容易打破这个平衡,token收入和硬件成本之间这块巨大的空间,就是下一篇AI infra/半导体内战要分的蛋糕
这个动态平衡从2023年就一直存在
GPT-4的价格每年降10倍,两年降了100倍,新一代旗舰凭卓越的性能维持定价权,token ~50/M,旧一代开始大降价
如果说token通缩,通缩一直都在,但这个游戏反而更健康了:单位token带来的生产力和价值一直在提高,ROI一直在变好,帮助了渗透率和用量
移动互联网时代的手机芯片,也是这样走过来的
所以要把token降价当作常态,当作一块移动的背景板,即便token降价、减半,通过降本仍然能很大程度的维持平衡。而降价又带来了更多用量,增加整体营收
对AI infra来说,这个平衡最大的好处是维持住了毛利率,而毛利率是维持大家对硬件热情最重要的因素
--------------------------
三、value tier token是commodity,但premium tier token不是,这是两个完全不同的赛道
动态平衡回答了“降价会不会打穿毛利”。但开源会不会影响闭源最赚钱的那部分旗舰token收入?
我认为不会,因为value tier和premium tier,是两条完全不同的赛道。
value tier就是commodity,大家拼命地卷。只要有一家设定了新的“斩杀线”,其他家都得跟进。官方售价表面上可能没变,但OpenRouter上各家host的价格是实时反映的。任何value tier的东西,商品也好,甚至是人,都很容易成为commodity。
premium tier是另一回事。它的竞争只存在于OpenAI和Anthropic两家之间,所以commodity属性有限。开源影响不到premium tier token售价,这部分价格是相对稳定的
这个格局,在移动互联网的历史上出现过一次
高通做出了世界上最好的手机芯片之一。但技术扩散是拦不住的,联发科以及整个东亚(包括中国)的产业链,很快就做出了类似的芯片,售价只有高通的四分之一,甚至更低。(跟现在的蒸馏是很相像的:大概能解释30~50%为什么开源模型拉不开差距的原因)
高通的防守是,premium芯片继续卖高价,作为安卓旗舰。同时把premium芯片阉割一部分:屏蔽掉几个核、降频、降档。用极低的成本打造中端和value tier的芯片,卖得比联发科还便宜。很多代里,高通的value tier比联发科的旗舰性能更好、价格更低。
把这个故事换成今天的AI时代背景,几乎可以一一对应。开源用低得多的成本蒸馏,造出了一档和旗舰有可见差距的value tier,想从低价围剿。而OpenAI和Anthropic做的事情,和当年的高通一模一样:用自家premium模型自蒸馏,打造出价格更低、性能更好的“斩杀线”,把战场隔离在value tier,不让它蔓延到premium tier
所以premium tier的战争只在两家之间,Astra依然能卖到每百万token 50美元的高价。闭源的value tier还有第二重作用:不让开源占据更大的市场,也不让开源积累太多利润,利润越少,开源算力上追赶起来就越吃力。
最近GPT-6.1 Sol、Sonnet 5.5这一轮“斩杀线”,对开源的压力是巨大的。但这只是回合制游戏的一部分:开源也在进步,下一代仍在训练。token的指数型通缩作为背景板一直在发生,开源的到来,只是让今年value tier的降价斜率更陡了一些。另外虽然开源最近蒸馏变得更困难了,但我仍然认为开源有能力把差距维持在半年左右。
premium tier token最近也有价格战。两家都要上市,可能暂时让出一部分premium token的毛利,让ARR更好看,拿到下一笔融资,或者顺利上市。但以后可能不会有恶性价格战,这是双寡头竞争
为什么premium不会被commodity化?
供给侧的原因是:大模型时代虽然没有网络效应,但RSI效应很强:用前一代模型的数据去生成更强的下一代,这个能力越来越强。领先者的优势,会自我强化。
需求侧的原因放在后面讲:对旗舰的需求不会停。
所以,“开源威胁闭源收入”这句话只对了一半。它威胁的是闭源的value tier,而闭源的防守非常有效。两个市场之间是割裂的,不能一概而论
--------------------------
四、开源到底对半导体整体有多大分量
说完了动态平衡(开源模型毛利也是能维持的),还剩一个最朴素的问题:开源到底有多大?
开源的token占比可能已经到了20%甚至更高,但如果看ARR,也就是真实的market spend,它只占5%~10%。而ARR直接挂钩毛利率,以及能撑起多少GW的算力,这就是对半导体分量的估算。
换句话说,从算力的角度看,开源token ARR占相关ai infra/semi收入的比例只有5~10%;如果把Meta、Google这类自用的算进来,比例还要更小。上一篇讲过:北美的开源模型收入到现在还不到10B,闭源加起来已经超过120B,现在可能在140B附近。可预见的未来,开源的ARR增速会比闭源快,但不会大幅超出。
现在可以回到开头的两种担忧了。
第一种,开源把premium token的价格拉下来,不完全成立。两条赛道是割裂的,开源打不到premium的价格,ARR的大头在premium/high tier这里,当然了,Opus/Sol这样的high tier可能会在开源模型每次迭代发布的初期受一定影响
第二种,开源自己的毛利太低,拖累整个模型层的买卡能力:目前不成立。开源跑在B300上的毛利仍在60%到70%以上,份额也小。开源自己的营收约束也还没有触发:营收不好,就没法长期训练,迭代循环就难以维持;但现在开源的增长势头强劲,这个循环在正常地转。
所以结论是:开源不会降低毛利率。只有毛利率有保证,购买意愿才有保证。即便是毛利率受影响,只要开源能维持30%以上、闭源60%以上的毛利,这个游戏就完全能玩得下去,半导体和infra的需求就不会因为开源变强而变弱
在对毛利率影响有限的前提下,对Nvidia来说,开源带来了客户的多样性,致力于把供应链隔壁层的客户商品化,会给Nvidia/infra带来更大的议价权,反而是有利于AI infra/semi的
以后开源收入占绝大多数市占率的说法,我认为不太可能,原因在上一篇提到过, 主要是开源模型的算力增长速度有限,以及闭源模型的value tier token 竞争力完全不差。
--------------------------
五、平衡的前提:用量必须跑赢降价
到这里,动态平衡看起来很稳。但它其实建立在一个重要前提之上。
现在token的毛利率高,很大程度建立在算力短缺的基础上。那么,算力会一直短缺吗?
毛利率能不能维持,最终要看token需求能涨到什么量级,也就是整个ARR能不能维持增速
杰文斯悖论OpenRouter上已经无数次上演过:价格下降,需求涨得更多,整体营收反而上涨。虽然,从最近的数据看,价格降得太快,需求增速短期跟不上,整体营收的增速可能会放缓
有研究用OpenRouter和Azure的数据估算过,token的短期价格弹性大约是1~1.1,也就是便宜10%,用量多10%左右,总花费基本不变
所以绕了一圈,开源对半导体的影响,最终要回到:token需求能不能一直跑赢降价?
--------------------------
六、token需求还会大幅增长,而且对旗舰的需求不会被value tier轻易取代
理由有几个:
1. Token整体用量高度集中在头部用户,他们能吃下每一分能力提升
2. “能力超过大多数人的需要之后,再提升就对没用”,是错觉
3. 开放型任务遍布每个领域,在这些任务上旗舰模型的效果明显更好
4. 能力的本质是抽象层上移,能指挥的任务越来越复杂
5. 信息、认知、意图三种门槛降低的组合,会不断打开比上一阶段大一个数量级的新市场
--------------------------
1. 模型能力提升主要服务头部用户,模型能力提升能持续转变成用量的释放
top 10%的用户占了大部分用量,top 1%的平均用量大约是top 10%档用户的10倍、中位数用户的100倍,最能把模型能力发挥出来的,往往就是这top 1%
模型能力的提升,主要提升的是前10% power user组织long-horizon task的能力,这部分人的用量会被能力上限卡住,他们的用量会随着能力的上升而继续释放
medium人群对AI能力的需求没那么大,他们的cap限制主要是tool integration,日常的workflow没有被很好地连接起来
所以token增长其实对应两类人可能是不同的方向:头部靠能力,也就是long-horizon task;腰部靠集成,也就是连接器、workflow、personal agent
对腰部人群来说,产品的表现形式更为重要,应用层更有效用的可能是腰部人群
2. “能力超过大多数人的需要之后,再提升就对营收没用”,可能是错觉
第一,即便是普通用户,即便智能溢出,也希望用更聪明的模型,就和智能手机算力溢出一样。
第二,在人占主要成本的任务里,用旗舰可能反而更省钱。模型的花销远不如人工工资的时候,当人力占到总成本的90%,模型越强,人需要的review和返工就越少,节约的人类时间就越多,总的opex反而更低。
还有一条轴,是任务本身的开放性
3. 开放型任务遍布每个领域,在这些任务上旗舰模型的效果好得多
bounded任务有天花板,比如报税,复杂度有上限,模型一旦越过这条线,再多的智能也不再带来价值。
unbounded任务没有天花板,比如AI研究,永远可以做的更多
第一,即便是报税这种复杂度有上限的任务,可靠度也是一个因素,智能越高,可靠度越高,bounded任务的天花板是复杂度,不是可靠度
出错的代价越高,可靠度的每一点提升就越值钱
可靠度是按步数连乘的,单步做到99%,20布可靠度就升到82%左右,单步可靠度的小幅提升,会放大成任务层面的大幅提升,也意味着更少的人工review和返工
人工review和返工占大头的时候,总成本最低的可能是更强的模型
第二,unbounded是任务的属性,不是领域的属性,只要任务的开放性足够强,就是unbounded task
对抗类task天然就是unbounded,开放型任务每个领域都有,不是只有AI研发、软件工程、交易这几类领域
bounded任务的总量增长没那么大,unbounded任务是开启一块新任务之后,还能一直开辟更多的新任务,是纯增量
更强的模型在这里效果好得多,ROI更高,这也是Astra出来之后营收增速奇快的原因
第三,能力还决定了单个任务能持续多久:半年多前,一个任务迭代两三次就没法继续了,现在已经可以迭代十几次仍然继续,能力变强,迭代步数变多,抽象层就一直在往上升
第四,以后agent-to-agent的碰撞会越来越多,旗舰模型会一直处于优势,在对抗场景里,价值取决于相对能力而不是绝对能力,所以模型不存在“够用”
4. 能力的本质是抽象层上移,能指挥的任务越来越复杂
模型能力的增强,说到底是抽象能力的增强,能指挥的任务复杂度变高,对旗舰模型的要求和token消耗也就随之变大
模型对复杂度的控制能力其实是有限的,必须从抽象层、方法论的角度去隔离复杂度,本质上是用有限的复杂度控制能力,换取更大的复杂任务完成能力
技术进化的本质是抽象层上移,人类放弃低维的手工算术,是为了跃升到高维的抽象调度
Agent抽象层继续上移之后,TAM的分母也在变
上一篇算的是人均,长期看每人每月的AI支出可能到白领工资的10%,大概1000美元,这是增效的逻辑,分母是opex
Agent抽象层继续上移之后,以后的分母可能不是“每个人的人均agent”,而是“每个组织的agent数量”,agent和人头/工资上脱钩,数量甚至可能远超碳基人口,这和unbounded任务其实是同一件事
5. 信息、认知、意图三种门槛降低的组合,会不断打开比上一阶段大一个数量级的新市场
把token的演进拉长来看,目前可以分成三个阶段。
第一个阶段是chatbot,让信息流动的门槛大幅下降
第二个阶段是reasoning,让认知流动门槛大幅下降
第三个阶段是agent,让意图流动的门槛大幅降低
每一个阶段打开的应用场景,都比上一个阶段大一个数量级,而且它们之间的组合会越来越多:意图门槛和认知门槛降低的组合,会带来更大的增长空间。
历史上,每一次信息门槛的大幅降低,都带来了一轮科技革命。意图门槛的降低也带来过革命,这一次,是人类第一次在认知和智力的意图上实现门槛的大幅降低,同时信息门槛还在继续大幅改进。它一定会是一场增长非常迅猛的科技革命。
互联网时代的生意,底层逻辑可以归纳为一种组合:信息流动门槛的降低,乘以任意一个行业。社交网络是信息流动门槛的降低乘以人际关系,电商是信息流动门槛的降低乘以交易。AI时代的组合,是信息、认知、意图三种流动门槛的降低,再乘以任意一个行业。
这个组合的发展方向,可能是第四个阶段:代理经济(Proxy Economy)。无论是碳基消费还是硅基消费,无论C端还是B端,它的潜力都非常大
模型能力越强,proxy能越过的门槛就越多,能干的事情复杂度就越高。代理经济现在还没有迈过一个很大的门槛,以后会和社交、电商等每一个领域深度结合,走向agent to agent。这可能还需要一到两个阶跃。它不是一个短期的事情,可能是在更长的时间尺度上,保障token很长一段时间的指数增长。
-----------------
还有token之外的需求
最后,算力上还有一块容易被忽略的需求:训练。
推理越赚钱,能撑起的训练比例就越高。以Anthropic为例,2027年大约有10GW的算力,按年底300B的ARR来算,只需要4GW左右的推理算力就足够,剩下的6GW可以更多地投进训练;今年上半年最缺算力的时候,推理可能占到三分之二,明年可能只占40%。RSI的涌现,让训练的回报越来越能justify。
还有一类训练,根本不靠token收入来算账。Meta没有直接的token收入,但可以从muse衍生品上间接赚回来。Google的模型和自身生态结合,能产生token之外的大量收入。即便只做到第二梯队,也不可能割舍训练,而且要追上最新进度,训练算力的差距不能被拉得太大。
所以AI infra的需求,不只是token的需求,明年开始也是训练的需求。
七.一个推演,Token spending的增长可能是阶跃式的,指望它匀速增长是不切实际的,增速放缓期可能是正常现象
“coding之后没有接力所以AI增速以后完蛋”,是线性思维
AI的发展,特别是token需求,可能是阶跃式增长的,商业上,技术上的新范式/量变引起质变,都是阶跃式增长的契机。“coding之后没有接力”,是拿线性思维去外推一个阶跃的过程
原因在于,能力是连续进步的,token spending回报的兑现却是阶跃式的。
1. 回报决定花费。AI是一个每时每刻都要证明回报率的游戏。决定spending能不能继续翻倍的是边际回报。现有token用量有回报,不等于再翻一倍也有同样的回报。
有研究用OpenRouter和Azure的数据估算过,token的短期价格弹性大约是1,也就是便宜10%,用量多10%左右,总花费基本不变
2. 而Token spending的回报是阶跃门槛函数,过了一个门槛会出现阶跃。辅助驾驶L2做得再好,就算做到L2.99,它还是L2,驾驶位解放不了,经济上就很难产生收入阶跃,必须要成为L4自动驾驶,整个的产值和空间才会阶跃性打开。
同样,自动化节约的前30%到50%,作用很小,提升效率过了门槛才会长出新的范式。比如说对员工效率提升30%以内,通常不能降低项目成本。某类工作的投入减少约 30% 或以上,才方便把释放的人力重新投入其他项目。
Coding是第一个越过了L4全自动接管的赛道,所以我们看到了26年上半年token ARR营收的阶跃爆发式增长
回到token需求的问题,总的token spending能不能快速增长,还是取决于回报,而回报增长率大部分时候可能会没那么exciting,需要等阶跃。
另外一个猜想是, Top 1%的用户token 花销增长速度和medium 用户 token花销 的增长速度基本是一致的。长期看,可能会出现一次翻转:中位数token用量的增速重新超过头部Top 10%用户的增速
逻辑是,头部在token里的份额很大,在GDP里的份额并不大。前1%的用户,token用量是中位数的100倍,但他们产生的收入和GDP,远远不是中位数的100倍;前10%和中位数的差距,也远远到不了10倍。
头部的spending,上限是头部的营收;头部spending的增速,迟早要收敛到头部营收的增速。而中位数用户对token spending 空间还很大,完全可以超过营收速度。
--------------------
把这一篇的token经济半导体账摊开,其实很直白。旗舰token 一年能卖80B/GW,硬件成本摊到六年只有 每年8B/GW。中间差十倍。
开源也好,斩杀线也好,Token降价,只要成本跟着降,那么1GW的硬件能卖出去的token营收是不变的,毛利率也是能维持的
不过这个毛利率不是守出来的,是整条产业链拼命降本追出来的
至于Token的需求和花销,往后几年,一定还会常出现几个季度的放缓,也一定总会有人把放缓当成故事的结束。
我们习惯用均速前进去想象未来,而现实更可能是台阶式的阶跃性进步
每一级台阶上,都会有人宣布触顶了。 而台阶之所以是台阶,就是因为它上面还有下一级
--------------------
这一篇已经太长了,至于AI infra/semi内战的蛋糕怎么分,延续到下一篇详述。


AI半导体终局推演2026(III)
AI半导体基建期为什么比互联网基建期更长?
Coding场景之后的下一个模型ARR营收增长点在哪里?
AI基建会不会过度建设?Capex是不是泡沫?经济账能算的过来吗?
开源模型和闭源的格局如何?对闭源模型的冲击会如何演进?
本文尝试推演这几个问题背后的逻辑
—--------------------------------
为什么AI的基建期比互联网基建期要长?
互联网革命时期的硬件/基建收入增长,只有一个渗透维度的指数型增长,就是用户量
因为每个人都是订阅制,50块钱一个月的网费,没办法再升了。属于平价服务,看十倍网页也不会付十倍的钱,平价服务是没有第二个维度的指数增长的,饱和了就饱和了
移动互联网的基建,也就是端侧设备智能手机,是同样的逻辑,端侧设备很难做到ASP售价很高,因为摊薄成本需要大规模生产,而要做到大规模,ASP就一定不能高,也很难涨价。所以注定了端侧设备在渗透率达到一定程度之后,很难再继续指数增长,因为上限只有一个维度决定。
这也是为什么,互联网革命的硬件需求拐点大概在渗透率到了sigmoid中点之后减缓,2000年3月互联网泡沫破灭的时候,美国互联网渗透率大概在50%左右。科技革命增速最快的时候就是采用率10%迈向50%的阶段。
—--------
而AI硬件需求来源于token的指数型增长,这一轮AI之所以对硬件需求大,本质上是因为上限是由两个维度决定的:用户数量/渗透率的指数增长,和每个人的用量的指数增长
这两个维度的指数增长相乘,都能转换成统一的度量衡:token,把基建上限提高了太多太多了
我们这个时代,两个维度各自走到哪里了?
第一个维度用户渗透率,几个月前已经达到50%,也就是sigmoid导数要拐点了
第二个维度,也就是人均token用量,2026年仍然在早期。全美企业内部的AI spending中位数,现在是每人每月12美元。远期来看,这个数字有希望至少达到白领工资的10%,也就是每个月1000美元左右,中间还有接近两个数量级。
现在的增长,主要是第二个维度的渗透率,也就是每个人token平均用量的指数级增长,两个sigmoid曲线接力上了
这应该是历史上罕见的,两个维度sigmoid曲线接力带来的算力/基建需求,也带来了半导体的超级周期
但一切的指数增长,都是上限达到之前的幻象,这一轮AI基建也不例外,只不过幻象时间要长的多,因为多了一个维度的指数型增长接力
—--------------------------------
另外一个AI的基建期比互联网需求高的原因,在去年写的半导体年终总结里提过:提到这两个渗透维度的指数成长,都能转换成统一的度量衡:token。跟互联网时代不同的是,互联网时代,每次请求的网络和算力成本,边际成本极低,scaling的效果极好,软件复制分发的边际成本几乎为零,且几乎不消耗额外的硬件资源。
而token时代因为高额的推理成本,用户访问消耗的边际成本比互联网要高一个数量级。商业模型从“流量 × 转化率”部分转向“每 token 毛利”了,所以AI时期基建的需求比互联网时代要高的多
—--------------------------------
第一个渗透率维度扩散太快,已经到拐点,所以现在大家在讨论AI的前景的时候,已经不那么注重渗透率的讨论,而更多的是讨论在各行各业中,人均的token使用量会如何增长。
-----
Coding agent场景ARR迅速上升证明价值之后,6-7月开始增速放缓,市场开始担忧,coding agent在程序员群体内广泛渗透之后,什么场景能够接力token/ARR增长 ?是不是AI for science?还是RSI?
我认为仍然是Coding,广义的coding,而且还有很大空间
Coding是这个世界数字化的不可阻挡的趋势,万物皆可coding,而且不一定是显式的coding。实际上太多任务在后台被默默转化成了Coding,最后在记录功能的时候,仍然会被看作是Coding。
目前广义Coding任务占所有的ARR收入比例大概是60%到70%之间。如果只算程序员的狭义Coding的话可能只有40%左右,另有20~30%可能是其他行业的任务转化而来的Coding agent执行结构。
比如最常见的文件的编辑Excel和PowerPoint,最后都是通过后台开linux sandbox用Coding的方式去完成的。财务、CRM 操作、法律文档整理也一样,区别只在于所调用的工具和 verifier 不同,都被转换成了可观察->可执行->验证的coding闭环任务。
半导体的架构探索会转换成SystemC model simulation问题,生物制药的分子结构解析和仿真中的很多环节也可以用coding完成,投行研报里的模型建模也能转换为coding问题。
狭义的程序员coding任务只是第一个跑通了高频运行 观察/分析->执行->验证循环的大类任务,这也是coding为什么消耗了比chat高一个数量级的token。以后有太多的任务都是同一个逻辑下的承接者,甚至包括deep research这样的开放性任务。 形式上,下一个比较切实际的增长来源就是Co-work/computer use
接力程序员Coding的,并不是另一个孤立的大场景。当前增长最快的,正是“非程序员使用Coding基础设施完成非Coding产品任务” ,Coding仍然是默认执行内核,但不一定是用户眼中的产品分类
截至2026年6月,OpenAI企业客户中,Codex已经占Codex与ChatGPT合计输出token的64%。Codex周活用户自2月以来法律部门增长108倍,销售和招聘增长41倍,市场营销增长26倍,工程部门反而只增长5倍
从Anthropic的营收垂直占比来看,狭义的程序员/软件公司coding占比只有40%,金融服务/保险超过 20%,法律,制药/生命科学,消费/零售电商,占比都非常的可观,都有10%量级。
Software eating the world的逻辑,在coding的门槛被LLM降低一百倍之后,甚至强化成了coding eating the world,或者说,coding是agent最熟悉的方式,agent正在利用coding开始向所有知识工作去扩散使用率
而Agent Coding已经过了可行性和方向摸索阶段,剩下的主要是长时运行/跨系统/自主性/可靠性等工程问题 ,没有什么重大挑战了。
剩下的事情只是用户适应场景和改变习惯的问题,渗透率/利用率的主要瓶颈是,大家的学习曲线没有那么快,用户需要时间迁移agent/coding工作流;企业workflow高度长尾、数据分散、内部工具整合不足,也缺少自上而下的KPI推动。模型能力、组织推动和tool integration共同决定adoption速度。
另外一个瓶颈逻辑Amdahl’s law(结果取决于不能加速的环节),token只能解决其中一部分环节的加速,比如说像药物临床部分是无法加速的,如果其中一半环节无法加速,那么token就算把剩下的环节加速一千倍,整体加速也只有2倍。因此更现实的路径是并行探索更多方向,把瓶颈从决策转移到验证。
Anthropic 6~7月的营收放缓主要原因有三个:一个是算力不够,另一个是防蒸馏整治了不少账号,还有openai的codex 5.6抢占份额。并非广义agent coding需求触顶。
从广义agent coding角度看,我目前看不到大模型/agent需求的硬上限。目前仍然处于用的越多,提升效率越多的阶段,边际正收益仍然很大,主要瓶颈在于营收/利润能支撑多少budget,意愿和场景都没有问题。
--------------------------------------------
从最重要的需求端来推演,token增长率前景是没什么问题的。
那么从基建出资方来推演,capex的上限在哪里,能不能持续?有没有泡沫?举债+FCF变负,账能不能算的过来?
从基建出资方来说,和互联网区别最大的地方在于,互联网时代的基建出资方和受益方并不一致。而在 AI 时代,这两者出现了重合。基建出资方最大的Anthropic和OpenAI也同时是这一次AI革命的最大受益方。
所以算账先从Openai和Anthropic角度来算是最直接的
1.unit economy是算的过来的
截至六月底,Anthropic大概用2GW的有效算力创造了62B的ARR。如果1GW的数据中心建设成本按50B来计算,平摊到六年,每年的成本大概是10B。那么,其实Anthropic的推理算力收入~30B/GW除以年化的算力成本大概是三倍。推理的ROIC也有差不多60%
如果只算推理,那么unit economy就更好了,1GW的算力收入是接近50B的
2. 在维持这个unit economy标准的前提下,只要ARR增速和算力增速同步,Anthropic + Openai的数据中心算力GW规划是能算的过来的
O+A 两家在七月的时候大概6~7GW,Anthropic 65B,Openai 45B
O+A 两家今年年底上线加起来大概11GW,只需要ARR半年再增长60%左右即可保持ARR和上线算力的同步增长(要知道2026上半年A 7倍,O 2倍多),也就是下半年每个月增长10%即可
到2027年底,两家规划的总算力全加起来大概20~24GW,其实只需要这一年的token ARR同步增长1~1.5倍,这个算力账起码在unit economy上是算的过来的,算力跟ARR的增速同步,目前的可见度支撑2027E的capex没有大问题
没有能见度的2028只能靠猜:2028E ARR一年增长80%的话,能justify O+A 总共45GW 算力规划。2029 + 2030年两年ARR继续增长100%(CAGR仅仅40%),O + A到2030年年底总共100GW算力规划是完全合理的
至少O和A这样明确找到了结构性需求增长的赛道的ROIC是算的过来的,2027甚至2028的算力规划暂时没有泡沫
举债和FCF变负去做AI基建,是不是赌博?是的
但这样的赌博在ROIC如此好而且大概率能持续的生意面前是有合理性的,踏空错过的风险是显著大于fomo泡沫的风险。即使融资成本升到8%甚至更高,起码2027~2028,算力回报仍是可以justify借债风险的。
—------------------------
O和A的算力账是算的过来的,那么其他部分的算力呢?回报能算的过来吗?
这部分定量很难,只能大概定性的算,因为其实有很多算力是不产生直接收入,只算作研发成本。比如Meta明年规划新增5GW给MSL训模型和搜广推(搜索/广告/推荐),google的gemini 训练 + 搜广推,都不直接产生收入,但这些仍然是战略上的合理算力需求。
有一个很容易被忽略的事情:全行业来说,目前很大一部分的AI/ML算力,不是卖token的,仍然是传统的搜索/广告/推荐,最典型的比如Meta,Google大部分的算力就是如此
所以在看2027~2028年的天文数字一样的算力的时候,传统workload是一个容易被忽略的重要部分。产业链硅谷公司里,和市场的感觉是截然相反的:公司内部的算力缺的一塌糊涂,但市场还是在质疑算力账看不到收入,质疑oversupply
但把这么多不产生直接收入但仍然重要的R&D,以及传统AI/ML的大量增长算力算进来,算不过来的那部分算力是很有限的
况且O + A的算力集中度也是越来越高的:2027年全年新增算力GW,因为电力瓶颈,美国能通电大概只有20~25GW,这其中O +A可能会占10GW,也许会占到新增的接近一半。在2025年,这个比例低一些,O+A 大概只占新增算力的25%,很大一部分的算力GW不是LLM。随着时间推移,O + A的算力GW占比越来越大,也就是说总体算力账能算的过来的部分也越来越大
另外一个容易被忽略的逻辑是,因为coding agent的爆发,软件行业/ML行业的迭代速度突然加快,整个世界数字化进程的加快,带来的传统硬件基建需求也在加速
以CPU为例子
token = 决策/智能
CPU = 执行/验证
数字世界万物皆coding,随着决策能力爆发,对执行/验证的需求会是同步的数量级的增长
而且传统ML行业的迭代速度加快,也会是CPU类似的逻辑,ML的效果变好场景变多,也会带来更多GPU/ASIC硬件的需求
—------------------------
AI基建会不会产生泡沫?会,而且最后一定会overbuild
Inference现在实在是太赚钱了,所以overbuild是必然会发生的结局,因为大家都想抢inference这一块的市场,每一家都在军备竞赛,无法承受失去市场份额无法跟随潮流高速增长的痛苦,没有哪一家会退缩
闭源模型推理的毛利率可以轻松达到70%~85%(甚至是在CSP抽成之后),token factory host开源模型卖token的毛利率也有60%以上(DeepSeek甚至80%以上),GPU最近不停涨价,1GW租金都在往20B走,光卖GPU集群短约都有60%以上毛利。
这个AI基建市场太赚钱诱惑力太大,只要有渠道有技术的,全都涌入这个市场做neocloud,而因为build规划和落地普遍有一两年的时间差,所以overbuild一定会发生,只不过是时间问题
时间问题的意思是,以目前的需求和算力规划,至少两年看不到overbuild,任何模型上的阶跃式进步(比如reasoning -> agent),或者应用范式上的创新,带来AI spending维持增速,都会一直把这个overbuild的时间线往后续命
什么时候这个续命跟不上基建的速度了,overbuild就会慢慢开始浮现
但这其实是更利好于头部模型厂和应用层的,因为overbuild会导致数据中心毛利下滑,更多的推理利润都流入了头部的两家
SpaceX虽然现在规模还小,但在这个卷新建算力的市场里,执行力最强,成本最低,竞争力可能是最强的,也是野心和规划最大的,以后也必然是overbuild的最重要贡献者之一。
—-----------------------------------
开源模型的兴起,对闭源模型营收ARR会有影响吗?目前的格局是什么样的?
开源模型和闭源模型的差距会减小吗
开源模型的势头能不能持续,和开源模型的能力也有关系,我的观点是开源模型和闭源模型的差距会维持在6个月(Mythos 2月就出来了,被监管了),蒸馏主要是降本
模型进步的三个壁垒:算力scale,数据scale,自迭代
Openai和anthropic今年加起来花了一百多亿美元买数据,但国内现在也是要花几十亿美元买数据了,数据scale这个壁垒差距有缩小,但仍然是有的
算力方面,海外建数据中心 + 各个国家转口,GPU的禁令很大程度都被绕开了,等国产卡产能上来,算力壁垒也会继续缩小,目前算力数量级上的差距仍然维持
目前下一代模型的进步很大程度要依赖前一代模型的迭代(自迭代RSI),上一代模型越强,下一代就越强,差距要减小不容易
—-----------------------
至于闭源模型对开源模型ARR肯定是有影响的,但影响可能会比市场预期要小,起码一年之内冲击并不大,这里尝试一下大致定量分析
至于openrouter和Vercel上的开源模型token占比,从28%增长到62%,只能反应小微型企业/多模型用户在用中转站里的形势变化,其实绝大部分闭源token是无法显示的,这个抽样并不能完全作数
截至7月底的ARR,Anthropic大概是72~75B,Openai大概是45B
截至7月,全球所有开源收入加起来是10B左右,只算北美只有4B最多5B。按ARR收入来算,北美开源模型token factory + AWS bedrock开源 + Azure开源 ARR只有~4B,闭源120B,比例大概是3%
最大的x因素就是aws bedrock和azure,目前Q2来看,bedrock大概占aws AI的55%比例,~14B ARR,其中anthropic模型占80%左右,aws bedrock和azure开源模型加起来大概在1.5~2B ARR
中国开源3.5B分解一下,大概是智普$1B, 阿里1.2B,Deepseek 500m,kimi 300m,minimax 200m,美国分解一下,fireworks 1B,together 1.2B(开源推理只有0.5B),baseten 0.5B,加上其他地区的,加起来勉强10B
北美的token factory开源模型推理,26年上半年大概只增长了3倍(比如fireworks从10T+/300M ARR增长到40T/1B ARR),总体来说,和闭源模型的推理市场增速比较并没有显著优势
至于企业自己部署私有开源模型自己用,这条路从成本角度来说是行不通的(数据安全是另外的考虑),开源模型要是优化的不太好,成本甚至比闭源还高,不如交给token factory
美国开源的算力扩张,速度还是受限于算力,所以上不去,扩张速度和闭源比并没有优势。fireworks,baseten,together,融资都是1B规模的,按现在租算力价格,一年20B/GW,一年只能租不到0.5GW,算力增速其实不比闭源更快。要扩张只能让客户到azure/aws自带算力再来
中国的开源扩张速度倒是更快,但是同样token factory受限于算力,远远满足不了中国自己的需求,暂时无法大规模出海卖给美国。中国的token factory大大小小的差不多30家,已经卷成红海了,都是严重缺算力,谁有卡谁就能有收入
中国token出海另外一个风险是信任和政策风险问题,美国企业自己可能不敢用,中国也有可能不愿意自己模型被免费用拿不到收益,不过以后随着openrouter和vercel的中转站继续发展,即便有token无法出海的禁令,token出海也是拦不住的,毕竟开源token卖给美国的利润太高了
美国开源模型token工厂的问题在于,算力暂时有限,融资规模暂时也有限,扩张速度无法满足需求。就算是政策开放了中国开源token出海,短期算力也不够无法出去,这也是为什么Nvidia非常努力的扶持开源,甚至亲自下场加速这个进程(今天收购了hugging face)
—-----------
另外,闭源模型的防守策略也是很有力的,比如5.6 luna降价80%,价格就很有竞争力了
我们可以对比历史,这和移动互联网时代,高通对联发科使用多年的防守策略是完全一样的:
Sol相当于Snapdragon 8系:旗舰维持技术与品牌上限,数量和比例并不那么大
Luna相当于Snapdragon 4系:主动填满低价区间,不给低成本竞争者留利润池,大部分走量来自于此
和token分不同的tier一样,其实联发科的芯片是远远超出手机“够用”的范畴的,别说日常使用了,就算是打游戏的高负载场景,联发科十年前都和高通差的并不远了
所以token也是一样,value tier不会摧毁flagship tier的需求
高通和联发科的攻防战持续了15年,高通靠着这样的策略仍然维护了自己的市场占有率,高端芯片毛利率保持的也不错,仍然是安卓阵营旗舰机第一选择
所以从历史来看,开源对闭源的冲击有影响,不会影响历史进程
—-------------------
另外一个和开源相关的问题就是,tokenmaxxing潮流的结束,对ARR的增速会有影响吗?
我认为tokenmaxxing只是短期的公司为了内部推广的目的,目前部分美国硅谷大厂确实对员工日常使用有限制额度,但这个额度非常高,大概是一个月10k~20k美元,95%以上的员工实际上根本用不完,而且中位数实际上很低,仍然有很多增长空间,目前对token的使用仍然处于边际正收益仍然很大的阶段
—--------------------------------
总的来说
AI基建的前景之所以扑朔迷离,泡沫之争比互联网基建时代更激烈,主要是因为算力支出的可见度是确定的,而需求的可见度不高所以有巨大的不确定性,而中间还隔了一层收入和支出的时间错配带来的金融风险,这个基建金融风险还随着各方“加注”的不断加大,上升到了甚至能影响国债发行的程度
但我还是认为,即便是以保守的没有任何新范式的base case来算,起码到2027~2028的基建是没有泡沫的
算力就是智能,智能就是巨大的收入。
AI token需求两个指数增长维度的迅速接力节奏是历史上绝无仅有的,万物数字化广义coding的需求才刚走完第一段,开源对利润分配的冲击是必然会发生,但不会影响整个进程大局
产业链角度和市场宏观角度,看到的风险和景气度感受是相反的,但两边的感受到的剧变同样剧烈:近处的人看见的是不够,远处的人看见的是太多
算力变成了判断/认知token,需求如何推演,天花板如何计算,没有任何历史参照,我们真正在争论的,从来不是这个数字对不对,而是该用什么时间单位去看待它
而这一点本身,恰恰说明了它有多大:只有真正的相变,才会让所有旧的历史参照同时失效
支出的可见度制造了今天的恐惧,而需求的不可见度,恰恰隐藏着这个时代最大的机会,看不清路径,并不一定意味着看错了方向
每一条S型指数曲线终会走到尽头
但文明发展从来没有停在任何一条曲线的尽头
—--------------------------------------
开源对半导体的影响如何?
半导体Capex内战谁会是赢家?如果内存存储吃掉了太多利润,会发生什么?
本篇已经太长,这两个话题就顺延到下一篇


Eason 伊森 retweeted

一切都是为了健康,为自己,家人和团队负责。
早上醒来,就处理几个同事(美国、国内、香港)的要求,只简单吃了点玉米、土豆、和一个希腊酸奶,加奇异果。
中午空肚吃姜黄、通心血管,而午餐是三只鸡蛋,水果和酸奶,喝一壶柠檬热水,然后,就是要吃的CoQ-10m 、Omega 3、蔓越莓丸、肠道益生菌、维生素B群、蓝莓素和葉黃素、锌片和NAD丸,当然还有补肝的。
下午二十分钟power nap, 下午第一个会3点,让自己在脑袋最清晰的时间,看书30分钟。
昨天特意去深圳做正骨包括了推拿、针灸加艾灸,2-3小时,老中医负责,在香港几乎找不到这么优秀有经验的,消除疲劳,筋骨的舒络,激发免疫力。
中午吃五指毛桃高压锅炖的走地鸡(优质蛋白),地瓜叶(高纤维、营养丰富),带鱼(优质蛋白),一部分三种米组合的米饭,生地熟地黑豆汤 (去湿),还有凉瓜排骨 (清凉祛毒)。
下午,把会都改期,去了做脸部护理,大概两个小时,躺着听柴可夫斯基,休息够后,和两位企业家,去了打兵乓球,两个小时,其实很出汗的,自己从正拍,过渡去横拍。
晚上,简单吃了,回了部分电邮,洗澡,就尝试睡了。
其实peptide、Retinol、维他命水都很重要,男女通用。
对于动刀的医美,其实不大赞成,要是要做运动,特别是力量训练,至少要有一定的线条,倒三角。
植发是应该做的,马斯克也做了,有很大的效果。至于拉皮,有可能倒某一个年纪会尝试做,至于眼枪是可以考虑,微创去眼袋,可以考虑,其他真的要三思。
简单的护肤、搽防晒、清洁,睡眠,保湿,会把你和同龄人,甩开10年甚至以上!
一切都是为了健康,愉悦自己。
感恩,我有两个亲姐姐把我照顾的很好。
以后找机会聊护肤和穿着,大家多学习陈传多!


回答丰你的提问, 我自己在外的时间远比香港多。
一般简单的早饭,地瓜、玉米、2-3只鸡蛋,牛奶/酸奶,带一壶茶,回公司,吃一系列的营养品,姜黄、CoQ10、Omega 3、 vitamin B群组、蓝莓素、蔓越莓… 冬虫夏草粉。
如果有空每周1-3次,早上就跑步、去健身房,一个小时,然后泡按摩池,湿蒸/桑拿… 回家做面膜或三层面霜….休息半小时,约按摩正骨师傅,两小时全身推拿。
中午简餐,优质蛋白、低碳水食物…
下午,有30分钟power nap, 看研报/市场更新为主,吃1-2包果仁,和两份水果,有时吃蛋卡…
晚上,少吃,喝汤水,吃海鱼、白肉、蔬菜如地瓜叶/西兰花
晚上有应酬,尽量不喝… (不少情况盛情难却,自己酒量也不行…)
洗澡,冷热水交叉,洗脸后,用精华涂抹,vitamin 水,抹Retinol和 眼霜…
听YouTube AI进展报告… 看组合..
忙的时候,那一天到晚,黑天昏地的干活,主要是开会,见人… 而且要兼顾亚洲和美国时间… 自己公司和投资组合公司的事..
出差太多了… 没太多生活..


Eason 伊森 retweeted

美股如今的“财报交易”是一种拥挤的、内卷的,对散户难以形成正 EV 的交易类型。
用期权买方向,财报日的高 IV 瞬间坍塌会消耗大量的利润;用期货买方向,财报日上下乱插针,长期容易沦为主力的流动性。
财报,本质上无法改变一个股票的趋势。
上涨趋势中,好财报 = 继续涨,坏财报 = 回调后继续涨。
下跌趋势中,好财报 = 反弹后继续跌,坏财报 = 继续跌。
以 $SNDK 为例,前一次处于上涨趋势中,后一次处于下跌趋势中。
以个人的交易经验,反而认为“逆势”的财报是更好的交易机会。上涨趋势中的坏财报会产生好的加仓机会;下跌趋势中的好财报会产生好的做空机会。


美股赛道的“一站到底”来了!
胜到最后的冠军,瓜分“一万U”!!!
特斯拉、Meta、微软......
美股众多标的,哪个是你熟悉的?
不如跟着我们“财报大赢家”的节奏一起
来一场惊险刺激、不能后悔的一站到底!🥳
说重点,别忘了这几个关键步骤
1. 10月21之前,提交报名表
报名链接我放在最下面了哦!📒
2. 确保你的星球账号开通完毕
3. 10月15日-11月15日
需要关注这两个渠道
OKX 官方 推特 @okxchinese 和OKX 星球 的考题
发布内容时,对每家公司都要完成两个预测:
(1)财报是否超预期;
(2)财报公布当日股价是涨还是跌
这两道题是两个独立轮次,必须分别在页面规定的截止时间前提交。两题全部答对,才算通过考题。
报名后每天关注官方发题哦,记清每道题的截止时间;每家公司要答两次,少答一次也会出局!!⚠️
期待大家一站到底、一战成名!👍
报名链接 docs.google.com/forms/d/e/1F…

Every day before the market opens, I remind myself:
I don't have to trade today. My job is to say no, not yes. If a setup is good enough, it will force its way into my portfolio.
3
193

