01,INFP 程序员在东莞,AI Native 专注 AI Coding · 独立开发 · Agent ✨ 我将分享: • AI Coding 技巧与 AI 前沿资讯 • 独立开发经验与踩坑总结 • Agent 应用与实践教程 🚀 2026,从 0 开始 探索 AI 浪潮下的无限可能
Joined June 2024
- Tweets6K
- Following450
- Followers5K
- Likes13.6K


程序员Left retweeted

#X直聘 本人AI原住民 二七届的计科 最喜欢捣鼓AI相关的东西,目前在寻找AI产品经理相关的校招岗位
如果您的公司在 广州 或者 深圳,看了我的账号觉得比较符合要求的话,让我们聊聊😁

想招聘?就来用 #X直聘
在 @jackywine 和 @app_sail 的努力下,这个 hashtag 下面已经汇集了不少优质公司的招聘信息。
以后在 𝕏 上发布招聘,记得带上这个 hashtag,招聘推文可以获得更多曝光!
找工作的朋友,也可以直接点击 #X直聘,发现更多机会。
我甚至在想,能不能做一套招聘服务?
求职者在招聘推文下面回复作品集或简历,搞一个 Grok bot,每天自动收集、分析和匹配候选人,再把结果汇总给招聘团队或发帖的招聘方。
程序员Left retweeted

Anthropic 宣布新一代反蒸馏防御措施
攻击者从 Claude 平台上窃取的推理 token 量下降了 90%–99%,智谱 GLM-5.3 模型训练再次被重点点名、月之暗面 Kimi 用户请求转发蒸馏再次做实了军方信息画面来源。
Anthropic 再次明确把蒸馏定调为国家安全问题:
1. 被蒸馏出的模型接近前沿能力,但没有配备相称的安全防护(尤其是生物与网络安全领域),等于把危险能力“裸奔”式释放;
2. 窃取的能力被整合进外国军事、情报与监控系统。
攻击面的关键发现:推理链才是主要目标!
· 被动蒸馏:用正常请求的回复做训练数据;
· 主动提取:诱导 Claude 泄露其隐藏的完整思维链(chain-of-thought)。例如直接指令“逐字输出你之前的推理”,更有实验室测试了 1 万多种不同的诱导话术。
思维链的价值有硬数据支撑:在完整 Opus 4.8 推理记录上训练的模型,SWE-bench Verified 得分 80.4%;而只用摘要版推理记录训练,得分降至 71.8%。近 9 个百分点的差距证明原始推理轨迹含有大量可被“白嫖”的能力增量;这正是攻击者绕过摘要机制、直接窃取原始推理的原因。
# 防御体系:三层设计
第一层:推理摘要(reasoning summarization) Claude 在展示思考过程前先做摘要,原始推理链不直接暴露。这是早期防御,但攻击者不断找到绕过方法(如把推理翻译成另一种语言、写进特殊标签),证明单靠它不够。
第二层:保留思考(preserved thinking)本次的关键创新 随 Claude Fable 5.1 和 Opus 5.5 推出。核心机制:
· 2026 年 8 月 31 日后创建的新 API 账号无法编辑 Claude 的先前上下文;
· 模型的推理内容不能被防护更弱的早期模型读取;
· 对 Sonnet 5.5,推理记录仅对产生该记录的组织本身可见。
这直接打击了代理网络的惯用伎俩:在不同对话、不同模型、不同账号之间搬运内容,让 Claude“误以为”自己已经持有未摘要的推理,从而骗它复述出来。切断上下文编辑和跨模型读取,等于拆掉了这套骗术的基础设施。
第三层:两阶段宪法式分类器 + 账号级执法
· 分类器在蒸馏者的流量记录上训练,经内部和外部红队测试,能识别九月报告中记录的全部攻击技术,误报率低于 0.1%。目前已应用于 Sonnet 5.5、Opus 5/5.5、Fable 5/5.1,未来将覆盖所有对蒸馏者有吸引力的模型。
· 账号层面:收紧限额、大规模封号(往往在检测后两小时内完成,累计数万个)。值得注意的是,自 9 月 24 日起,Anthropic 对被安全拦截的请求恢复收费;这是刻意提高攻击成本的经济手段,只在误报率低于 0.1% 的领域执行。
# 两个再次点名的具名案例(智谱和月之暗面)
智谱(Zhipu / GLM-5.3):Anthropic 直接点名智谱在 GLM-5.3 开发过程中蒸馏了美国领先模型的网络攻击能力。一个耐人寻味的细节:智谱曾尝试蒸馏 Claude Fable 5,但发现网络 安全防护削弱了其攻击效果后,转向一个更老的 Claude 版本和另一家实验室的模型;这从侧面验证了防护确实有效,也暴露了“攻击者会流向防护最弱的模型”这一结构性问题。CAISSI(美国超级智能创新与标准促进中心)评估 GLM-5.3 为迄今网络能力最强的开放权重模型,而 Anthropic 自己的测试发现其防护“很容易被绕过”,且愿意端到端开发安全漏洞利用。
月之暗面(Moonshot / Kimi):Kimi 的用户请求被秘密转发给 Claude 作为蒸馏数据源。其中一个请求来自 Anthropic 认为与军方有关联的用户,目的是分析针对特定个人的电视台监控画面。


Over the last few months, we’ve made significant progress in reducing the effectiveness of distillation attacks against Claude.
In this post, we explain how: anthropic.com/research/disti…

程序员Left retweeted

教大家如何享受纯净舒服的推特时间线,不错过你的好友的高质量信息流。
给到 Grok Bot 的提示词大概是这样,大伙也可以玩玩。
每天晚上8点,帮我整理今天中文推特圈的精选
来源是我关注的中文账号,加上你觉得不错的中文账号。只用 X 官方 API 读帖子,跟前一天去重。
排版:
- 开头放「今日主线」,3 条短句
- 每个人单独一节,写上名字和 @,节和节之间加分隔线
- 每节 2 到 4 条要点,格式是「加粗主题:内容 + 原帖链接」,每条写两到四句,讲清楚他说了什么、关键细节和背景
- 每节最后用一句话写你的看法
- 零碎工具放到最后的「小工具」一节
- 大约 10 到 15 节,不写破折号,少用句号,不要有 AI 腔,简单清晰就好
然后我每天就可以收到这个非常有用的消息了,让我少刷推特,更加专注一点。


程序员Left retweeted

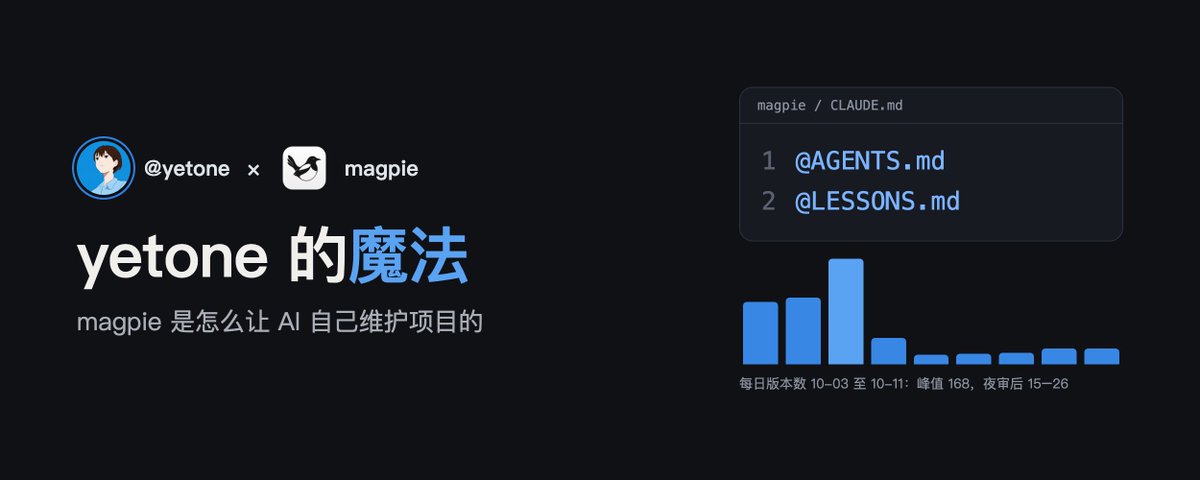
很多人想让我分享一下工作流,我一直没想好怎么分享,因为其实我没有任何的魔法,甚至还特别简陋,总觉得分享出来毫无意义。其实我就是用 Claude Code,然后用官方的 Opus 5.5 模型执行 loop 就可以了。
我会并行执行图里的 3 个 loop,然后每晚抽一点时间铲铲屎(主要是 UI/UX 的问题),然后就没活儿了。


程序员Left retweeted

Raven 0.2.0 — The Harness of Harnesses, built for RSI. 🐦⬛
One harness can't be best at everything. Raven combines its own specialist harnesses (Research, Code, Design, Oncall) with the agents you already use (Claude Code, Codex and more) into one team.
And it's built for RSI, and not just at the skill level. The whole harness can be rewritten by AI: prompts, policies, strategy code, playbooks. Every sub-harness, including the orchestration layer itself, is its own instance that can be improved.
With Raven you can:
1. Orchestrate many agents as one team. Raven's sub-harnesses and external agents work in one task graph with shared memory across sub-agents, powered by leading orchestration (0.963 Node F1 on the Multi-Agent Orchestration Benchmark).
2. Run long, complex tasks. Oncall and proactive execution keep work going for days, from scientific research loops to shipping a full Godot game.
3. Build vertical agents with RSI. Use Raven's RSI to develop and refine an agent for your domain, and we'll optimize it with you. Experimental for now; reach out to the Raven team(Discord:discord.gg/VVSm8MESch).
More in the video and slides below. Open source, Apache-2.0.
github.com/EverMind-AI/Raven (lots of work made with Raven lives there, and much of this launch's material was made with Raven too)
程序员Left retweeted

I wanted to see how far AI could take a real product video — not just generate random clips.
So I gave Pexo the product materials for Zen Slate, explained what I wanted, reviewed the direction, and refined it through conversation.
It turned that into a complete 28-sec product video with real UI, motion graphics, voiceover, subtitles and music.
What stood out to me: I didn't have to build the video piece by piece. I could just describe what needed to change and let the agent handle the production.
Made with @Pexoai_offical
pexo.ai
#MadeWithPexo
🤝 Paid partnership
程序员Left retweeted

分享一下我的 AI 订阅,希望能帮到你👍
1、主力使用的是 GPT PRO 套餐
选择它最主要的原因就是它允许其他 Agent 的使用,我前面也说了 我有多个 Agent 一起跑,而且量大管饱 还经常重置
2、DeepSeek API 订阅,按量付费
是我的一个备选 AI,当其他 AI 不能用或者出现问题的时候 我可以使用它来接管我的任务,而且新模型出来的时候 我也可以第一时间体验到
3、Grok P + 送的附赠服务
一般只处理 X 相关的内容,比如收集信息或者整理热点,最后做一些自动化汇总
4、Gemini 谷歌账号开通了 PRO
以前我开通它最多的原因,是因为它的 banana 模型非常好用,我经常拿来做生图,做一些文章的配图,现在更多的是期待它的新一代 PRO 模型
其实我还有一些其他的第三方中转站 API,比如 OpenRouter 或者是一些官方授权平台赠送的额度,这些我基本上就是不用的,但是有些模型 我也会第一时间做测试
那如果你问我 Claude 模型呢,我会告诉你,封号封了我不想开了,做测试我也是借别人的号使用🤣


分享一下我的 Agent 配置,希望对你有用👍
Hermes Agent:长时间运行的 Agent,保存持久化数据,自动迭代更新记忆,我的个人助理
Pi Agent:日常研究测试新模型的主力,干净整洁 提示词少 可以测试到模型的真正能力
Codex:日常主力开发和研究都在上面,最主要的就是对 GPT 完整生态的支持,可以在多设备之间切换和使用
Grok Bot:上面运行了Grok CLI,专门处理相关 X 的内容 帮我搜索和整理对应热点数据,分析账号缺陷
DeepSeek Harness:最近刚玩没多久,主要是想测试一下“万物皆插件”的能力到底有多强,还有就是玩一下对应的新模式对 AI 能力的提升
日常用的最多的还是 codex 和 Hermes,一个是日常工作处理,一个是 24 小时不间断地帮我整理自己相关的信息 归纳总结
Hermes Agent 机器系统还被我单独地调优过,我就是想把它打造成我的终身个人 AI 助理
Claude Code 没有上榜的主要原因是因为封号太强了 我现在全面转移到 Codex 开发了


程序员Left retweeted

懵逼了,我之前每个月 200 刀给 OpenAI,感觉完全没把 Pro 的价值发挥出来,亏麻了😅😅😅
才发现,原来 Pro 还能这么用:
1、网页端连 GitHub 提 PR
把仓库连上 ChatGPT,让 Pro 当架构师,自己开分支改 UX、提 PR,构建失败再丢给本地修。
2、Codex 桌面端左上角开 Pro 对话
Codex 左上角能直接开 Pro,它带着你当前项目的完整上下文,深度分析完,点个加号就能直接把对话记录导给 Codex 继续干活。
3、把 Pro 当 MCP 接入 Codex
如果想让它更常驻,开源社区直接做好了现成的 MCP 桥(比如 codex-chatgpt-web),选 Zero Risk 模式,既能吃到网页端 Pro 的深度推演,又规避了封号风险。
之前真是亏麻了啊!!!


程序员Left retweeted

“Step back”是我常用的一个提示词关键词,有时候看到 Agent 在原地打转没有实质性进展,我就这么提醒一下 Agent,让它重新看看目标是什么,看当前路径是不是有问题,有时候会有很好的效果。
这其实也是我开会时常用的个词,有时候开会的时候扯着扯着就跟主题无关了,喊一句“Let's step back”能把大家拉回来。


上次我说让 AI 很难跳出既定框架,有网友说是我提示词没写好,所以我最近换了一种写法,还真的有效果,简单来说就是让它基于要达到的目标,跳出框架,重新思考会有什么不一样的做法。
上次我在 AI 帮我翻译完视频后,我给它提问:
> 如果跳出当前架构,让你基于功能重新设计当前的翻译流程,你会采取什么不一样的做法?
还别说,真的给了我一些不一样的思路。
但是我看完觉得可能不太靠谱,不过口说无凭,那咱们用数据说话吧。
我让它去开个 Worktree (因为还有其他任务再跑,不好开分支)去验证下:
> 用一个worktree去验证你的方案,然后对比当前方案,看是否在不牺牲质量的前提下有更好性能。
等它验证完,发现并没有预期那么好,但是也不是完全没价值,可以部分借鉴它的方案。
有个小插曲,其实一开始我没看懂它的意思,也不知道是好还是不好,然后我去开了个 sidechat(/btw),让它给我详细的解释了一下:
> 解释一下新的方案:值得做吗?是部分改进当前还是完全改进?具体怎么改进,请通俗易懂的给我解释一下,最好结合具体的例子
听它解释完我才明白,然后把解释的内容重新给它让它基于这些信息去实施了,对于提升质量还是有帮助。
至于为什么要用 sidechat,是因为这类解释的事情没必要放到主上下文,只是了解一下,除非后续需要用到一些聊出来的信息。
---
简单总结一下:
1. 让 AI 根据目标跳出框架去思考,给出新的方案还是有帮助
2. AI 给的方案不一定靠谱,还是得要有人工验证,最好是有数据为准,不能全盘接受
3. 一些当前任务无关的问题可以问 sidechat


程序员Left retweeted

GPT-Image-2.5 实测:
中文、角色一致性、材质、草图变实物,局部修改
第一眼比较惊艳,几乎没看到噪点
不过有点偷懒
要求「只把翅膀改成透明玻璃,其他不变」
直接重新画了一只 🤣
提示词/参考图在评论区 ⬇️
#gpt #image #ai图片生成


ChatGPT Images 2.5—faster, sharper, smarter, with better tools for creating whatever you can dream of.
- Faster image generation to keep your ideas flowing
- Improved fidelity for more natural, recognizable images
- Consistent details across multiple edits
- Comment-based edits to change only what you want
程序员Left retweeted

关于「让 AI 写的 PR 更好 review」,我的 Tips 。
- 用 @dexhorthy 的 /show-me 生成更好读的 diff
- 附 mermaid 图讲架构或流程
- 附复现步骤
- 附测试日志,证明 TDD 真跑过
- 附截图或视频,证明自己验证过
- 附 design doc,包含每个决策点
- 附测试步骤,方便 reviewer 自行验证
- 重要改动自行跑一遍各 code agent 的 /review,并在 PR 里说明

What techniques do you use for making AI-authored PR's easier to review?
- I.e. use /show-me by @dexhorthy for easy-to-read diffs
- Describe the changes in pseudocode
- Mermaid diagrams
- Evidence of TDD
The wildest version of this I've heard is @dctanner's agent, who uses Playwright to record a video of the frontend feature working with text-to-speech over the top. So the agent literally talks you through its change.
程序员Left retweeted

看到乌云哥的想法,火速用 GPT-6 测试了一把金铲铲哈哈哈,不过结果还是老七出局了(第八是挂机了哈哈哈)
然后来说说我的体验:
背景是在 Windows 平台使用网易出品的 mumu 模拟器来测试的。
前期来说,他的策略还是很有效的,赢了几把,从他的思考来看是有自己的一套策略的。组合羁绊、升级思路都没问题。有问题的点有几个:
1. computer use 的速度还是不够快,他需要先截图再识别,我开的是快速模式,但是金铲铲每个回合的准备时间有限制,没法做到这么快,指令下达下去之后还有个反应的时间,往往是下一个回合已经开始了,这个动作还没有完成
2. computer use 难以做到一些复杂的操作,比如英雄上场需要拖动并摆放到具体位置,从图里看到,这些都是英雄自动上场的站位,还把输出放到了最前面。。。 再就是装备的合成与上场同样都是需要拖动的,至于场上战利品拾取虽然点击也可以,不过识别有点困难,往往是这个回合的战利品要后面两三个回合才能捡完。 至于选秀这种场景,每次都是超时出局。
3.GPT-6 的 token 消耗有点猛,我开始测试前重置了 100% 的额度,第一次我发了一句话他检查发现没有 compute-use 的权限,然后回复我这个过程,额度掉了 1%。整局结束之后,额度掉了30%。整局持续时间差不多是 30 分钟左右。
不过还有几个有趣的地方,他在游戏的过程中其实是发现了一些问题的,比如棋子的位置不对,所以中途他有一步是自己去打开设置想看看有没有相关的操作可以做。后面依旧没有,他就尝试去调节模拟工具的键盘映射,看看能否解决拖动的问题。
总的来说,进步还是很大的,速度和识别上再加强就好了,后面我再试试给他一些 adb 的能力是否会更好的完成,不过就是这个 token 消耗可能吃不消几局就没了。。


程序员Left retweeted
AI 写代码的速度上去了,但评审、审批、交接还是原来的节奏,效率提升在流程里被消耗掉了。
Anthropic 把六个阶段重新设计成一条产物链闭环:
每个阶段提交一个文件,下一个阶段读它开始;人只在门口审阅,Agent 做到生产门之前,不能越过去。

程序员Left retweeted

一个 skill,让你做出顶级审美的图表。
我开源的 Lieflat Charts 已经在 GitHub 2k star 啦~它是一套数据可视化与报告生成 skill,可供 Moxt、Claude Code、Codex 等 AI agent 使用。
它由统一的字体、留白、线条和动效建立视觉语法,有60多种图型,覆盖柱、线、面积、直方图等基础图型,还有热力图、小提琴图、环形关系图、桑基图等复杂图型,部分还支持交互。
色彩上,以黑白灰单色为基础,也支持青瓷蓝、椰林绿、编辑红三种色系,后续还会尝试更多丰富配色~
这个skill 的原理是用 html 来做图表,好处很明显,有很丰富的动效,可以无缝衔接到 html 做的 PPT 中。如果需要 PPT 格式,也可以让 agent 转成动图贴进 PPT 里。
使用非常简单,装好后把你的数据或者想要可视化的主题告诉agent,agent 会选择合适的图表类型,自动出图。如果你需要出报告,目前也有报告模式,可以一键产出数据可视化报告。
感谢 @moxt_ai 让我做出这么好看的图表!
#datavisualization #charts #skill #dataviz #html #aidesign

程序员Left retweeted

关于 AI 做代码审查,我还想补充一个很多人没注意到的坑
AI 极其容易掉入局部陷阱。很多时候我们让 AI 审代码,它一上来就默认你的框架和方案是对的,只会在你的方案里去找安全漏洞或者小修小补
但对大多数开发者(尤其是新手)来说,最关键的是审查这个方案本身选得对不对。你可能用 A 方案修修补补折腾了半天,换成 B 方案这些问题根本就不会存在
另一个烦人的点是 AI 的挤牙膏审查。你让他审一遍,改完问题再让他审,他又能挑出新问题。说明他不是一次性从底层原理出发把根源解决掉,而是在那里硬找问题、刷存在感
为了避免这两个问题,我总结了一个Prompt,评论区看看👇

程序员Left retweeted

TokenRouter注册限时免费使用GLM-5.3
我已经接入到opencode里狠狠蹬起来了👏


想了解AI大模型最新消息,关注下面这些账号就够了:
1. OpenAI 掌管重置的神 @thsottiaux
2. Anthropic 前OpenAI联合创始人 @karpathy
3. Google Gemini X宣传代言人 @OfficialLoganK
4. Grok Bot新晋宣传小能手 @poteto
5. DeepSeek 官方对外宣传口径 @deepseek_ai DeepSeek Harness之父 @tianyi
6. Z.ai 智谱Z.ai负责人 @ZixuanLi_
7. Qwen 官方对外宣传口径 @Alibaba_Qwen
8. Hy 腾讯AI首席科学家 @ShunyuYao12
程序员Left retweeted
深有同感:让 Sol 审一段代码 它总能找出几个问题。
不管这段代码有多大 也不管你已经让它审过多少轮 按它的意见改完了 再审一遍 它还能再找出几个新问题, bugs 是无限的。
大家可以试试看:新开上下文再审,第一轮修完的问题,第二轮就是有新的出来,现在 AI code review 最大的问题是,假如你不断的审下去你就会发现后面的问题其实都是硬找的问题,把风格偏好说成缺陷等等。
所以在 PR review 上我还是一直在用我的 github.com/vikingmute/review…,多 agents 审查,汇总通用问题,手动 check 要修复的问题,fix 和 verify 。